यह आवाज़ मौजूद नहीं है - जनरेटिव वॉइस AI
- प्रकाशित
सुनेंइस आर्टिकल को सुनें
हाल ही में ऐसा लग रहा है कि हर कोई जनरेटिव AI की बात कर रहा है। ChatGPT, Stable Diffusion, DALL-E और Midjourney जैसे डीप लर्निंग से चलने वाले बड़े लैंग्वेज और टेक्स्ट-टू-इमेज मॉडल्स ने टेक जगत और उसके बाहर भी काफी हलचल मचा दी है। कई लोग इन्हें AI में हाल की सबसे अहम प्रगतियों में गिनते हैं। आप इससे सहमत हों या नहीं, आम धारणा यही लगती है कि कोई बेहद शक्तिशाली चीज़ सामने आ गई है। 2023 में हम ऐसे मॉडल्स के बारे में सुनेंगे जो ड्रॉइंग बनाने या वीडियो बनाने में आपकी मदद कर सकते हैं। जैसे हम पूछते हैं कि सबसे नया और बेहतरीन स्मार्टफोन कौन-सा है, वैसे ही जल्द हम पूछेंगे कि सबसे नया और बेहतरीन फाउंडेशन मॉडल कौन-सा है। लेकिन इस सारे उत्साह के बीच, हमें लगता है कि जनरेटिव मीडिया का एक क्षेत्र अब भी बहुत कम चर्चा में है: वॉइस AI। हम इसी क्षेत्र में अग्रणी बनना चाहते हैं। ElevenLabs में, हम अपने जीवंत टेक्स्ट टू स्पीच और वॉइस क्लोनिंग टूल्स को चलाने के लिए हर दिन डीप लर्निंग तकनीकों की क्षमता का इस्तेमाल करते हैं। और अब, हम अपना जनरेटिव मॉडल भी पेश कर रहे हैं, जिससे आप बिल्कुल नई सिंथेटिक वॉइसेज़ को शुरुआत से डिज़ाइन कर सकते हैं।
वॉइस जनरेटर - एक वॉइस डिज़ाइन करें
हमारे यूज़र्स अपने किरदारों को जीवंत बनाने के लिए हर दिन प्लेटफ़ॉर्म पर आते हैं—चाहे वह ऑडियोबुक्स, गेम्स या फैन फिक्शन के लिए हो। हमें महसूस हुआ कि हमारा मौजूदा स्पीकर बैंक इतना बड़ा नहीं है कि हर किसी को अपने कंटेंट की ज़रूरत के मुताबिक वॉइस मिल सके, जो सिर्फ़ उसी यूज़र के लिए हो। हमारा समाधान था कि आप बिल्कुल नई सिंथेटिक वॉइसेज़ डिज़ाइन कर सकें।
हमने यह कैसे किया जाए, इसका विचार स्पीच सिंथेसिस और वॉइस क्लोनिंग में इस्तेमाल होने वाले मौजूदा तरीकों को समझते समय पाया। दोनों प्रक्रियाओं में किसी खास वॉइस की विशेषताओं को एन्कोड करने का तरीका चाहिए। स्पीकर एम्बेडिंग्स ही इस पहचान को संभालती हैं—ये स्पीकर की वॉइस का वेक्टर रिप्रेज़ेंटेशन होती हैं। हमें पता चला कि एक समर्पित मॉडल को ट्रेन करके हम स्पीकर एम्बेडिंग्स के डिस्ट्रीब्यूशन से सैंपल ले सकते हैं और अनगिनत नई वॉइसेज़ बना सकते हैं।
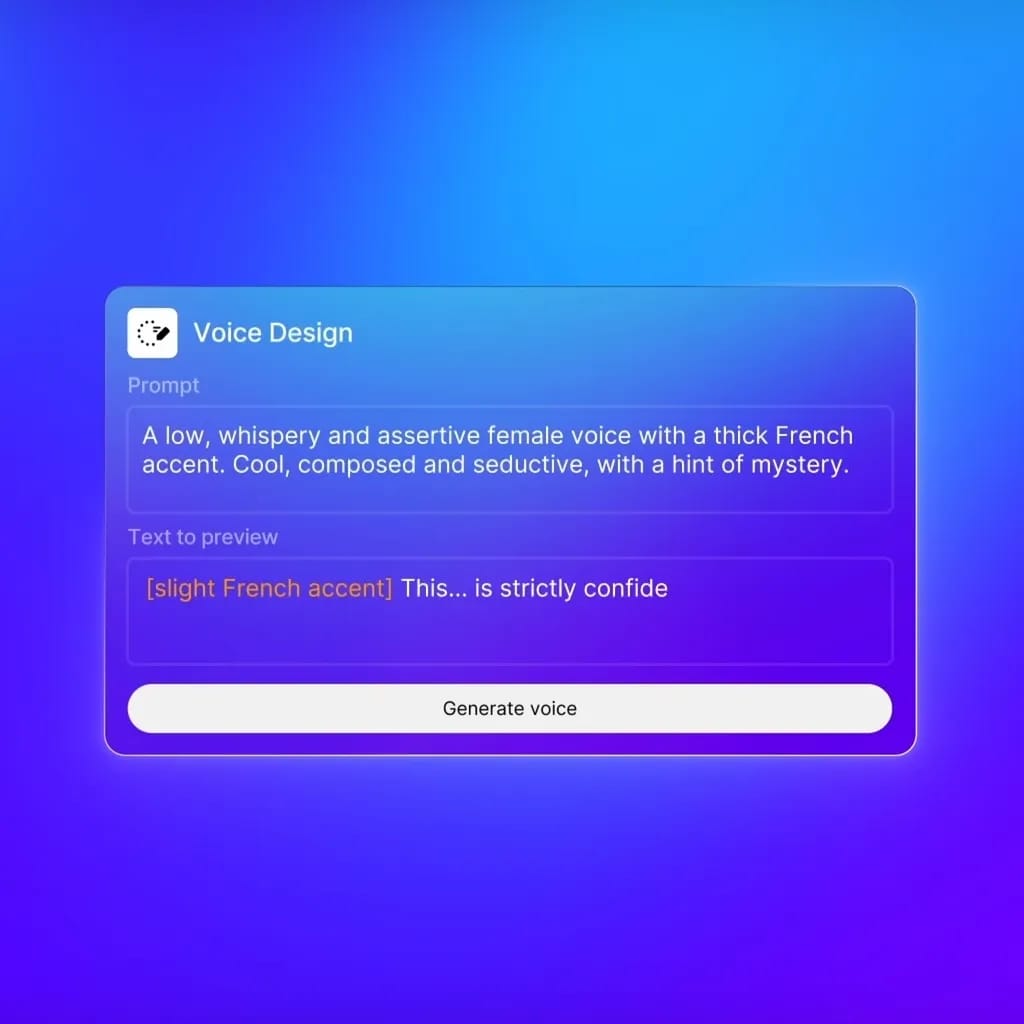
चूंकि हमारे यूज़र्स ज़्यादातर बोलने की खास विशेषताएं चाहते हैं, इसलिए हमें इस प्रक्रिया में कुछ नियंत्रण जोड़ना था। हमने विशेषताओं के आधार पर वॉइस जनरेट करने के लिए अपने मॉडल में कंडीशनिंग जोड़ी। अब मॉडल आपको कुछ बुनियादी पैरामीटर्स सेट करने देता है, जो नई वॉइस की मुख्य पहचान तय करते हैं: जेंडर, उम्र, एक्सेंट, पिच और बोलने का अंदाज़। दूसरे शब्दों में, हर बार ‘जनरेट’ दबाने पर, भले ही आप वही बेस पैरामीटर्स चुनें, आपको एक बिल्कुल नई वॉइस मिलती है, जो पहले मौजूद नहीं थी।
नीचे इस तरह डिज़ाइन की जा सकने वाली वॉइसेज़ के कुछ उदाहरण हैं:
'डिज़ाइन वॉइस' इस फरवरी में वॉइस लैब के हिस्से के रूप में हमारे प्लेटफ़ॉर्म पर उपलब्ध होगी।
इसका उपयोग क्या है?
हमारे टूल्स पहले ही इंसानों जितनी जीवंत स्पीच बना सकते हैं और हमें उम्मीद है कि कृत्रिम वॉइसेज़ के संभावित उपयोगों का दायरा बढ़ता ही जाएगा। इन नए उपयोगों में से कई, जैसे न्यूज़ पब्लिकेशंस या विज्ञापनों के लिए ऑडियो रिकॉर्ड करना, यह मांग करेंगे कि एक वॉइस किसी खास ब्रांड या उपयोग के लिए ही सीमित और पहचानी जाए, और कहीं और इस्तेमाल न हो। दूसरी ओर, कहानी कहने और वीडियो गेम्स जैसे उपयोगों में डेवलपमेंट की शुरुआत से ही लचीलापन और प्रयोग करने की आज़ादी ज़्यादा मायने रखती है। इसलिए वर्चुअल स्पीकर्स का बहुत बड़ा सेट बनाने के बजाय, हमने यूज़र्स को यह तय करने का अधिकार देने का लक्ष्य रखा कि कौन-सी वॉइसेज़ उनके काम के लिए सबसे उपयुक्त हैं।
किताब लेखकों को अब न सिर्फ़ अपने काम को आसानी से ऑडियो में बदलने का मौका मिलता है, बल्कि वे अपनी पसंद का नैरेशन डिज़ाइन करने का रचनात्मक नियंत्रण भी बनाए रखते हैं। इससे उनके पाठकों को पब्लिकेशंस के साथ जुड़ने के नए और दिलचस्प तरीके मिलते हैं, और उन किताबों की संख्या भी बहुत बढ़ती है जिन्हें हम सुनकर आनंद ले सकेंगे।
समाचार प्रकाशक लगातार ऑडियो की ओर बढ़ रहे हैं और अपने पब्लिकेशंस का प्रतिनिधित्व करने के लिए अलग पहचान वाली वॉइसेज़ चुनना एक अहम काम है—कई श्रोता विषय-वस्तु के साथ प्रस्तुति को भी महत्व देते हैं। उतना ही अहम यह है कि अब प्रकाशक सुनिश्चित कर सकते हैं कि कोई खास वॉइस सिर्फ़ उन्हीं का प्रतिनिधित्व करती है।
वीडियो गेम डेवलपर्स अब अपनी उंगलियों पर उपलब्ध सभी ज़रूरी टूल्स के साथ कई ऐसे NPCs को वॉइस दे सकते हैं, जो पहले खामोश रहते थे। क्वालिटी से समझौता किए बिना वे न सिर्फ़ लागत कम कर सकते हैं, बल्कि अपने बनाए वर्चुअल वर्ल्ड्स के लिए पूरी तरह अनोखी वॉइसेज़ भी डिज़ाइन कर सकते हैं।
विज्ञापन क्रिएटिव्स को खास कैंपेन्स के अनुरूप वॉइसओवर चाहिए होते हैं, इसलिए डेवलपमेंट की शुरुआत में प्रभावशाली और खास मकसद के लिए बना नैरेशन डिज़ाइन कर पाना एक बड़ा फायदा है। वे बिना अतिरिक्त संसाधन लगाए तुरंत कई वॉइसेज़ और डिलीवरी स्टाइल्स के साथ प्रयोग कर सकते हैं।
हर तरह का ऑडियो और वीडियो कंटेंट बनाने वाले क्रिएटर्स से लेकर कंपनी कम्युनिकेशंस को वॉइस देने वाले कॉर्पोरेट अधिकारियों तक, किसी खास उपयोग के लिए अनोखा और तैयार किया गया प्रभावशाली ऑडियो डिज़ाइन करने के अवसर अब अनगिनत हैं।
नैतिक AI
जिस तरह वॉइस क्लोनिंग के संभावित दुरुपयोग के परिणामों को लेकर चिंताएं होती हैं, उसी तरह बढ़ते हुए लोग चिंता करते हैं कि AI तकनीक के प्रसार से पेशेवरों की आजीविका खतरे में पड़ जाएगी। ElevenLabs में, हम एक ऐसे भविष्य की कल्पना करते हैं जिसमें वॉइस ऐक्टर्स शुल्क के बदले खास उपयोगों के लिए स्पीच मॉडल्स को ट्रेन करने हेतु अपनी वॉइसेज़ का लाइसेंस दे सकें। क्लाइंट्स और स्टूडियोज़ अपने प्रोजेक्ट्स में पेशेवर वॉइस टैलेंट को खुशी से शामिल करते रहेंगे, और AI का इस्तेमाल बस तेज़ डिलीवरी, प्रयोग करने की ज़्यादा आज़ादी और डेवलपमेंट की शुरुआत में दिशा तय करने में मदद करेगा। यह तकनीक बोले गए ऑडियो के डिज़ाइन और रिकॉर्डिंग का तरीका बदलेगी, लेकिन हर सेशन में वॉइस ऐक्टर्स का शारीरिक रूप से मौजूद न होना उन्हें एक समय में अधिक प्रोजेक्ट्स से जुड़ने की आज़ादी देता है और उनकी वॉइस को सचमुच अमर बना सकता है।
इसके अलावा, हम इसलिए उत्साहित हैं कि कई किताबें, समाचार, इंडिपेंडेंट गेम्स और अन्य कंटेंट, जिनके लेखक और डेवलपर्स अन्यथा रिकॉर्डिंग का खर्च नहीं उठा पाते, अब एक दूसरे माध्यम से उपलब्ध हो सकेंगे। इस बढ़ी हुई पहुंच के साथ हर मामले में ऑडियंस बढ़ाने का अवसर भी आता है।
ElevenLabs में, हम बौद्धिक संपदा अधिकारों का सम्मान करने और अपनी तकनीक के संभावित दुरुपयोग से बचाव के उपाय लागू करने, दोनों के लिए पूरी तरह प्रतिबद्ध हैं:
- हम सिर्फ़ उन क्लाइंट्स के साथ साझेदारी करते हैं जो हमारी शर्तों का पालन करते हैं। ये शर्तें हमारी तकनीक के किसी भी गैरकानूनी या हानिकारक उद्देश्य के लिए दुर्भावनापूर्ण इस्तेमाल पर रोक लगाती हैं;
- हम अपने मॉडल से जनरेट किए गए सभी ऑडियो में वॉटरमार्किंग जोड़ने पर भी काम कर रहे हैं, ताकि उन्हें तुरंत हमारे तक ट्रेस किया जा सके;
- जब हम पहचानी जा सकने वाली वॉइसेज़ इस्तेमाल करते हैं, तो सिर्फ़ डेमो के लिए और ऐसे संदर्भों में करते हैं जहां हितों का टकराव न हो;
- साथ ही, हम वॉइस मालिकों और उनके लाइसेंसधारकों को उनके अधिकारों का दावा करने में सहयोग देना चाहते हैं। सभी ज्ञात उल्लंघनों की समीक्षा करके कार्रवाई की जाएगी।
आगे की राह - अपनी वॉइस को बेहतर बनाएं
भविष्य में हम अपनी वॉइस जनरेशन और वॉइस क्लोनिंग मॉडल्स की क्षमताओं को मिलाकर यूज़र्स को अपनी वॉइसेज़ बेहतर बनाने की सुविधा देने की योजना बना रहे हैं। आप अपनी वॉइस क्लोन कर सकेंगे और फिर उसे अपनी पसंद के किसी भी प्रभाव के लिए बदल सकेंगे। अगर आपको लगता है कि आपका प्राकृतिक बोलने का अंदाज़ थोड़ा एकरस है, तो आप उसमें विविधता जोड़ सकेंगे। अगर आपको रिकॉर्ड होना सच में पसंद नहीं है, तो आप आउटपुट को ज़्यादा स्वाभाविक सुनाई देने के लिए बदल सकेंगे। जिस किसी को भी किसी उद्देश्य के लिए अपनी वॉइस वाला ऑडियो बनाना हो—चाहे वह पहले से रिकॉर्ड की गई प्रेज़ेंटेशन हो या ऑडियो मैसेज—वह एक क्लिक में हमारे टूल्स के ज़रिए ऐसा कर सकेगा।
नववर्ष की शुभकामनाएं
जैसे-जैसे 2022 समाप्त हुआ, हम अपने बीटा-यूज़र्स को उनकी निरंतर भागीदारी और फीडबैक के लिए धन्यवाद देना चाहते हैं। हम जिन कई फीचर्स को विकसित कर रहे हैं, वे आपके इनपुट और सुझावों की देन हैं। हमें आपको अपने साथ पाकर बेहद खुशी है और हम आप सभी को नववर्ष की शुभकामनाएं देते हैं।
ElevenLabs बीटा
हमारे बीटा प्लेटफ़ॉर्म पर साइन अप करने और खुद आज़माने के लिए यहां जाएं। हम लगातार सुधार कर रहे हैं और इस शुरुआती चरण में यूज़र्स की हर जानकारी हमारे लिए बहुत अहम है।