
Testen von Conversational-KI-Agenten
- Verfasst von
- Anna Neely
- Veröffentlicht
- Zuletzt aktualisiert
AnhörenArtikel anhören
Wenn dialogbasierte Sprachagenten live gehen, wie überwachen Sie sie in großem Umfang? Wie erkennen Sie, wenn sie sich nicht wie vorgesehen verhalten? Und wie testen Sie sie, nachdem Sie Änderungen vorgenommen haben?
Diese Fragen prägten unsere Arbeit an El, unserem Dokumentationsassistenten auf Basis von Conversational AI. Mit der Weiterentwicklung von El haben wir ein System zur Überwachung, Bewertung und zum Testen von Agenten entwickelt, das auf Bewertungskriterien und Gesprächssimulationen basiert.
Grundlagen schaffen: Zuverlässige Bewertungskriterien
Jeden Agenten zu verbessern beginnt damit, sein Verhalten im Einsatz zu verstehen. Dafür haben wir unsere Bewertungskriterien verfeinert und sichergestellt, dass sie präzise und zuverlässig genug sind, um die Leistung von Agenten zu überwachen. Als fehlgeschlagen gilt für uns ein Gespräch, wenn der Agent falsche Informationen liefert oder dem Nutzer nicht hilft, sein Ziel zu erreichen.
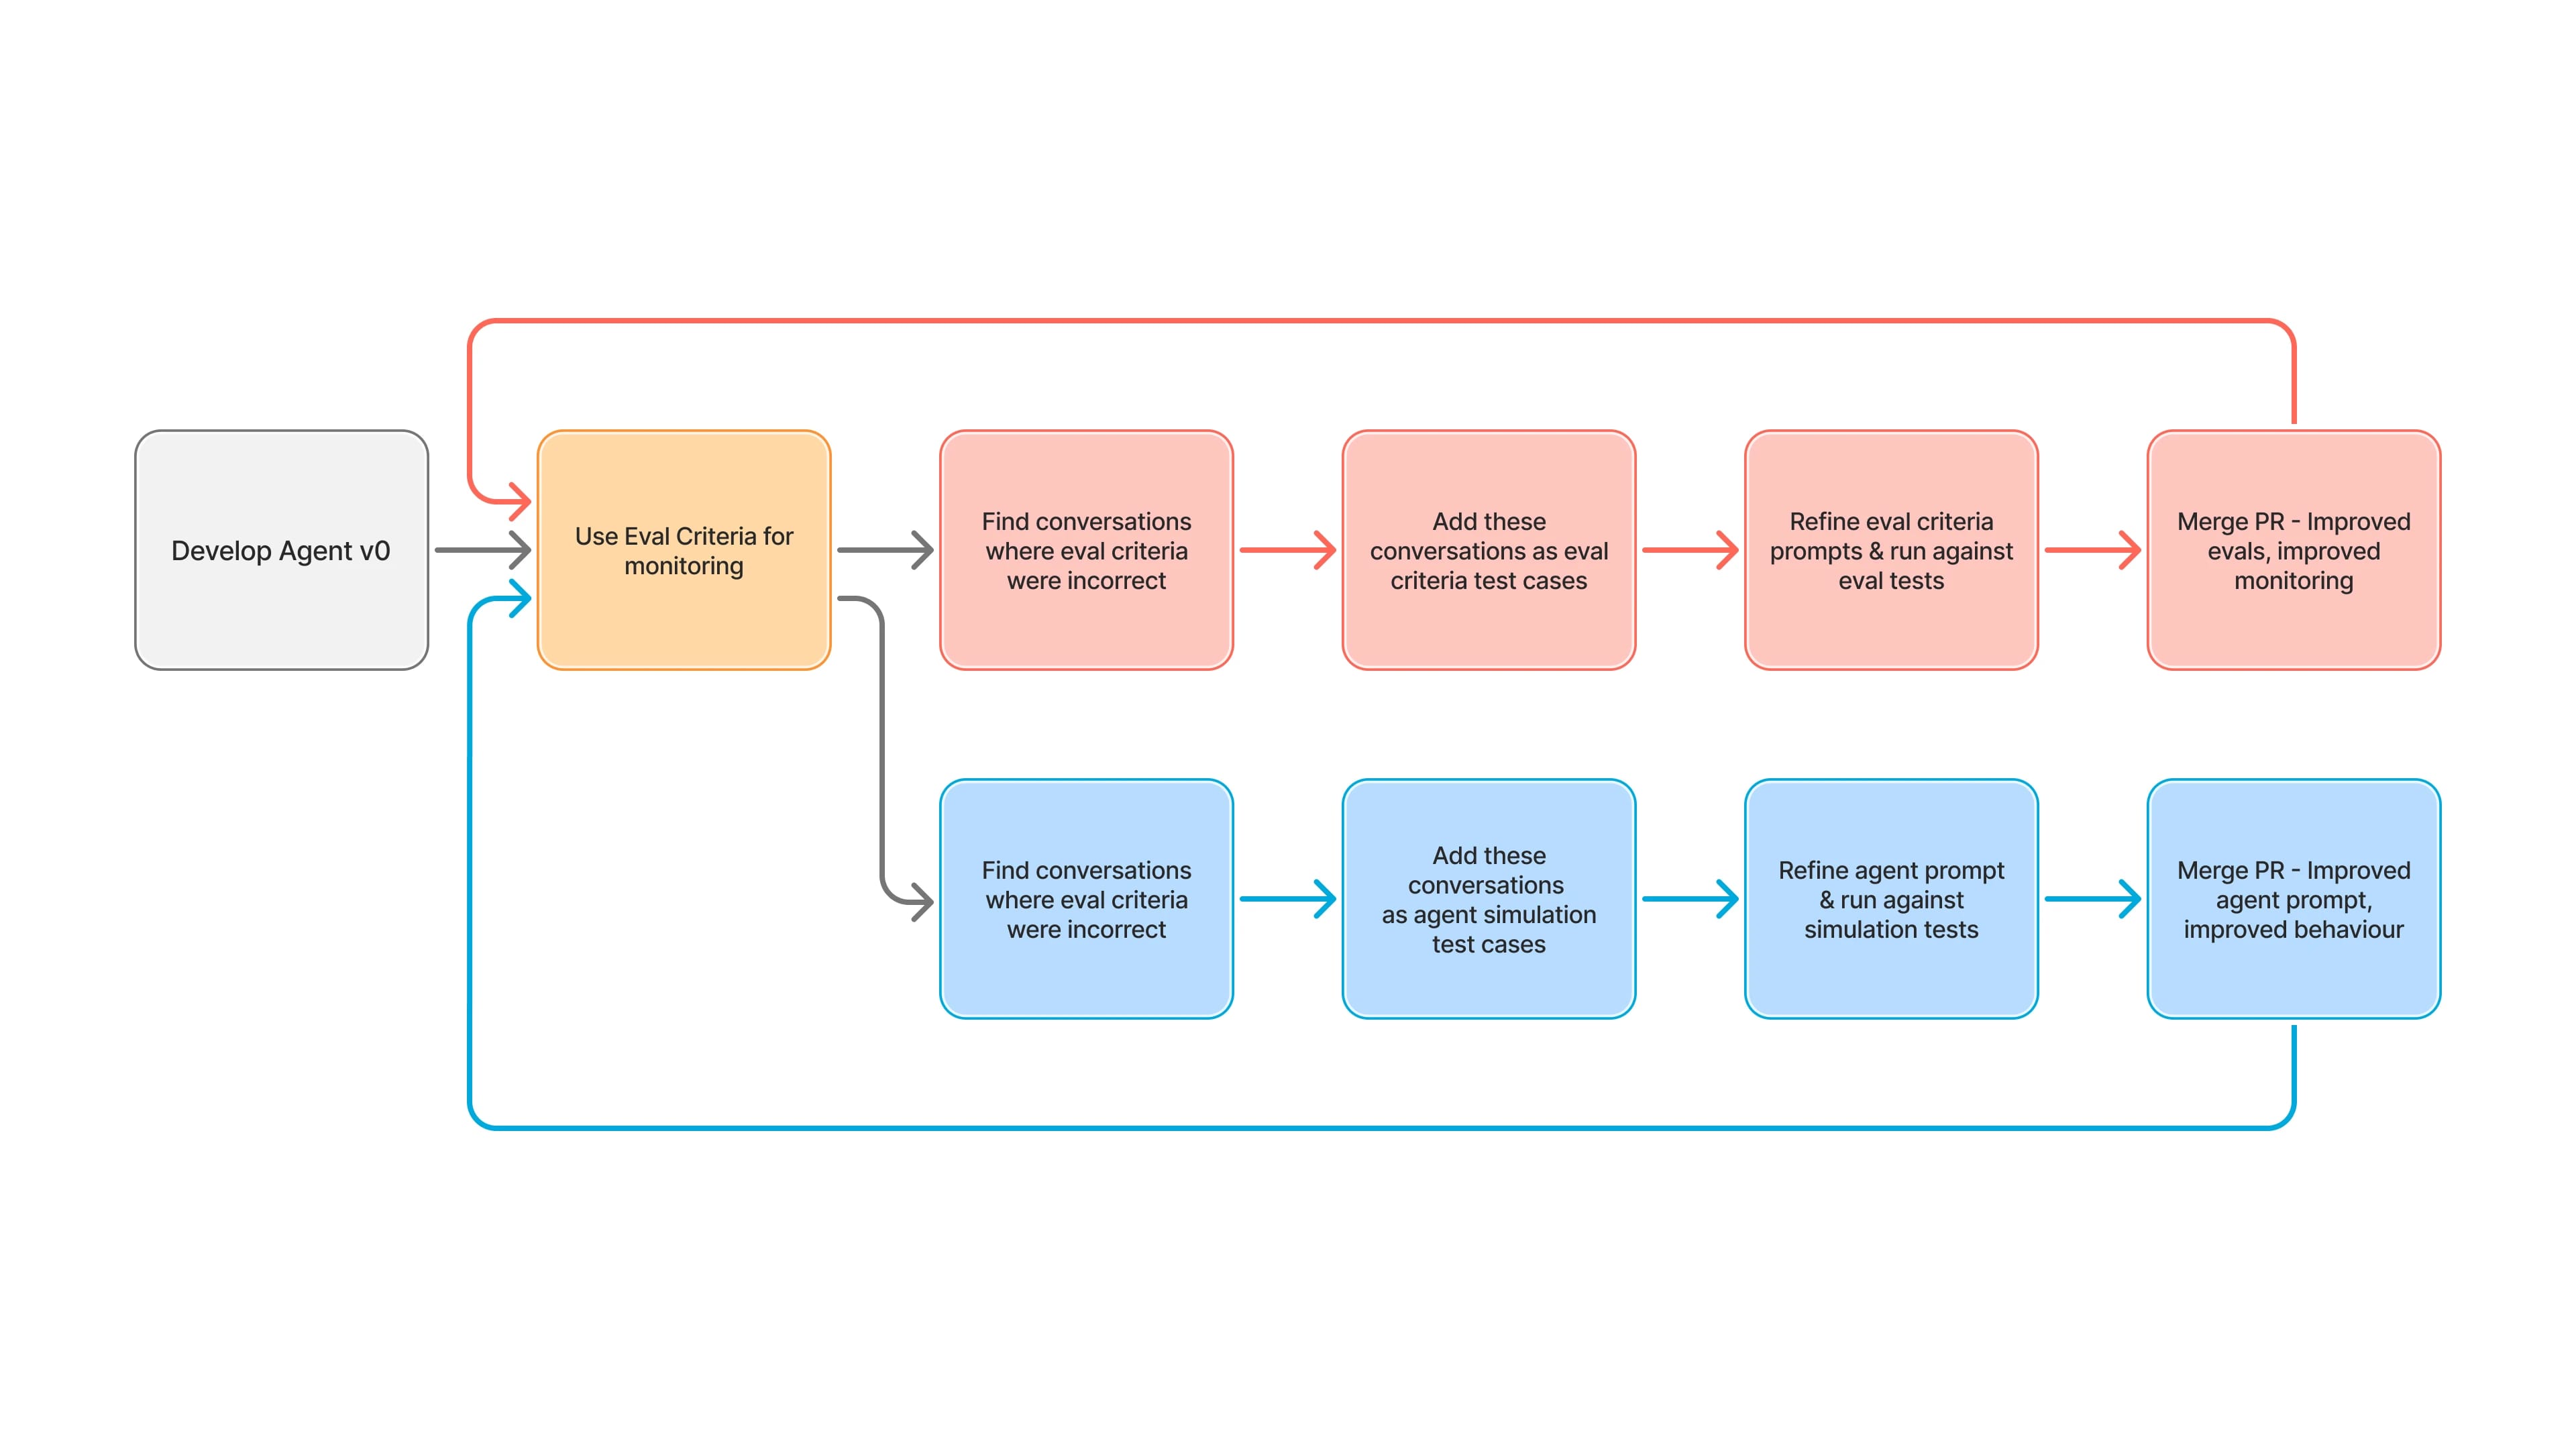
Wir haben folgende Bewertungskriterien entwickelt:
- Interaktion: Ist dies ein gültiges Gespräch? Hat der Nutzer relevante Fragen gestellt? Ergibt das Gespräch Sinn?
- Positive Interaktion: War der Nutzer anschließend zufrieden oder verwirrt beziehungsweise frustriert?
- Ursache verstehen: Hat der Agent das zugrunde liegende Problem des Nutzers korrekt erkannt?
- Nutzeranfrage lösen: Hat der Agent das Problem des Nutzers gelöst oder eine alternative Supportmöglichkeit angeboten?
- Halluzination: Hat der Agent Informationen halluziniert, die nicht in der Wissensdatenbank stehen?
Wenn Interaktion fehlschlägt, ist das Gespräch selbst nicht gültig. Wenn andere Kriterien fehlschlagen, untersuchen wir dies weiter. Die Untersuchung zeigt uns, wie wir den Agenten verbessern können. Manchmal geht es darum, die Tool-Nutzung oder das Timing zu optimieren. In anderen Fällen fügen wir Schutzmechanismen hinzu, um nicht unterstützte Aktionen zu verhindern.
Sicher iterieren: Conversation Simulation API
Sobald wir erkannt haben, was verbessert werden muss, folgt der Test. Hier kommt unsere Conversation Simulation API ins Spiel. Sie simuliert realistische Nutzerszenarien – sowohl Ende-zu-Ende als auch in gezielten Abschnitten – und bewertet die Ergebnisse automatisch anhand derselben Kriterien, die wir in der Produktion anwenden. Sie unterstützt Tool-Mocking und benutzerdefinierte Bewertungen und ist damit flexibel genug, um gezielte Verhaltensweisen zu testen.
Wir nutzen zwei Ansätze:
- Vollständige Simulationen: Testen Sie vollständige Gespräche von Anfang bis Ende.
- Partielle Simulationen: Beginnen Sie mitten im Gespräch, um Entscheidungspunkte oder Teilabläufe zu validieren. Dies ist unsere bevorzugte Methode für Unit-Tests und ermöglicht schnelle Iterationen sowie gezieltes Debugging.
Klare, fokussierte Szenarien ermöglichen es uns, zu steuern, worauf das LLM getestet wird. So stellen wir die Abdeckung von Sonderfällen, Tool-Nutzung und Fallback-Logik sicher.
Automatisierung für den масштаб: Tests in CI/CD einbetten
Der letzte Baustein ist die Automatisierung. Wir haben die offenen APIs von ElevenLabs genutzt, um unseren GitHub-DevOps-Flow zu verbinden und Bewertung sowie Simulation in unsere CI/CD-Pipeline einzubetten. Jedes Update wird vor der Bereitstellung automatisch getestet. Das verhindert Regressionen und liefert uns schnell Feedback zur Leistung unter realen Bedingungen.
Ergebnisse: Ein stärkerer, intelligenterer El
Dieser Prozess hat verändert, wie wir El entwickeln und pflegen. Wir haben eine Feedbackschleife geschaffen, die reale Nutzung mit strukturierter Bewertung, gezielten Tests und automatisierter Validierung verbindet. So können wir Verbesserungen schneller und mit größerer Sicherheit bereitstellen.
Dieses Framework können wir jetzt auf jeden Agenten anwenden, den wir entwickeln.



