
Pruebas de Agentes de Conversación IA
- Escrito por
- Anna Neely
- Publicado
- Última actualización
EscucharEscucha este artículo
Cuando los agentes de voz conversacionales entran en producción, ¿cómo los supervisas a escala? ¿Cómo detectas cuándo no se comportan según lo previsto? Y, cuando haces cambios, ¿cómo los pruebas?
Estas preguntas guiaron nuestro trabajo en El, nuestro asistente de documentación basado en IA conversacional. A medida que El evolucionaba, creamos un sistema para supervisar, evaluar y probar agentes, basado en criterios de evaluación y simulaciones de conversaciones.
Sentar las bases: criterios de evaluación fiables
Mejorar cualquier agente empieza por entender cómo se comporta en situaciones reales. Esto implicaba perfeccionar nuestros criterios de evaluación y asegurarnos de que fueran lo bastante precisos y fiables para supervisar el rendimiento del agente. Definimos una conversación fallida como aquella en la que el agente proporciona información incorrecta o no ayuda al usuario a lograr su objetivo.
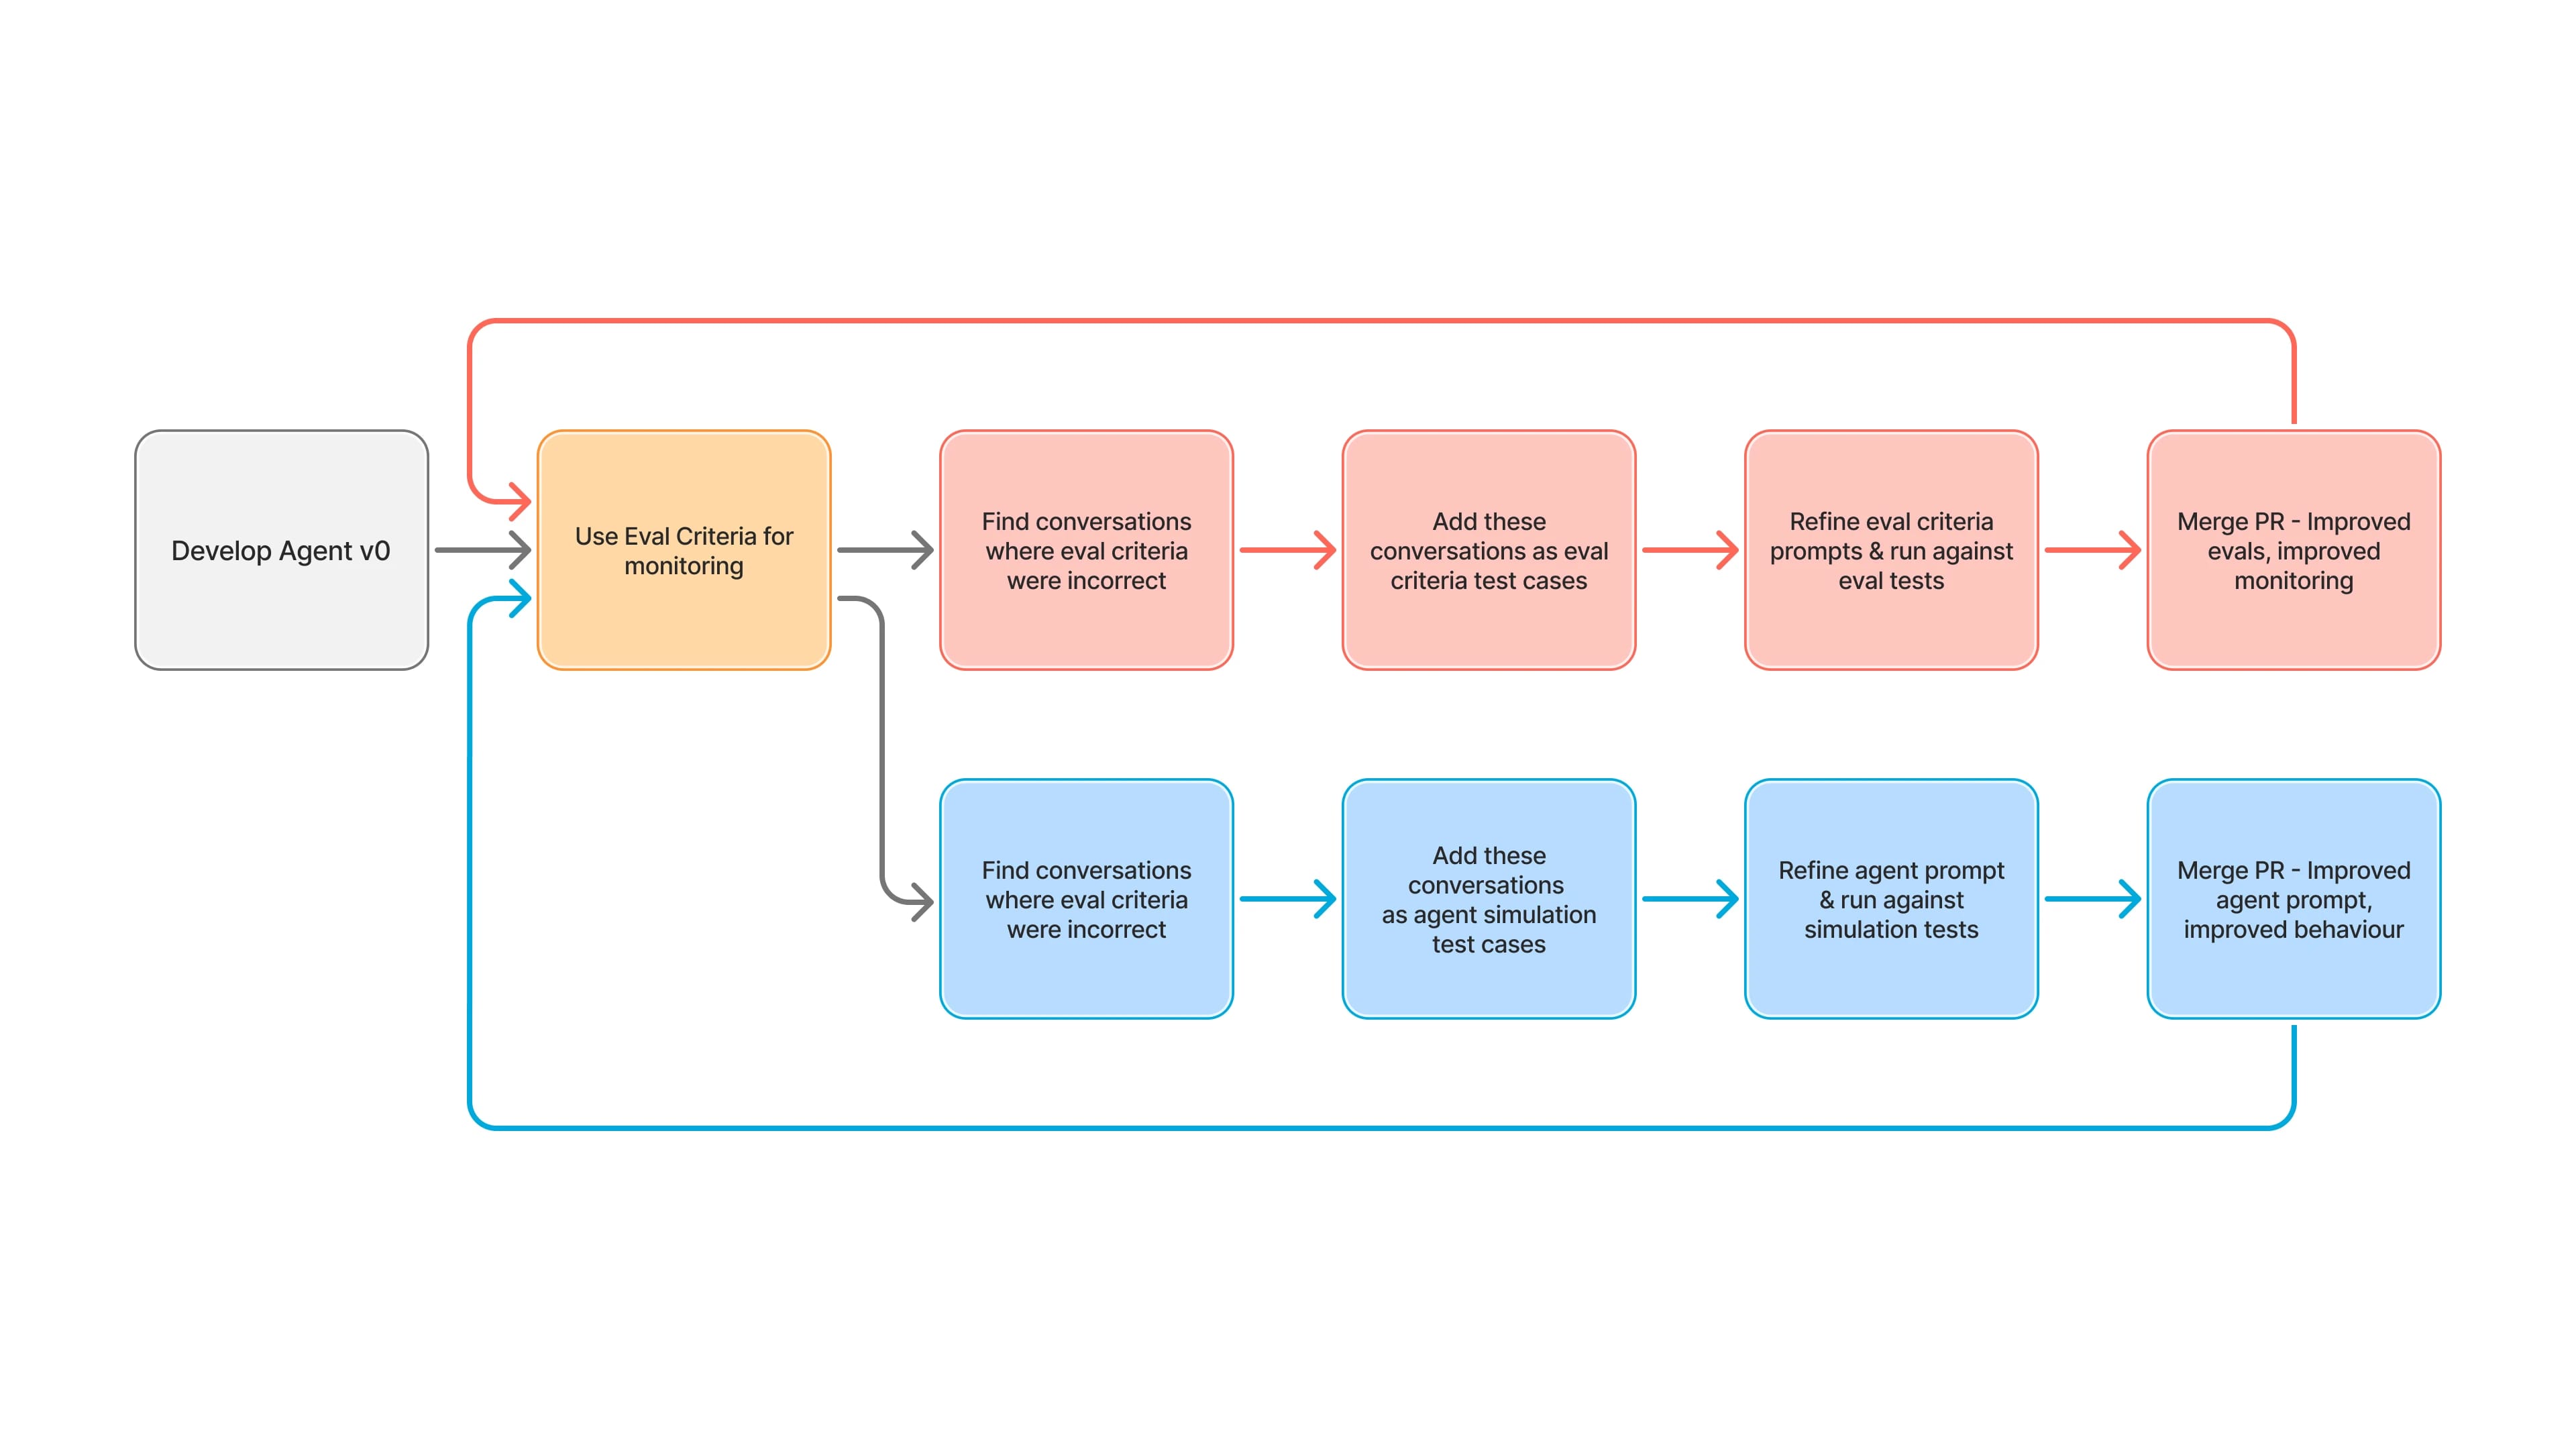
Desarrollamos los siguientes criterios de evaluación:
- Interacción: ¿es una conversación válida?, ¿el usuario hizo preguntas relevantes?, ¿la conversación tenía sentido?
- Interacción positiva: ¿el usuario terminó satisfecho o se quedó confundido o frustrado?
- Comprensión de la causa raíz: ¿el agente identificó correctamente el problema subyacente del usuario?
- Resolución de la consulta del usuario: ¿el agente resolvió el problema del usuario o proporcionó un método de asistencia alternativo?
- Alucinación: ¿el agente inventó información que no está en la base de conocimiento?
Si Interacción falla, la conversación en sí no es válida. Si falla cualquier otro criterio, investigamos más a fondo. La investigación nos indica cómo mejorar el agente. A veces consiste en perfeccionar el uso de herramientas o los tiempos. Otras, en añadir medidas de protección para evitar acciones no compatibles.
Iterar con confianza: API de simulación de conversaciones
Una vez que hemos identificado qué mejorar, el siguiente paso es probarlo. Ahí es donde entra nuestra API de simulación de conversaciones . Simula situaciones realistas de usuarios, tanto de principio a fin como en segmentos concretos, y evalúa automáticamente los resultados con los mismos criterios que aplicamos en producción. Admite simulaciones de herramientas y evaluaciones personalizadas, por lo que ofrece la flexibilidad necesaria para probar comportamientos específicos.
Utilizamos dos enfoques:
- Simulaciones completas: Prueba conversaciones completas de principio a fin.
- Simulaciones parciales: empieza a mitad de la conversación para validar puntos de decisión o subflujos. Es nuestro método preferido para las pruebas unitarias, ya que permite iterar rápidamente y depurar de forma específica.
Los escenarios claros y concretos nos permiten controlar qué se prueba del LLM y garantizar la cobertura de casos límite, el uso de herramientas y la lógica de respaldo.
Automatización a escala: integrar pruebas en CI/CD
La última pieza es la automatización. Utilizamos las API abiertas de ElevenLabs para conectarnos a nuestro flujo de DevOps en GitHub e integrar la evaluación y la simulación en nuestra canalización de CI/CD. Cada actualización se prueba automáticamente antes del despliegue. Así evitamos regresiones y obtenemos rápidamente información sobre el rendimiento en situaciones reales.
Resultados: un El más sólido e inteligente
Este proceso transformó nuestra forma de crear y mantener El. Hemos creado un ciclo de retroalimentación que conecta el uso real con una evaluación estructurada, pruebas específicas y validación automatizada, lo que nos permite lanzar mejoras más rápido y con mayor confianza.
Y es un marco que ahora podemos aplicar a cualquier agente que creemos.



