Stream bygger multimodala AI-agenter med ElevenLabs
- Skriven av
- Fergal Burnett Small
- Publicerad
LyssnaLyssna på den här artikeln
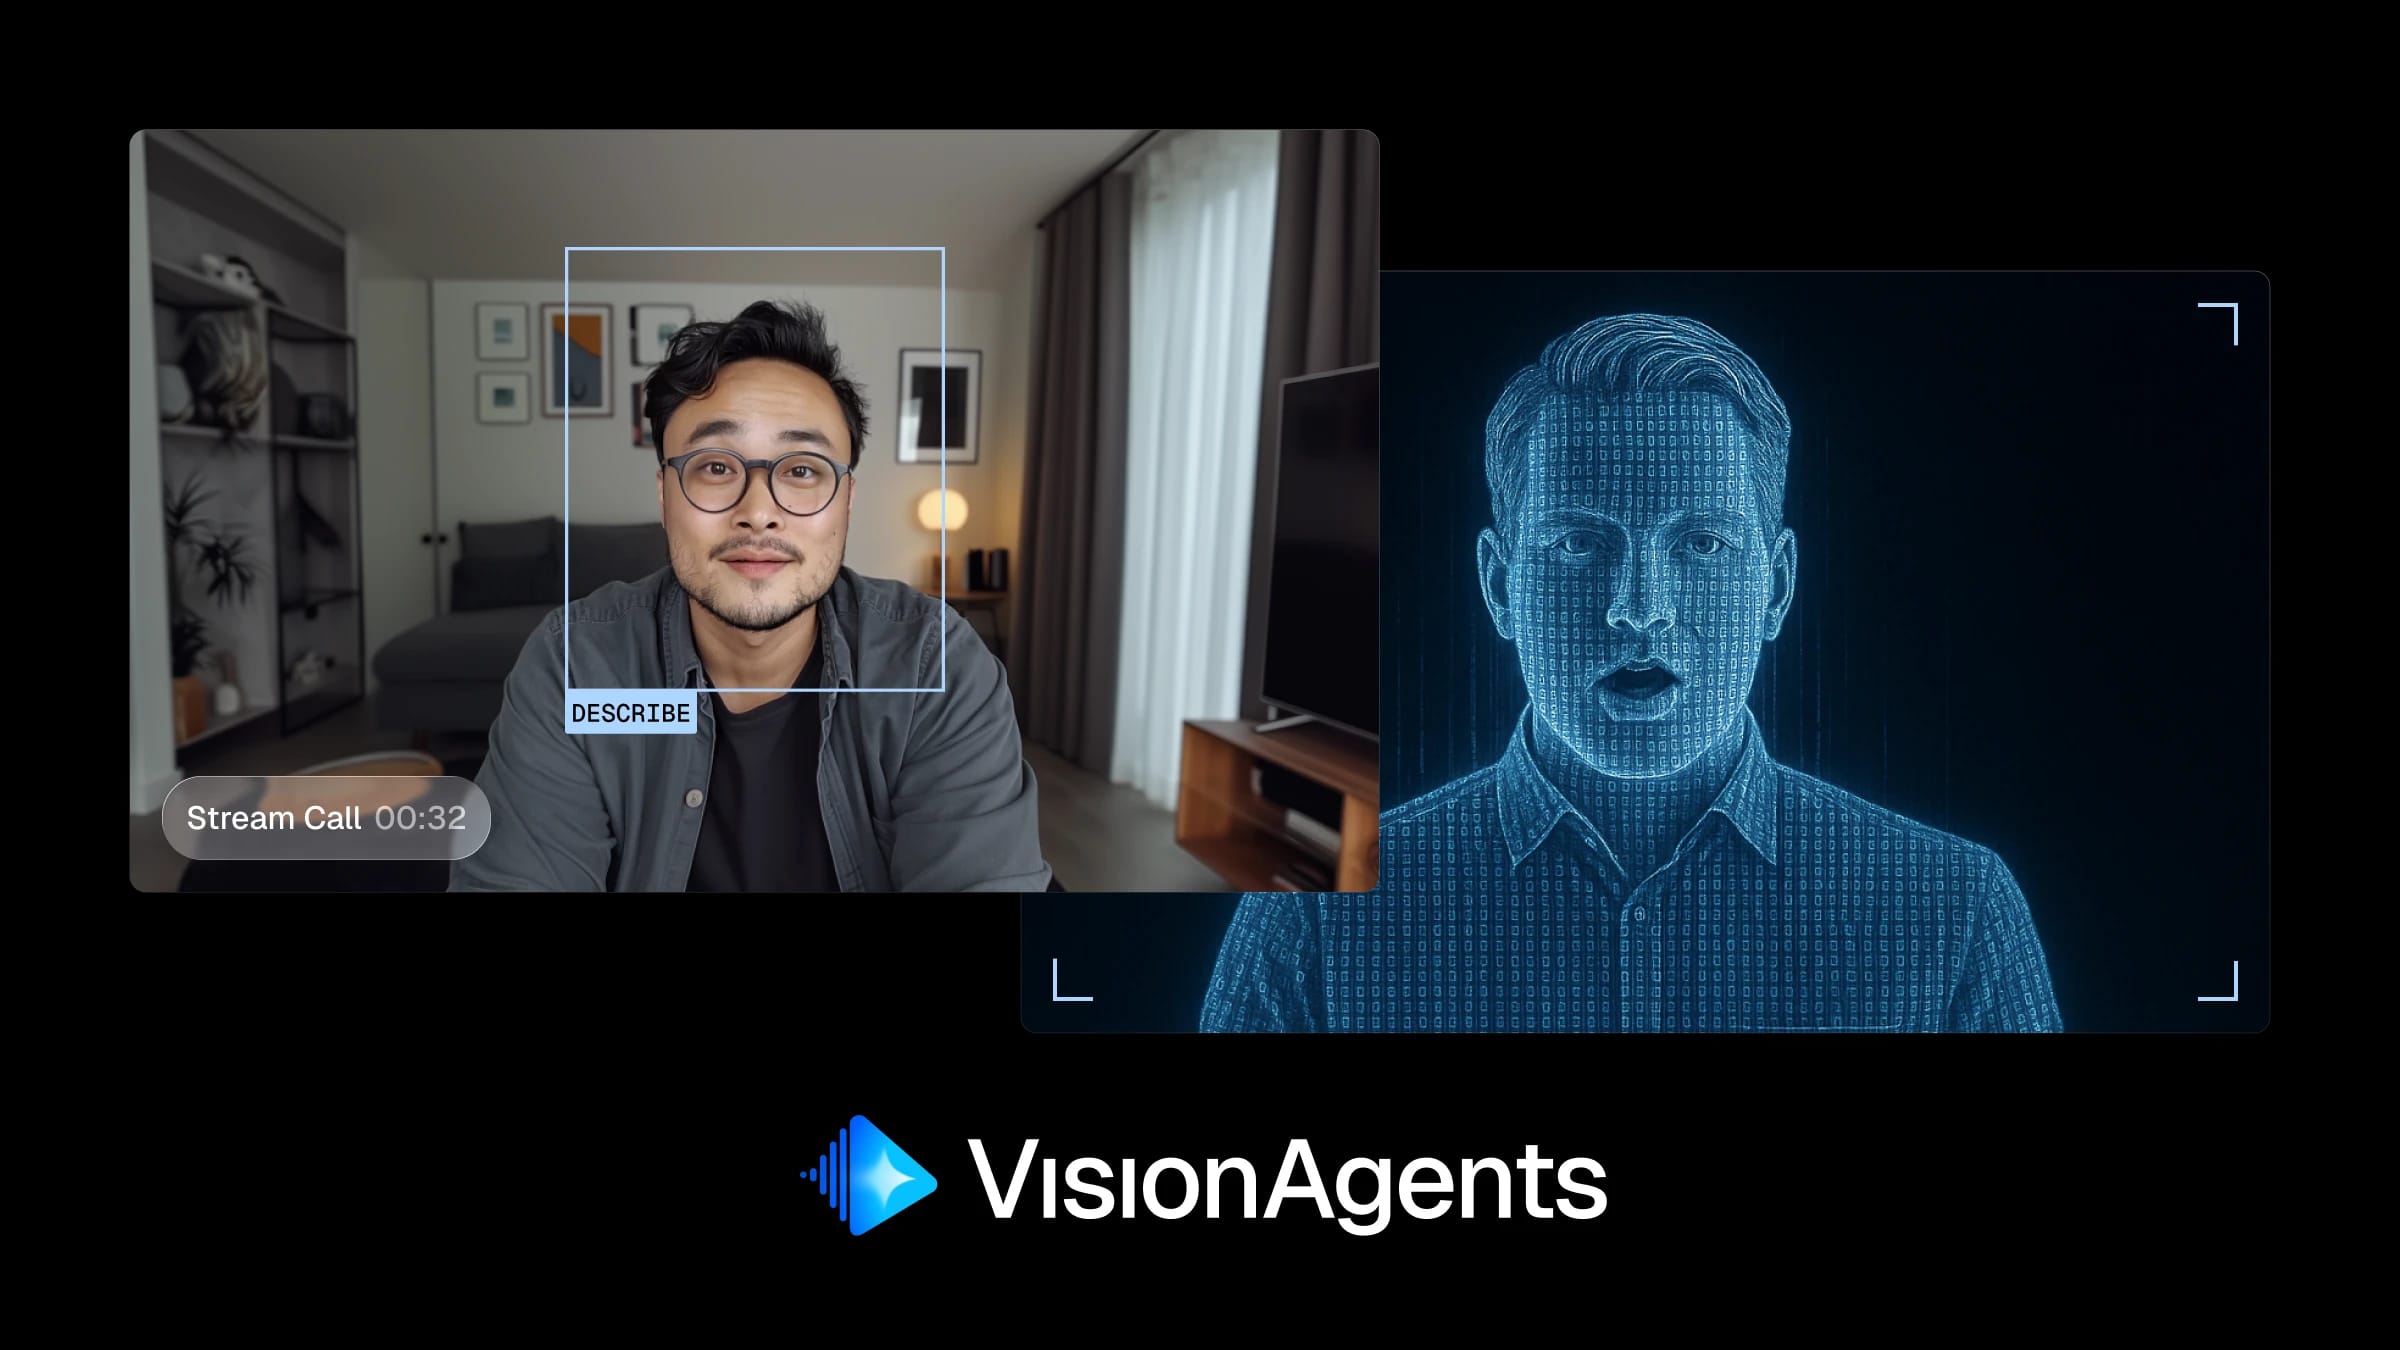
Stream har lanserat Vision Agents – ett ramverk med öppen källkod som gör det möjligt för utvecklare att bygga snabba, multimodala AI-upplevelser som kombinerar video, ljud och konversationer i realtid. Ramverket integrerar ElevenLabs Text to Speech för att skapa uttrycksfulla och responsiva röster som möjliggör smidiga interaktioner mellan användare och AI-system.
Möjliggör multimodala agenter i realtid
Vision Agents ger AI möjlighet att se, höra och svara i realtid. Ramverket bygger på Streams SDK:er för video och ljud och ger utvecklare en snabb grund för att skapa prototyper av och driftsätta multimodala agentupplevelser.
När Stream utvärderade leverantörer av Text to Speech valde de ElevenLabs för vår marknadsledande kvalitet och enkla integration – ElevenLabs är nu det främsta röstalternativet för Streams användare.
”ElevenLabs gjorde det enkelt för oss att snabbt lägga till kraftfulla text-till-tal-funktioner i vårt SDK, så att Agents kan svara på användarfrågor i realtid med uttrycksfulla röster eller ge återkoppling på det de ser.” – Neevash Ramdial, marknadschef, Stream
Snabb, tillförlitlig och utvecklarvänlig integration
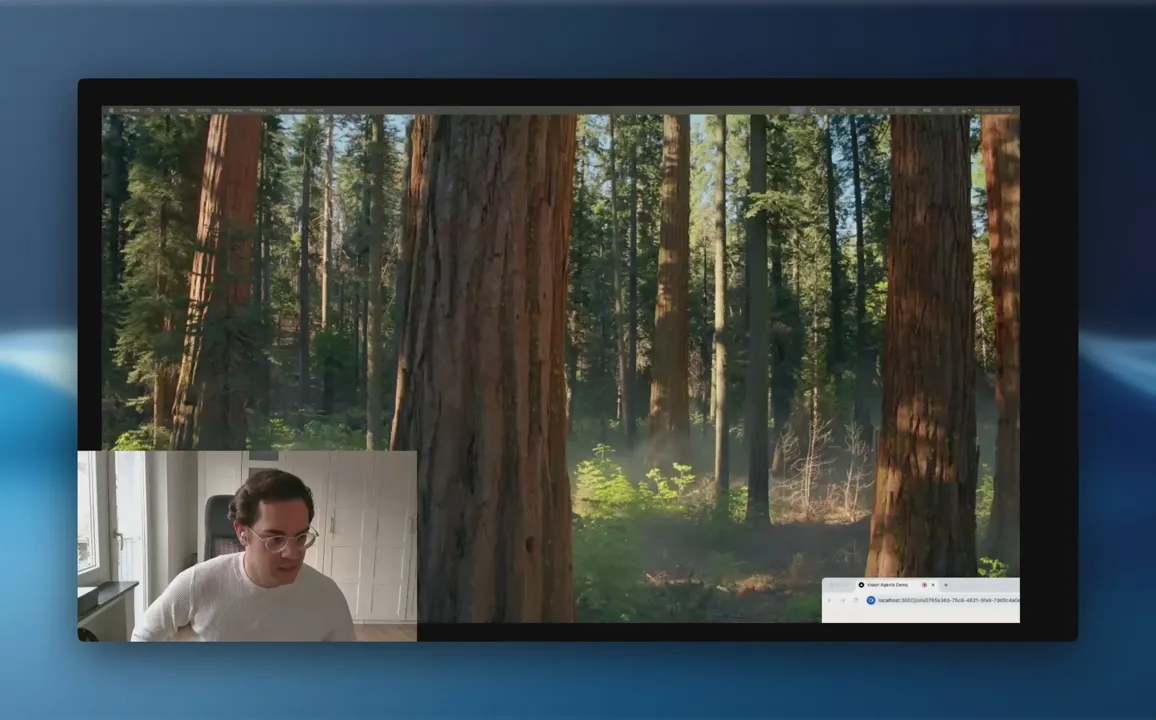
Stream integrerade ElevenLabs i hela sin kodbas på bara några dagar, vilket gör det möjligt för utvecklare att lägga till verklighetstroget röstutdata i sina vision-agenter med minimal konfiguration. Integrationen erbjuder nu:
- 10 gånger snabbare installation – Förintegrering med ElevenLabs minskar tiden för röstinstallation från 400 rader kod till bara 40.
- Prestanda med låg latens – ElevenLabs snabba röstgenerering, i kombination med Streams globala edge-nätverk, ger en responsivitet som känns naturlig och mänsklig.
- Skalbar utvecklarupplevelse – Streams SDK:er förenklar processen att skapa, testa och driftsätta multimodala agenter.
Bygger framtidens multimodala AI
Streams Vision Agents visar hur ElevenLabs modeller utökar möjligheterna inom multimodal AI. Genom att kombinera visuell förståelse med Text to Speech kan utvecklare skapa agenter som inte bara ser, utan också talar och lyssnar med nästan mänsklig naturlighet.
Vill du bygga med Text to Speech? Kontakta oss här.
Fergal jobbar i Growth-teamet och ser till att vår forskning och våra produkter når ut till användare.