Vårt lagerbaserade säkerhetsramverk för AI-agenter
- Skriven av
- Louise Meyer-Schoenherr
- Publicerad
- Senast uppdaterad
LyssnaLyssna på den här artikeln
När AI-agenter tar sig an uppgifter med höga insatser behöver team känna sig trygga med att deras agenter agerar säkert och förutsägbart.
I ElevenAgents använder vi en säkerhetsarkitektur i flera lager, med guardrails i varje steg av ett samtal, adversarial testning före lansering, övervakning i produktion, dataskydd och oberoende validering.
Inget icke-deterministiskt system kan skydda mot alla risker, men med detta omfattande säkerhetsramverk kan ledande företag och myndigheter som bygger med ElevenAgents skapa agenter som sällan misslyckas, återhämtar sig smidigt och uppfyller höga säkerhetskrav.
Skydd i varje steg av samtalet
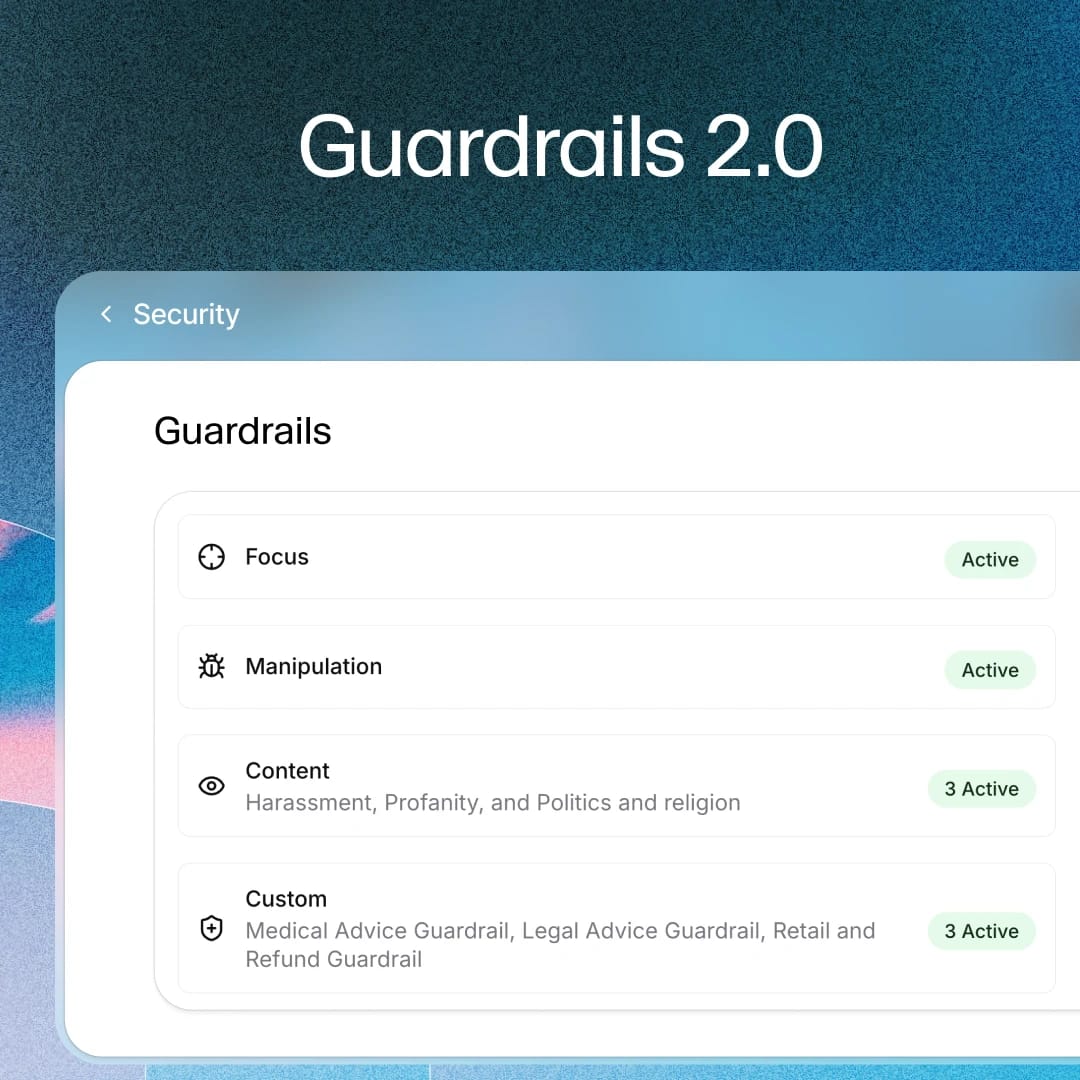
Du kan enkelt aktivera och konfigurera kontroller som skyddar de tre stegen i varje interaktion. Detta är grunden för Guardrails 2.0 i ElevenAgents.
Inmatning – Kontroller i realtid av det användaren skickar.
- Guardrails mot manipulation analyserar användarens inmatning oberoende och kan avsluta samtal som visar tecken på prompt injection.
Beslut – Hur agenten vägleds och hålls på rätt spår när den avgör vad den ska göra.
- Systemprompter bör innehålla tydliga instruktioner för agenten, till exempel att undvika olämpliga ämnen, ange hur agenten presenterar sig och begränsa dess omfattning.
- Workflows och procedurer kan lägga de mest känsliga åtgärderna bakom verktygsanrop, till exempel att verifiera en uppringares identitet innan några kontouppgifter delas.
- Focus-guardrailen förstärker de befintliga systeminstruktionerna och motverkar avvikelser, vilket är särskilt viktigt i långa eller komplexa interaktioner.
Utdata – Oberoende validerare körs parallellt med svarsgenereringen och ger minimal fördröjning. De kan aktiveras för att blockera svar som innehåller känsligt innehåll eller bryter mot dina policyer.
- Innehållsguardrails granskar känsliga kategorier med tröskelvärden för varje kategori.
- Anpassade guardrails tillämpar domänspecifika regler skrivna på klarspråk, där varje regel utvärderas av en lättviktig modell.
- Avslutsstrategier låter dig definiera vad som ska hända när en guardrail aktiveras, till exempel att avsluta samtalet, koppla vidare till en människa eller försöka svara igen med korrigerande instruktioner.
Robust testning före lansering
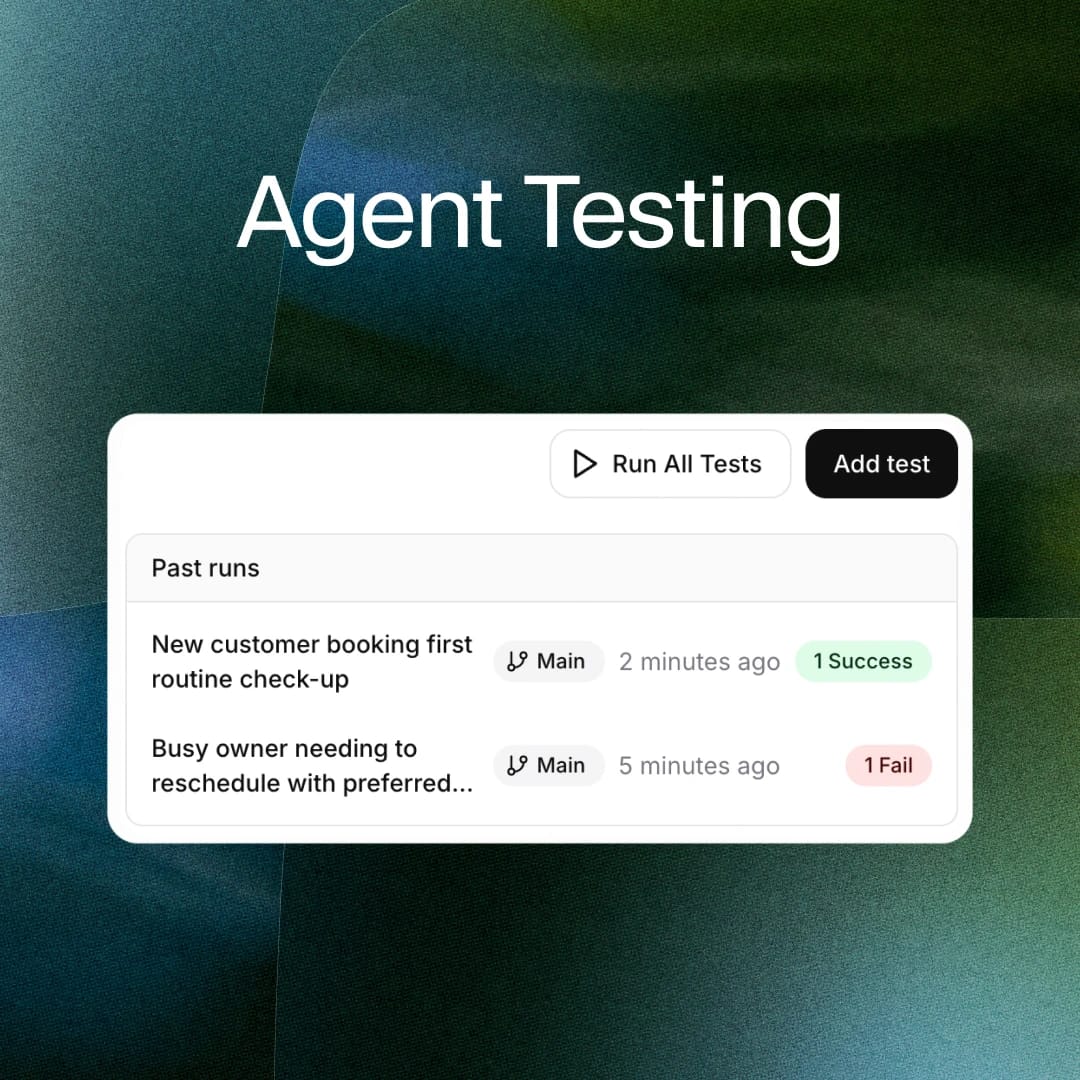
ElevenAgents erbjuder robust testfunktionalitet så att de som bygger på plattformen kan hitta och åtgärda problem innan en agent eller konfigurationsändring tas i bruk.
Simuleringar låter dig genomföra ett helt samtal över flera turer med en simulerad användare innan någon verklig interaktion sker. Du definierar scenariot och simulatorn driver samtalet till en lösning, inklusive riktiga eller simulerade verktygsanrop. Eftersom du styr den simulerade användaren kan du göra den fientlig eller manipulativ, så att samma mekanism som validerar vanliga flöden också testar adversariala scenarier.
Flera funktioner utökar denna täckning:
- Upprepade körningar kör ett test många gånger, med fel grupperade efter orsak för att synliggöra felmönster och gränsfall.
- Tester av nästa svar och verktygsanrop kontrollerar enskilda svar och kritiska åtgärder.
- Kanalspecifik testning verifierar att en agent fungerar som förväntat i varje kanal den används i, eftersom agentens utdata kan anpassas efter kanal (t.ex. kortfattad i ett samtal men utförlig i e-post).
- Red-teaming via API. Tester kan också köras via API:et med SDK:er för red-teaming.
Utvärdera och förbättra agenter efter lansering
När du driftsätter dina agenter körs utvärderingar kontinuerligt på live-samtal. Med en LLM-som-domare-metod kan varje samtal automatiskt utvärderas mot de kriterier du anger. Du kan granska samtalsresultat i instrumentpaneler och spåra problem med detaljerade samtalsloggar som innehåller sökbara transkript, källor, verktygsanrop och guardrail-aktiveringar.
Alla problem som upptäcks i produktion kan enkelt föras tillbaka till testsviten. När en ändring föreslås kan du använda Experiments för att styra en del av live-trafiken till en variant och mäta faktiska resultat innan den används i större skala.
Vi rekommenderar att du driftsätter stegvis. Led en begränsad del av trafiken till din agent, utvärdera dessa samtal och utöka sedan till fler användningsfall, kanaler eller regioner när du har verifierat att agenten fungerar som förväntat.
Skydda känsliga data
Agenter kan hantera betalningsuppgifter, hälsouppgifter och personliga identifierare, så det är viktigt att tänka på vilka data som lagras, var de lagras och hur länge.
Vi erbjuder flera olika sätt för kunder att skydda data:
- Zero Retention Mode kan aktiveras för berättigade tjänster för att säkerställa att vissa typer av data inte lagras, utformat för miljöer med höga regulatoriska krav.
- Maskering av samtalshistorik tar bort känsliga entiteter efter ett samtal och ersätter dem med platshållare i text och pipljud i ljud, ända ned på nivån för enskilda entitetstyper.
- Konfigurerbar lagringstid anpassar lagringsperioder efter dina regulatoriska krav.
- Datalagringsplats håller behandlingen inom en obligatorisk jurisdiktion.
- Privata driftsättningar (VPC) isolerar miljön för arbetsbelastningar med hög känslighet.
- Kryptering skyddar data under överföring och lagring.
Skydd på plattformsnivå och extern validering
Allt ovanstående bygger på våra bredare skydd på plattformsnivå, ett omfattande program som omfattar innehållsproveniens, upptäckt av missbruk, tillämpning av förbud mot användning och red-teaming av modeller. Genom vårt Safety Partnership Program samarbetar vi också med företag i framkant inom AI-säkerhet och bidrar till deras produkter och till nya branschstandarder.
Vi låter också vår metod granskas oberoende, inklusive utifrån allmänna standarder för säkerhet och integritet som SOC 2 Type II, ISO 27001 och GDPR, samt bransch- och användningsfallsspecifika certifieringar som PCI DSS Level 1 för betalningshantering och HIPAA för amerikansk hälso- och sjukvård. Besök vårt Trust Center för mer information.
Vi uppfyller även nyare, AI-anpassade standarder som ISO 42001, som styr AI-ledningssystem, och AIUC-1 som kräver att AI-agenter klarar kvartalsvisa adversariala simuleringar från oberoende utvärderare. Samma kapacitet som ligger bakom AIUC-1 ger också tillgång till några av branschens första försäkringar för agenter.
Vid stora eller komplexa utrullningar arbetar våra Forward Deployed Engineers tillsammans med ditt team för att utforma och implementera er agentstrategi, inklusive konfiguration, guardrails, testning, övervakning och utrullningsstrategi.
Slutsats
Vår metod för säkerhet i ElevenAgents består av flera lager, där varje del stärker de andra:
- Agentkonfiguration: Systemprompter, workflows och procedurer som formar beteendet, där de mest känsliga åtgärderna ligger bakom verktygsanrop.
- Guardrails: Oberoende kontroller i varje steg: upptäckt av manipulation vid inmatningen, Focus vid beslutet samt innehålls- och anpassade validerare vid utdata, med konfigurerbara avslutsstrategier.
- Testning: Adversariala simuleringar, upprepade körningar, kanalspecifika tester och red-teaming före lansering.
- Övervakning: Stegvis utrullning, därefter kontinuerlig utvärdering, sökbara loggar och transkript samt en återkopplingsloop efter lansering.
- Dataskydd: Maskering, Zero Retention Mode, konfigurerbar lagringstid, datalagringsplats, privata driftsättningar (VPC) och kryptering.
- Extern validering: Certifieringar, AIUC-1:s oberoende adversariala testning, agentförsäkring, red-teaming och expertstöd.