Terugblik op webinar: geef je tekstchatbot een menselijk klinkende stem
- Gepubliceerd
- Laatst bijgewerkt
LuisterenLuister naar dit artikel
Chat-agents zijn een standaardonderdeel geworden van de enterprise-softwarestack. De meeste bedrijven hebben er een of bouwen er een. Waar minder bedrijven al een antwoord op hebben, is wat er gebeurt wanneer een gebruiker liever gewoon praat.
Spraak verandert de interactie op manieren die verder gaan dan gemak. Gebruikers uiten frustratie, urgentie en verwarring via hun toon op manieren die tekst volledig wegneemt. Een klant die typt: "mijn bestelling is niet aangekomen" en een klant die dit met hoorbare angst zegt, geven verschillende signalen af - en de agent die alleen het transcript kan lezen, werkt slechts met de helft van de informatie.
De vraag die de meeste teams nu stellen, is niet óf ze spraak moeten toevoegen, maar hoe ze dat doen zonder alles wat al werkt opnieuw op te bouwen.
In Live Workshop: Geef je tekstchatbot een menselijk klinkende stem, namen Paul Asjes (Developer Experience), Bhargavi Bhatt (Customer Experience) en Fergal Burnett (Product Marketing, ElevenAPI) de technische realiteit door van het toevoegen van spraak aan een bestaande agent en lieten ze zien hoe een werkende integratie er daadwerkelijk uitziet.
Waarom bouwen met spraak lastiger is dan het lijkt
Een van de grootste uitdagingen is beurtwisseling. Mensen weten wanneer iemand is uitgesproken door intonatie, ritme en context. Voice activity detection (de standaardaanpak) detecteert daarentegen alleen stilte.
Het resultaat is vaak een systeem dat elke pauze ziet als een uitnodiging om te praten: een systeem dat onderbreekt, iemand midden in een gedachte afkapt en op natuurlijke aarzelingen reageert alsof het voltooide zinnen zijn.
Technisch werkt het, maar in een gesprek werkt het niet.
Context is de andere helft van het probleem. Bij elke beurt de gespreksgeschiedenis aan een LLM doorgeven is noodzakelijk, maar niet voldoende. Dezelfde woorden hebben een andere betekenis afhankelijk van hoe ze worden uitgesproken - "het gaat goed" met opluchting gezegd en "het gaat goed" met frustratie gezegd leveren hetzelfde transcript op, maar een andere interactie. Een spraaksysteem dat die dimensie negeert, zal altijd enigszins onnatuurlijk klinken, ongeacht hoe goed de afzonderlijke modellen zijn.
Er is ook de technische overhead. Teams die hun eigen spraakorkestratie beheren, moeten de logica voor beurtwisseling, het afhandelen van onderbrekingen en latentieprofilering voortdurend onderhouden. Het is geen eenmalige implementatie.
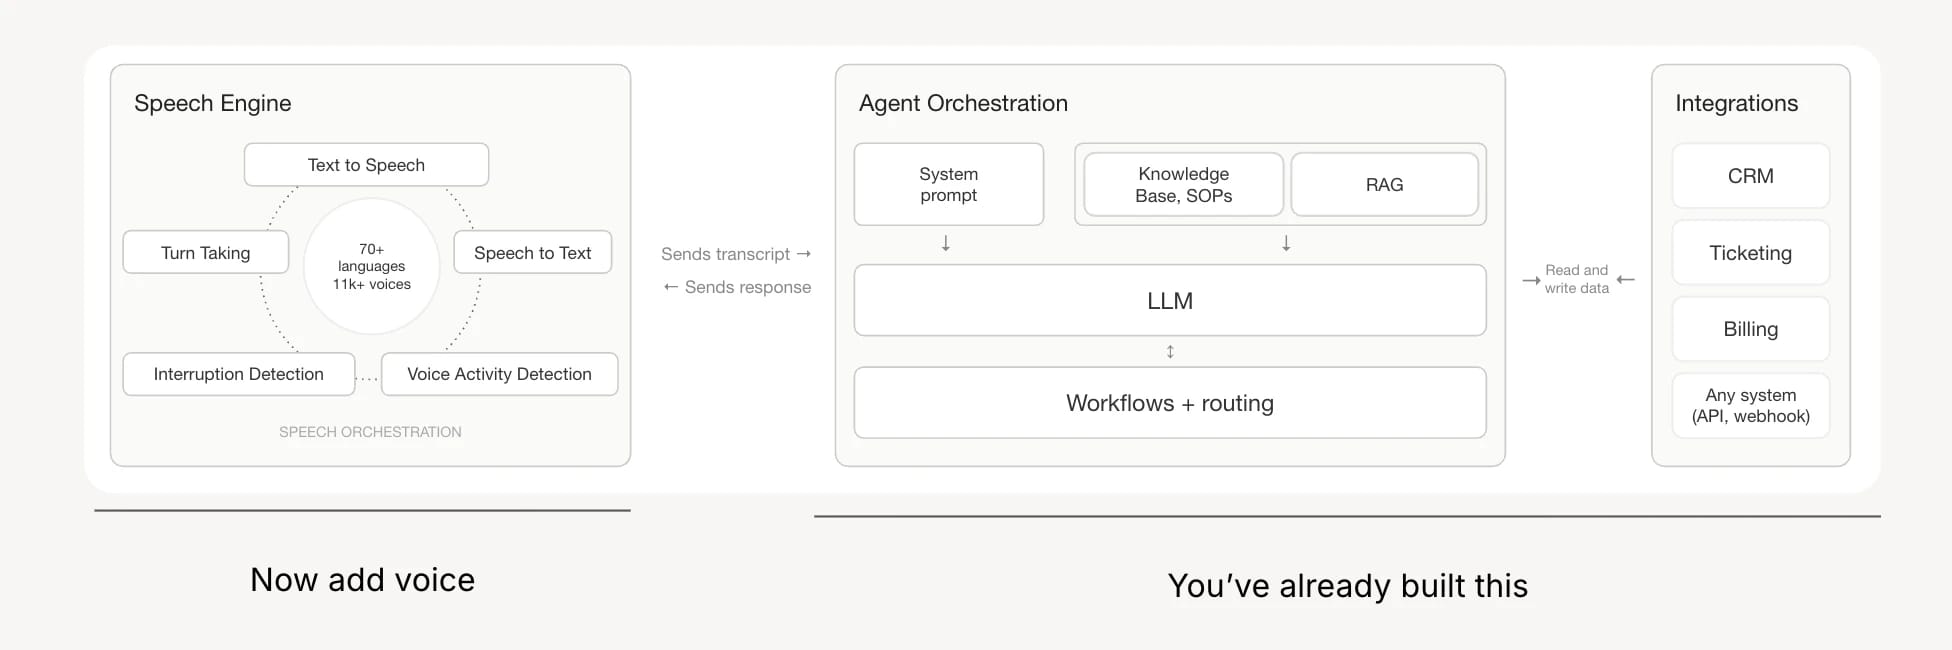
Spraak toevoegen aan een bestaande agent
De overzichtelijkste aanpak is een architectuur met twee WebSocket-verbindingen.
- Eén verbinding loopt tussen de client en de ElevenLabs API, en een andere tussen je server en de ElevenLabs API
- De gebruiker spreekt in de microfoon, de audio wordt naar de ElevenLabs API gestuurd, daar getranscribeerd en vervolgens naar je server verzonden
- Je server geeft de volledige gespreksgeschiedenis die hij van de ElevenLabs API ontvangt door aan het LLM, en de gestreamde response gaat terug voor audiosynthese
- Dit kan beginnen voordat het LLM klaar is met genereren - zodat de first-byte-latentie laag blijft
Het belangrijkste integratiepunt is de methode onTranscript , die aan het eind van elke beurt wordt aangeroepen en de volledige gespreksgeschiedenis aan het LLM doorgeeft.
Een contextualUpdate bij de start van een sessie neemt alles mee wat er in het tekstgedeelte van het gesprek gebeurde voordat de gebruiker naar spraak overstapte. Daardoor kan één agent via beide modaliteiten werken zonder de context te verliezen.
Een paar aandachtspunten bij het bouwen:
- De keuze van het LLM is bij spraak belangrijker dan bij chat. Modellen voor diepgaand redeneren zorgen voor pauzes die in audio als onnatuurlijke aarzeling overkomen, ook als de response van hogere kwaliteit is. Voor realtime spraak winnen snellere modellen bijna altijd op ervaren kwaliteit.
- Gebruik WebRTC in plaats van WebSockets voor audio. WebRTC beschikt standaard over echo- en ruisonderdrukking, wat vooral belangrijk wordt op mobiel of in lawaaiige omgevingen. Gebruik je WebSockets voor audiotransport, dan moet je dat zelf afhandelen.
- Vraag gebruikers niet om een taal te selecteren. Het verstoort de gespreksflow. De taal detecteren aan de hand van de eerste paar seconden spraak en die vastzetten is een beter patroon - en maakt soepele wisselingen mogelijk zonder dat de gebruiker iets hoeft te doen.
- Houd je model voor beurtwisseling gescheiden van je LLM. Het LLM laten bepalen wanneer een gebruiker is uitgesproken, voegt bij elke beurt latentie en kosten toe. Een gespecialiseerd model voor beurtwisseling handelt dit sneller en nauwkeuriger af, en het loont om dit als afzonderlijk onderdeel van de architectuur te behandelen.
Hoeveel infrastructuur je zelf beheert
Het juiste antwoord hangt af van wat er al bestaat. Heb je een werkende chatagent, dan is daar een spraaklaag bovenop toevoegen (terwijl je LLM, orkestratie en bedrijfslogica intact blijven) meestal de snelste route met het minste risico.
Je bouwt niets opnieuw op. Je voegt een audio-interface toe aan iets dat al werkt.
Als de vereisten zich uitstrekken tot telefonie, beheer van implementatiekanalen, ingebouwde tests en analytics, is het logisch om meer van de stack onder te brengen bij een platform voor spraakagents. De twee benaderingen sluiten elkaar niet uit - teams kunnen beginnen met een lichte spraaklaag en platformmogelijkheden toevoegen naarmate de use case volwassener wordt.
Demo: Spraak toevoegen aan een bestaande chatbot
Deze demo volgt een gebruiker die midden in een gesprek zit met een op tekst gebaseerde chatbot voor reisplanning en om aanbevelingen vraagt voor wijken en eten tijdens een reis naar Japan.
Wat we hebben behandeld:
- De chatbot werd uitgebreid met een spraaklaag, zonder wijzigingen aan de onderliggende agent.
- De gebruiker schakelde midden in het gesprek over van typen naar spreken - de agent behield de volledige context in beide modaliteiten.
- De gebruiker sprak Nederlands; de agent detecteerde de taalwisseling automatisch
- Toen de agent werd onderbroken en halverwege een zin werd gevraagd om terug te schakelen naar Engels, deed die dat - en rondde de response ongevraagd af met een licht Nederlands accent.
- Tijdens het hele gesprek zorgde onderbrekingsdetectie ervoor dat de gebruiker op natuurlijke wijze door de agent heen kon praten zonder dat de agent zijn beurt afmaakte.
Waarom dit belangrijk is:
De demo liet geen speciaal ontwikkelde spraakagent zien. De demo liet een tekstagent zien die al werkte, met daarbovenop een spraaklaag. De contextverwerking, taaldetectie en het gedrag bij onderbrekingen kwamen allemaal van de spraaklaag - de onderliggende tekstagent bleef ongewijzigd.
Bekijk de volledige sessie
Bekijk het volledige webinar hier.
Paul maakt deel uit van het Developer Growth-team bij ElevenLabs en woont in Valencia, Spanje. Hij werkt er als Developer Experience Engineer, met een focus op belangenbehartiging en tooling voor het platform. Voordat hij bij ElevenLabs kwam, leidde hij Developer Relations bij Stripe, werkte hij aan DX bij WorkOS en bouwde hij jarenlang full-stack webapplicaties en tooling voor ontwikkelaars.