Ons gelaagde veiligheidsframework voor AI-agents
- Geschreven door
- Louise Meyer-Schoenherr
- Gepubliceerd
- Laatst bijgewerkt
LuisterenLuister naar dit artikel
Naarmate AI-agents taken met grote gevolgen uitvoeren, hebben teams er vertrouwen in nodig dat hun agents zich veilig en voorspelbaar gedragen.
In ElevenAgents gebruiken we een gelaagde veiligheidsarchitectuur met guardrails in elke fase van een gesprek, adversarial testing vóór de lancering, monitoring in productie, gegevensbescherming en onafhankelijke validatie.
Hoewel geen enkel niet-deterministisch systeem bescherming kan bieden tegen elk risico, stelt dit uitgebreide veiligheidsframework toonaangevende bedrijven en overheden die op ElevenAgents bouwen in staat agents te ontwerpen die zelden falen, zich soepel herstellen en aan hoge veiligheidseisen voldoen.
Bescherming in elke fase van het gesprek
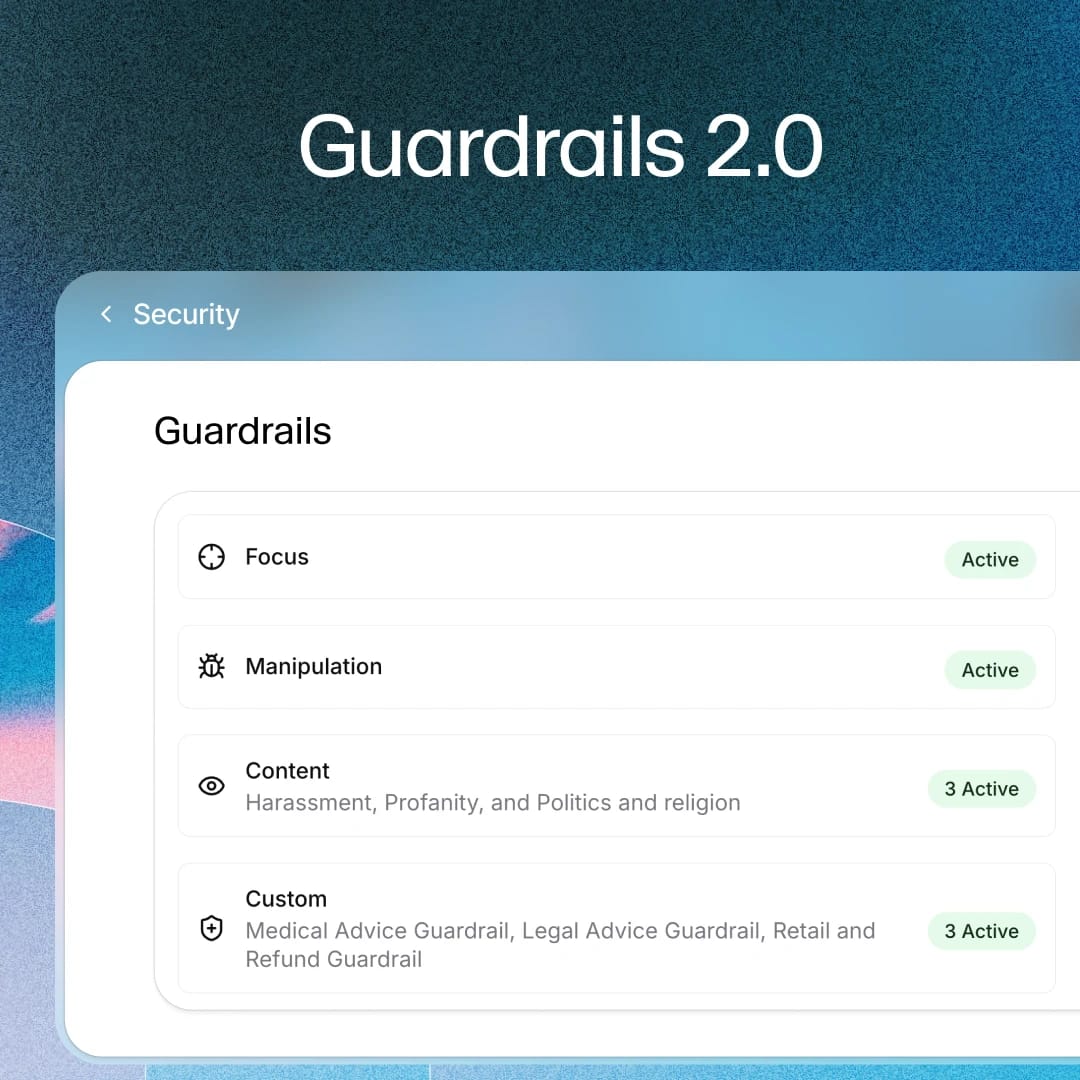
Je kunt eenvoudig controles inschakelen en configureren die de drie fasen van elke interactie beschermen. Dit vormt de basis voor Guardrails 2.0 in ElevenAgents.
Invoer - Realtime controles van wat de gebruiker verstuurt.
- Manipulatieguardrails analyseren gebruikersinvoer onafhankelijk en kunnen gesprekken beëindigen die tekenen van prompt injection vertonen.
Beslissing - Hoe de agent wordt aangestuurd en op koers blijft bij het bepalen van wat te doen.
- Systeemprompts moeten expliciete instructies voor de agent bevatten, zoals het vermijden van ongepaste onderwerpen, het bepalen hoe de agent zich presenteert en het beperken van zijn reikwijdte.
- Workflows en procedures kunnen de gevoeligste acties achter tool calls plaatsen, zoals het verifiëren van de identiteit van een beller voordat accountgegevens worden gedeeld.
- De Focus-guardrail versterkt de bestaande systeeminstructies en beperkt afwijkingen, wat vooral belangrijk is bij lange of complexe interacties.
Uitvoer - Onafhankelijke validators worden parallel aan het genereren van antwoorden uitgevoerd en voegen minimale latentie toe. Je kunt deze inschakelen om antwoorden te blokkeren die gevoelige inhoud bevatten of je beleid schenden.
- Contentguardrails screenen gevoelige categorieën met drempelwaarden per categorie.
- Aangepaste guardrails handhaven domeinspecifieke regels die in gewone taal zijn opgesteld en elk door een lichtgewicht model worden beoordeeld.
- Exitstrategieën laten je bepalen wat er gebeurt wanneer een guardrail wordt geactiveerd, zoals het gesprek beëindigen, doorverbinden met een persoon of het antwoord opnieuw proberen met corrigerende instructies.
Robuust testen vóór de lancering
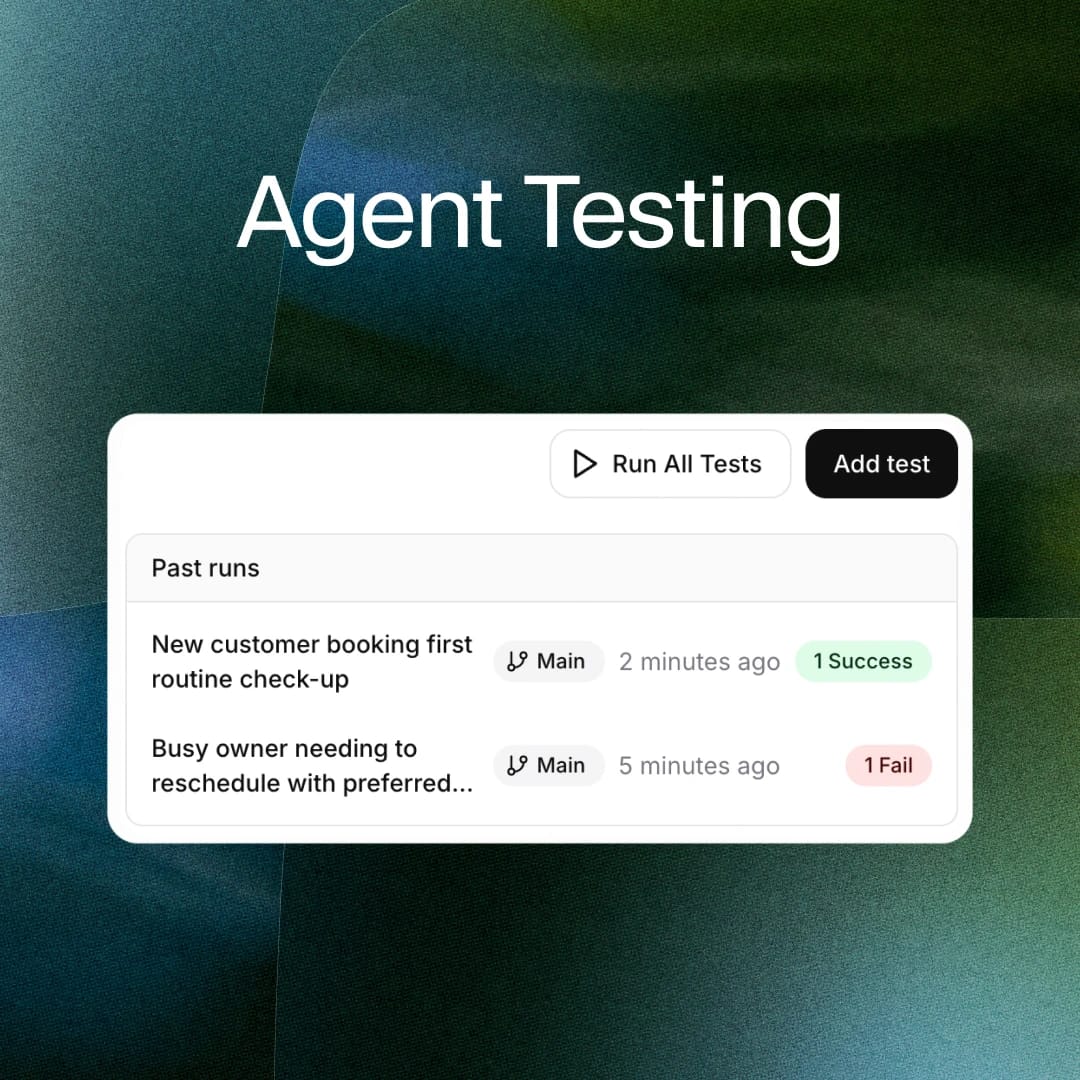
ElevenAgents biedt robuuste testfunctionaliteit, zodat mensen die op het platform bouwen problemen kunnen vinden en oplossen voordat een agent of configuratiewijziging live gaat.
Simulaties laten je vóór echte interacties een volledig gesprek met meerdere beurten uitvoeren met een gesimuleerde gebruiker. Je bepaalt het scenario en de simulator leidt het gesprek naar een oplossing, inclusief echte of nagebootste tool calls. Omdat je de gesimuleerde gebruiker beheert, kun je die vijandig of manipulatief maken, zodat hetzelfde mechanisme dat normale paden valideert ook adversariële paden test.
Verschillende mogelijkheden breiden die dekking uit:
- Herhaalde uitvoeringen voeren een test vaak uit, waarbij fouten op oorzaak worden gegroepeerd om foutpatronen en edge cases zichtbaar te maken.
- Tests voor volgende antwoorden en tool invocations controleren afzonderlijke antwoorden en kritieke acties.
- Kanaalspecifieke tests verifiëren dat een agent naar verwachting presteert op elk kanaal waarop deze wordt ingezet, omdat de uitvoer van een agent per kanaal kan worden aangepast (bijvoorbeeld beknopt tijdens een gesprek en uitgebreid via e-mail).
- Red-teaming via API. Tests kunnen ook via de API worden uitgevoerd met red-teaming SDK's.
Agents evalueren en verbeteren na de lancering
Wanneer je je agents implementeert, worden live gesprekken continu geëvalueerd. Met een LLM-as-a-judge-aanpak kan elk gesprek automatisch worden beoordeeld aan de hand van de criteria die je instelt. Je kunt gespreksuitkomsten in dashboards bekijken en problemen opsporen met gedetailleerde gesprekslogs, waaronder doorzoekbare transcripts, bronnen, tool calls en geactiveerde guardrails.
Problemen die in productie worden gevonden, kun je eenvoudig terugkoppelen naar de testsuite. Wanneer een wijziging wordt voorgesteld, kun je Experiments gebruiken om een deel van het live verkeer naar een variant te leiden en werkelijke resultaten te meten voordat deze breed wordt toegepast.
We raden aan om gefaseerd te implementeren. Leid een beperkt deel van het verkeer naar je agent, evalueer die gesprekken en breid uit naar aanvullende use cases, kanalen of regio's zodra je hebt bevestigd dat je agent naar verwachting werkt.
Gevoelige gegevens beschermen
Agents kunnen betaalgegevens, gezondheidsinformatie en persoonlijke identificatiegegevens verwerken. Daarom is het belangrijk om te overwegen welke gegevens worden opgeslagen, waar ze worden opgeslagen en hoelang.
We bieden klanten verschillende mechanismen om gegevens te beschermen:
- Zero Retention Mode kan voor in aanmerking komende diensten worden ingeschakeld om ervoor te zorgen dat bepaalde soorten gegevens niet worden bewaard. Deze functie is ontworpen voor veeleisende regelgevende omgevingen.
- Redactie van gespreksgeschiedenis verwijdert gevoelige entiteiten na een gesprek en vervangt ze door placeholders in tekst en pieptonen in audio, tot op het niveau van afzonderlijke entiteitstypen.
- Configureerbare bewaartermijnen stemmen opslagperioden af op je wettelijke vereisten.
- Dataresidentie houdt de verwerking binnen een vereiste jurisdictie.
- Private deployments (VPC) isoleren de omgeving voor workloads met hoge gevoeligheid.
- Versleuteling beschermt gegevens tijdens overdracht en opslag.
Beveiligingsmaatregelen op platformniveau en externe validatie
Dit alles rust op onze bredere beveiligingsmaatregelen op platformniveau, een uitgebreid programma met herkomst van content, misbruikdetectie, handhaving van verboden gebruik en model-red-teaming. Via ons Safety Partnership Program werken we ook samen met bedrijven die vooroplopen op het gebied van AI-veiligheid. Zo dragen we bij aan hun producten en aan nieuwe industriestandaarden.
We onderwerpen onze aanpak ook aan onafhankelijke toetsing, waaronder algemene normen voor beveiliging en privacy zoals SOC 2 Type II, ISO 27001 en AVG, naast branche- en use-casespecifieke certificeringen zoals PCI DSS Level 1 voor betalingsverwerking en HIPAA voor de Amerikaanse gezondheidszorg. Bekijk ons trust center voor meer informatie.
We voldoen ook aan nieuwere, AI-native standaarden zoals ISO 42001, dat AI-managementsystemen regelt, en AIUC-1, dat vereist dat AI-agents bestand zijn tegen elk kwartaal uitgevoerde adversariële simulaties door onafhankelijke beoordelaars. Dezelfde mogelijkheden achter AIUC-1 bieden ook toegang tot enkele van de eerste verzekeringen voor agents.
Voor grootschalige of complexe uitroltrajecten werken onze Forward Deployed Engineers samen met je team om je agentstrategie te ontwerpen en implementeren, waaronder configuratie, guardrails, testen, monitoring en uitrolstrategie.
Conclusie
Onze aanpak voor veiligheid in ElevenAgents is gelaagd, waarbij elk element de andere versterkt:
- Agentconfiguratie: Systeemprompts, workflows en procedures die gedrag vormgeven, waarbij de gevoeligste acties achter tool calls worden geplaatst.
- Guardrails: Onafhankelijke controles in elke fase: manipulatiedetectie bij de invoer, Focus bij de beslissing en content- en aangepaste validators bij de uitvoer, met configureerbare exitstrategieën.
- Testen: Adversariële simulaties, herhaalde uitvoeringen, kanaalspecifieke tests en red-teaming vóór de lancering.
- Monitoring: Gefaseerde uitrol, gevolgd door continue evaluatie, doorzoekbare logs en transcripts, en een feedbackloop na de lancering.
- Gegevensbescherming: Redactie, Zero Retention Mode, configureerbare bewaartermijnen, dataresidentie, private (VPC) deployments en versleuteling.
- Externe validatie: Certificeringen, de onafhankelijke adversariële tests van AIUC-1, verzekeringen voor agents, red-teaming en ondersteuning door experts.