Nossa estrutura de segurança em camadas para agentes de IA
- Escrito por
- Louise Meyer-Schoenherr
- Publicado
- Última atualização
OuvirOuça este artigo
À medida que os agentes de IA assumem trabalhos de alto risco, as equipes precisam ter confiança de que eles agirão de forma segura e previsível.
No ElevenAgents, usamos uma arquitetura de segurança em camadas, com guardrails em todas as etapas de uma conversa, testes adversariais antes do lançamento, monitoramento em produção, proteção de dados e validação independente.
Embora nenhum sistema não determinístico possa proteger contra todos os riscos, essa estrutura abrangente de segurança permite que as principais empresas e governos que desenvolvem com o ElevenAgents projetem agentes que falham raramente, se recuperam com elegância e atendem a um alto padrão de segurança.
Proteção em todas as etapas da conversa
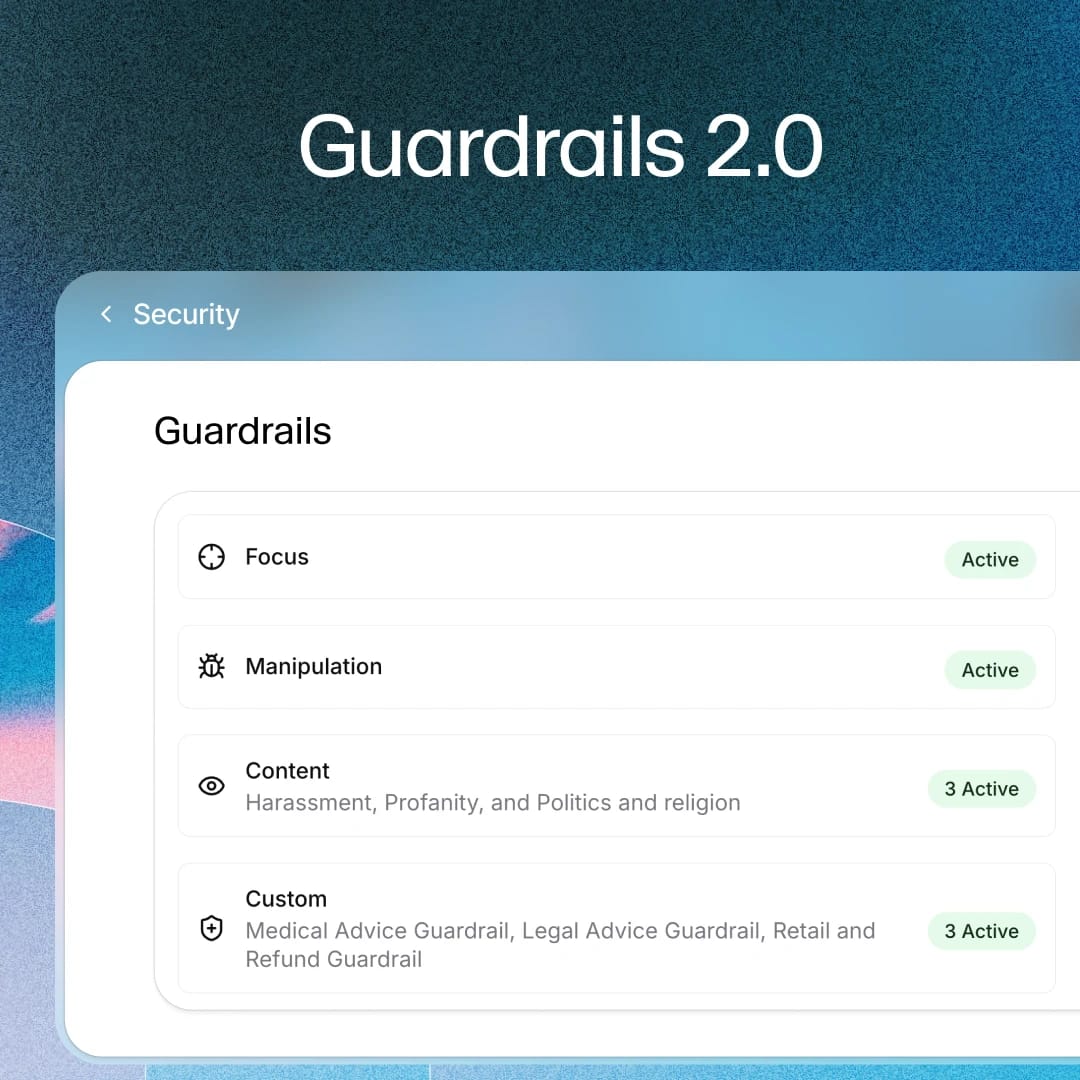
Você pode ativar e configurar facilmente controles que protegem as três etapas de cada interação. Esta é a base do Guardrails 2.0 no ElevenAgents.
Entrada - Verificações em tempo real do que o usuário envia.
- Guardrails de manipulação analisam de forma independente a entrada do usuário e podem encerrar conversas que apresentem sinais de injeção de prompt.
Decisão - Como o agente é orientado e mantido no rumo enquanto decide o que fazer.
- Prompts de sistema devem incluir instruções explícitas para o agente, como evitar tópicos inadequados, definir como ele se apresenta e restringir seu escopo.
- Workflows e procedimentos podem restringir as ações mais sensíveis a chamadas de ferramentas, como verificar a identidade de quem liga antes de compartilhar qualquer detalhe da conta.
- O guardrail Focus reforça as instruções de sistema existentes e reduz desvios, o que é especialmente importante em interações longas ou complexas.
Saída - Validadores independentes são executados em paralelo à geração da resposta, com latência mínima. Eles podem ser ativados para bloquear respostas que incluam conteúdo sensível ou violem suas políticas.
- Guardrails de conteúdo filtram categorias sensíveis com limites definidos para cada categoria.
- Guardrails personalizados aplicam regras específicas do domínio escritas em linguagem simples, cada uma avaliada por um modelo leve.
- Estratégias de saída permitem definir o que acontece quando um guardrail é acionado, como encerrar a chamada, transferir para uma pessoa ou tentar novamente a resposta com instruções corretivas.
Testes robustos antes do lançamento
O ElevenAgents oferece recursos robustos de teste para que quem desenvolve na plataforma possa encontrar e corrigir problemas antes que um agente ou uma alteração de configuração entre em produção.
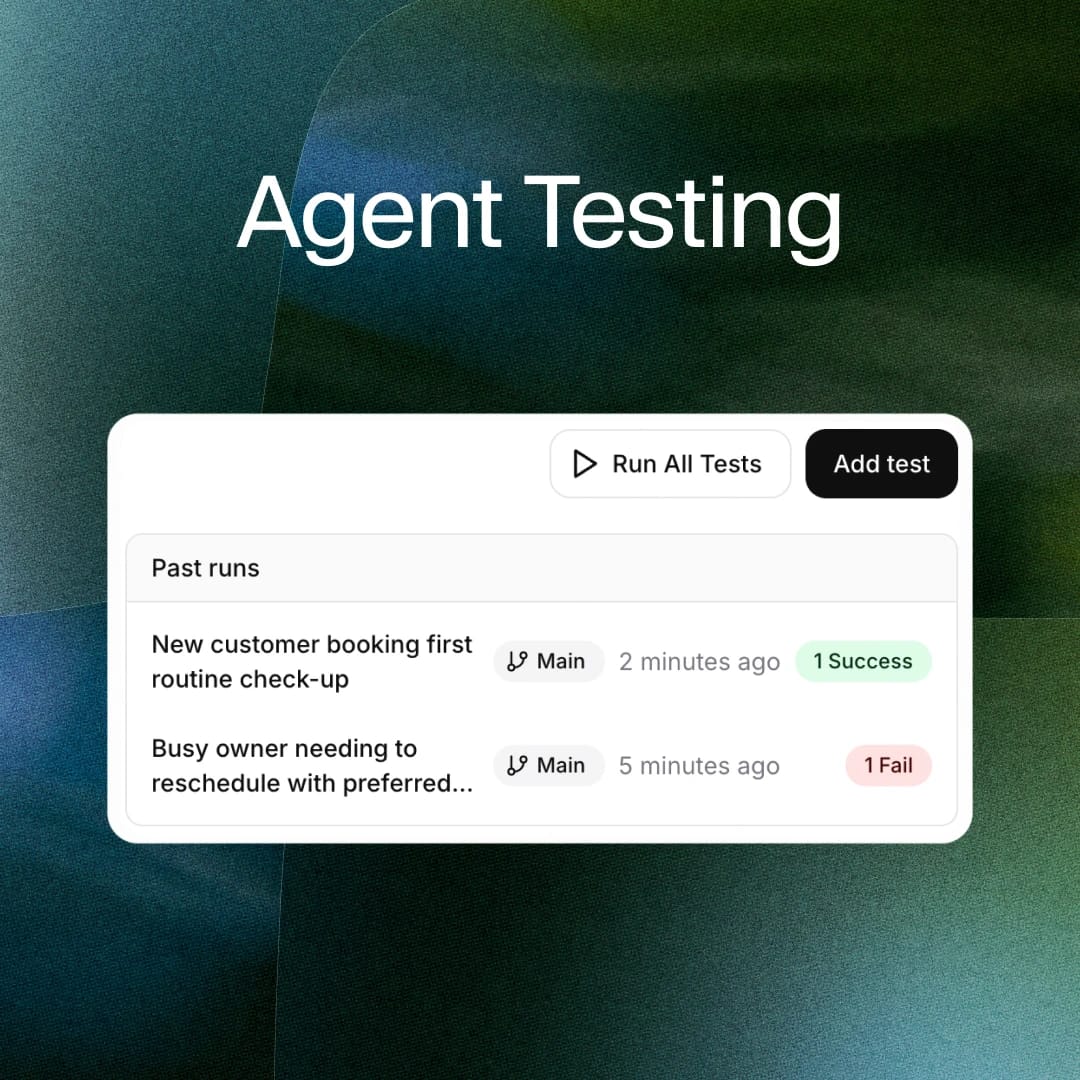
Simulações permitem executar uma conversa completa com várias interações com um usuário simulado antes de qualquer interação real. Você define o cenário, e o simulador conduz a conversa até a resolução, incluindo chamadas de ferramentas reais ou simuladas. Como você controla o usuário simulado, pode torná-lo hostil ou manipulador, para que o mesmo mecanismo que valida caminhos regulares também teste os adversariais.
Diversos recursos ampliam essa cobertura:
- Execuções repetidas executam um teste várias vezes, agrupando falhas por motivo para revelar padrões de erro e casos extremos.
- Testes de próxima resposta e invocação de ferramentas verificam respostas individuais e ações críticas.
- Testes específicos por canal verificam se um agente terá o desempenho esperado em todos os canais em que é disponibilizado, já que suas respostas podem ser ajustadas por canal (por exemplo, sendo conciso em uma ligação e detalhado em um e-mail).
- Red-teaming via API. Os testes também podem ser executados pela API com SDKs de red-teaming.
Avaliação e melhoria dos agentes após o lançamento
Quando você implanta seus agentes, as avaliações são executadas continuamente em conversas ao vivo. Com uma abordagem de LLM como avaliador, cada chamada pode ser avaliada automaticamente com base nos critérios que você definir. Você pode analisar os resultados das conversas em dashboards e investigar problemas usando registros detalhados que incluem transcrições pesquisáveis, fontes, chamadas de ferramentas e acionamentos de guardrails.
Quaisquer problemas encontrados em produção podem ser facilmente incorporados à suíte de testes. Quando uma alteração é proposta, você pode usar Experimentos para direcionar uma parte do tráfego ao vivo a uma variante e medir resultados reais antes de aplicá-la de forma ampla.
Recomendamos implantar em etapas. Direcione uma parcela limitada do tráfego para seu agente, avalie essas conversas e, depois de verificar que ele está funcionando como esperado, expanda para outros casos de uso, canais ou regiões.
Proteção de dados sensíveis
Os agentes podem processar detalhes de pagamento, informações de saúde e identificadores pessoais. Por isso, é importante considerar quais dados são armazenados, onde são armazenados e por quanto tempo.
Oferecemos diversos mecanismos para que os clientes protejam os dados:
- Modo de retenção zero pode ser ativado para serviços elegíveis, garantindo que certos tipos de dados não sejam retidos, e foi projetado para ambientes regulatórios exigentes.
- Redação do histórico de conversas remove entidades sensíveis após uma chamada, substituindo-as por placeholders no texto e bipes no áudio, até mesmo por tipos individuais de entidade.
- Retenção configurável alinha os períodos de armazenamento aos seus requisitos regulatórios.
- Residência de dados mantém o processamento dentro da jurisdição exigida.
- Implantações privadas (VPC) isolam o ambiente para cargas de trabalho altamente sensíveis.
- Criptografia protege os dados em trânsito e em repouso.
Proteções no nível da plataforma e validação externa
Tudo o que mencionamos acima se baseia em nossas proteções mais amplas no nível da plataforma, um programa abrangente que inclui procedência de conteúdo, detecção de abusos, aplicação de restrições de uso e red-teaming de modelos. Por meio do nosso Programa de Parcerias em Segurança, também trabalhamos com empresas na vanguarda da segurança em IA, contribuindo com seus produtos e com padrões emergentes do setor.
Também submetemos nossa abordagem à análise independente, incluindo padrões gerais de segurança e privacidade, como SOC 2 Type II, ISO 27001 e LGPD / Lei Geral de Proteção de Dados, além de certificações específicas por setor e caso de uso, como PCI DSS Level 1 para processamento de pagamentos e HIPAA para a área da saúde nos EUA. Consulte nossa central de confiança para mais informações.
Também atendemos a padrões mais recentes e nativos de IA, como a ISO 42001, que rege sistemas de gestão de IA, e AIUC-1 que exige que agentes de IA resistam a simulações adversariais trimestrais realizadas por avaliadores independentes. Os mesmos recursos por trás da AIUC-1 também possibilitam o acesso a algumas das primeiras apólices de seguro para agentes.
Para implementações grandes ou complexas, nossos Engenheiros de Implantação trabalham junto à sua equipe para projetar e implementar sua estratégia de agentes, incluindo configuração, guardrails, testes, monitoramento e estratégia de implantação.
Conclusão
Nossa abordagem de segurança no ElevenAgents é feita em camadas, e cada elemento reforça os demais:
- Configuração do agente: Prompts de sistema, workflows e procedimentos que moldam o comportamento, com as ações mais sensíveis restritas a chamadas de ferramentas.
- Guardrails: Verificações independentes em todas as etapas: detecção de manipulação na entrada, Focus na decisão e validadores de conteúdo e personalizados na saída, com estratégias de saída configuráveis.
- Testes: Simulações adversariais, execuções repetidas, testes específicos por canal e red-teaming antes do lançamento.
- Monitoramento: Implantação em etapas, seguida de avaliação contínua, registros e transcrições pesquisáveis e um ciclo de feedback após o lançamento.
- Proteção de dados: Redação, Modo de retenção zero, retenção configurável, residência de dados, implantações privadas (VPC) e criptografia.
- Validação externa: Certificações, testes adversariais independentes da AIUC-1, seguro para agentes, red-teaming e suporte especializado.