
Conversationele AI-agents testen
- Geschreven door
- Anna Neely
- Gepubliceerd
- Laatst bijgewerkt
LuisterenLuister naar dit artikel
Wanneer conversationele spraakagenten live gaan, hoe monitor je ze dan op schaal? Hoe merk je het wanneer ze niet doen wat ze moeten doen? En hoe test je ze nadat je wijzigingen hebt aangebracht?
Deze vragen hebben ons werk aan El, onze documentatieassistent die wordt aangedreven door Conversational AI. Naarmate El zich ontwikkelde, bouwden we een systeem om agents te monitoren, evalueren en testen, gebaseerd op evaluatiecriteria en gesprekssimulaties.
De basis leggen: betrouwbare evaluatiecriteria
Het verbeteren van een agent begint met begrijpen hoe deze zich in de praktijk gedraagt. Dat betekende dat we onze evaluatiecriteria moesten verfijnen en ervoor moesten zorgen dat ze nauwkeurig en betrouwbaar genoeg waren om de prestaties van agents te monitoren. We beschouwen een gesprek als mislukt wanneer de agent onjuiste informatie geeft of de gebruiker niet helpt zijn doel te bereiken.
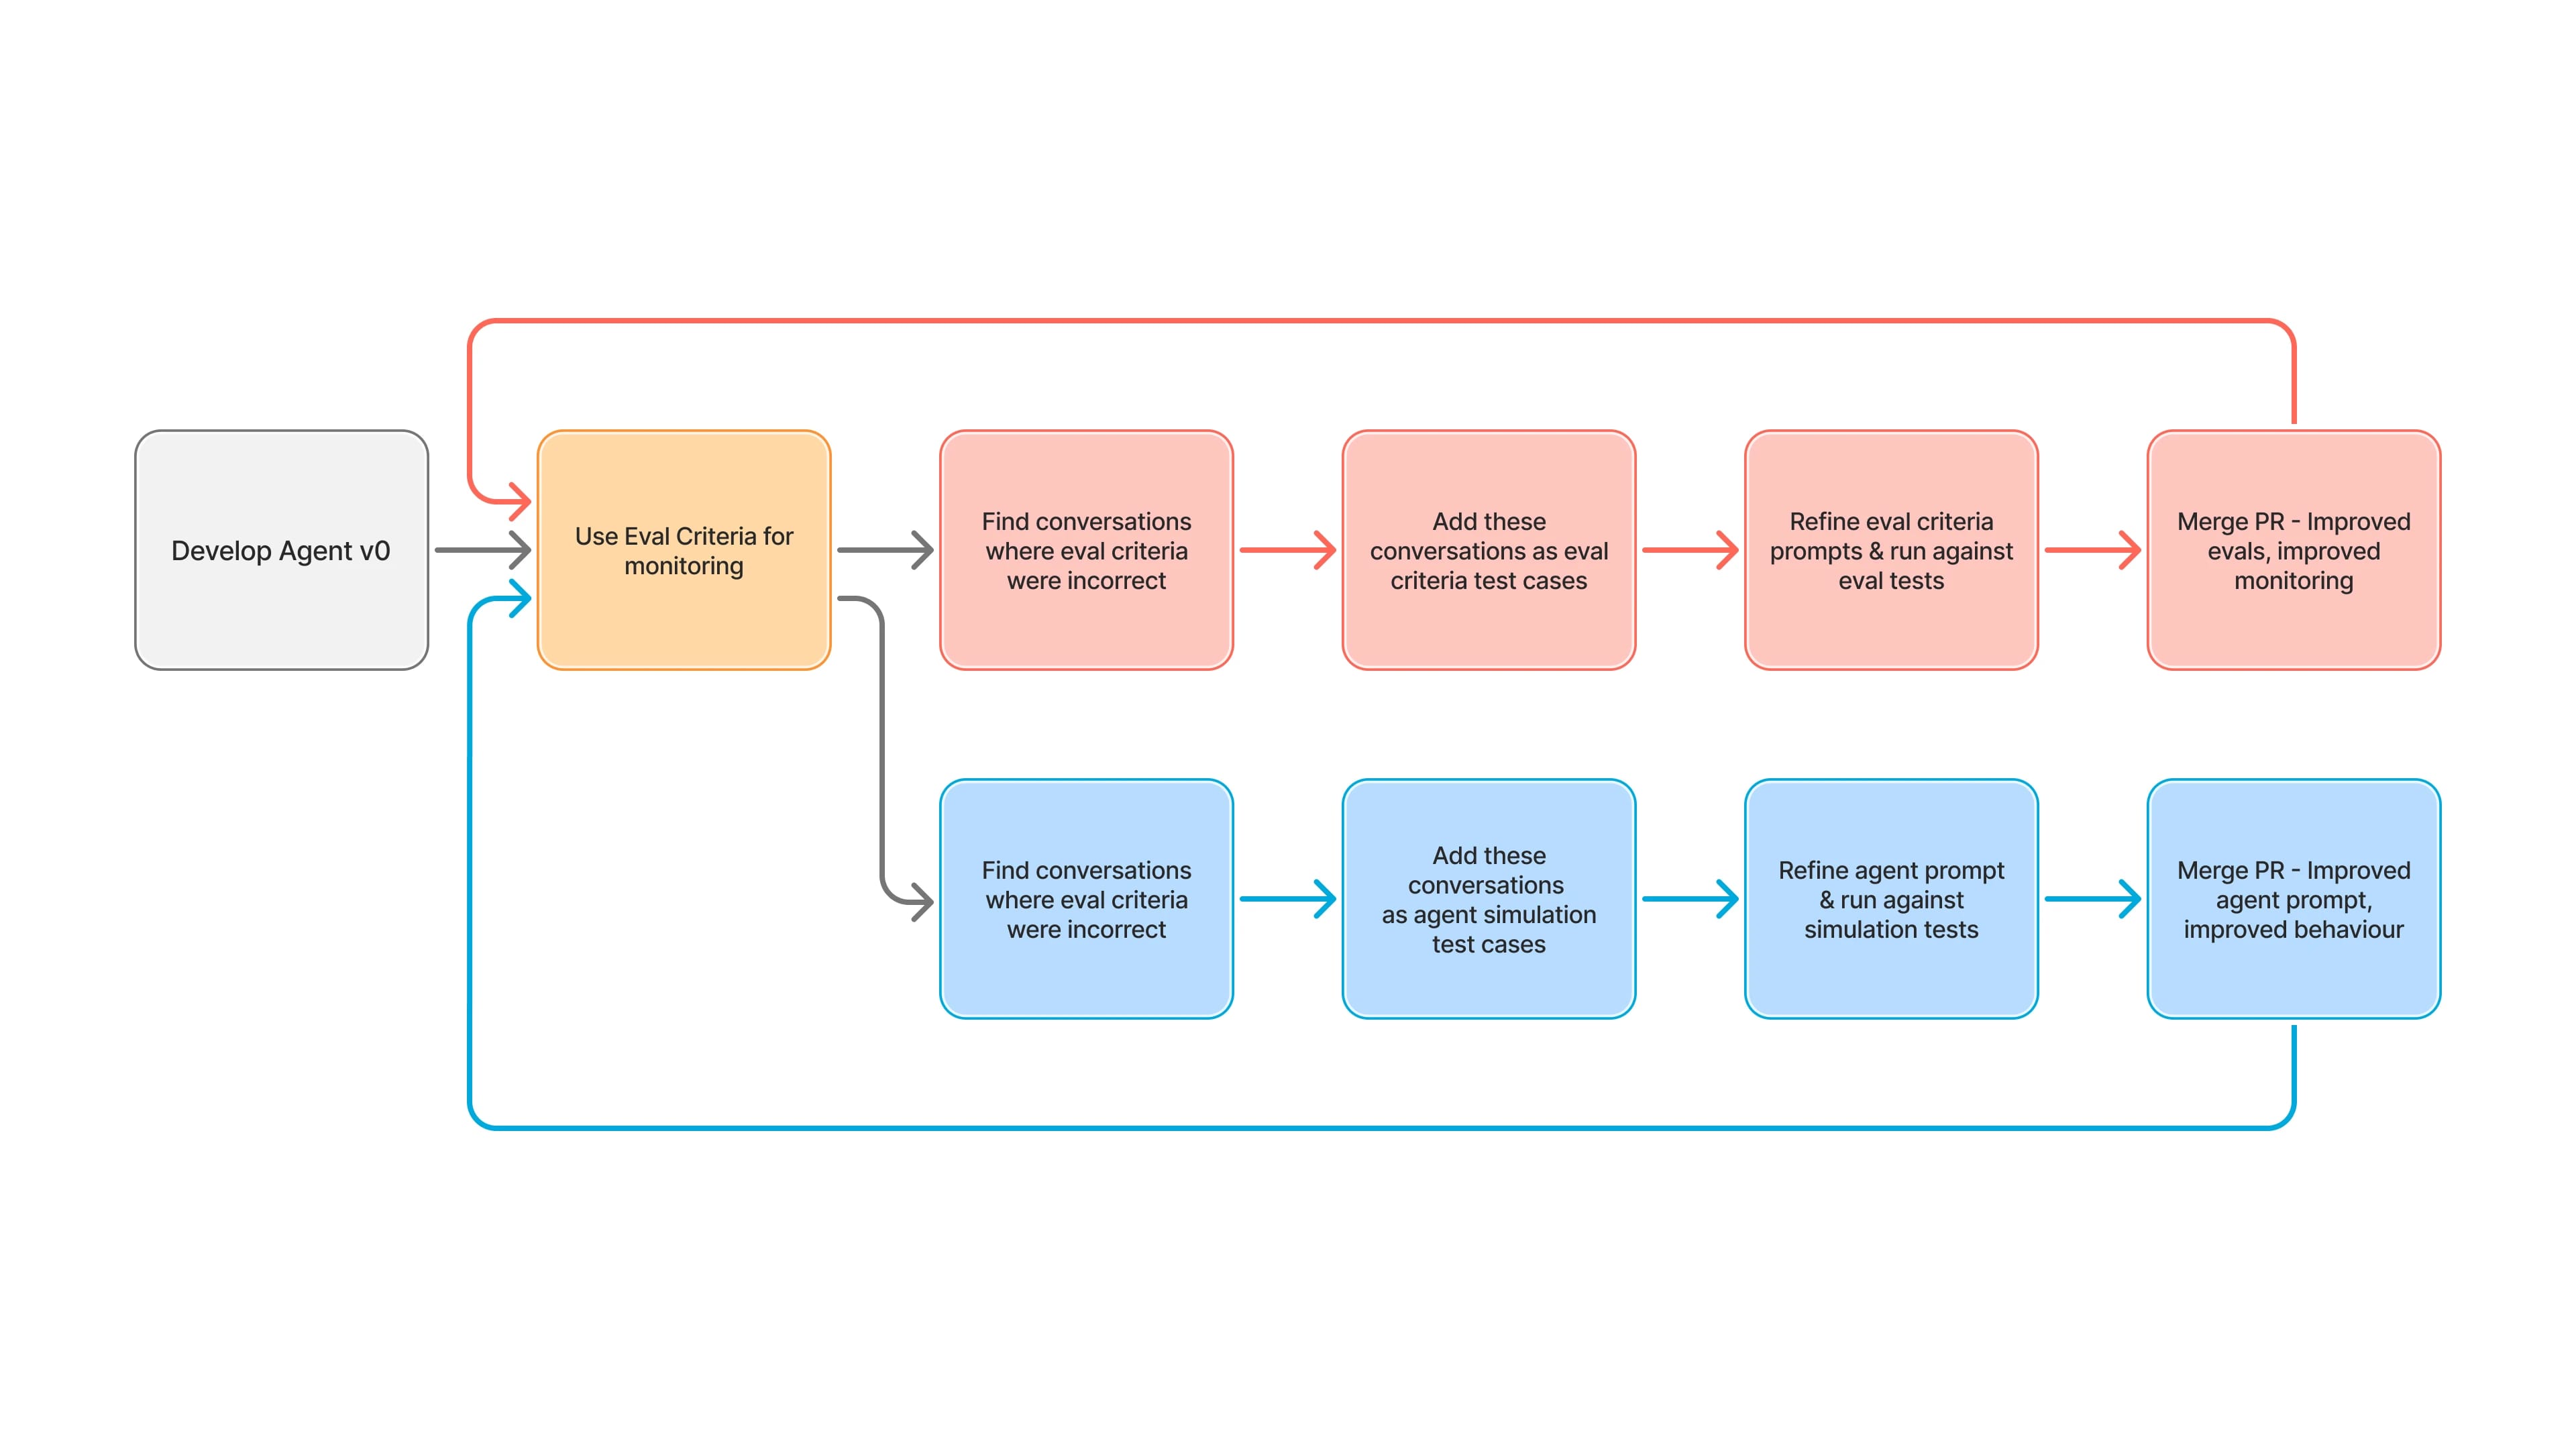
We hebben de volgende evaluatiecriteria ontwikkeld:
- Interactie: is dit een geldig gesprek, stelde de gebruiker relevante vragen en was het gesprek logisch?
- Positieve interactie: was de gebruiker tevreden, of was diegene verward of gefrustreerd?
- De hoofdoorzaak begrijpen: heeft de agent het onderliggende probleem van de gebruiker correct vastgesteld?
- De vraag van de gebruiker oplossen: heeft de agent het probleem van de gebruiker opgelost of een alternatieve ondersteuningsmethode geboden?
- Hallucinatie: heeft de agent informatie verzonnen die niet in de kennisbank staat?
Als interactie mislukt, is het gesprek zelf niet geldig. Als andere criteria niet worden gehaald, onderzoeken we dit verder. Dat onderzoek bepaalt hoe we de agent verbeteren. Soms gaat het om het verfijnen van toolgebruik of timing. Andere keren voegen we waarborgen toe om niet-ondersteunde acties te voorkomen.
Met vertrouwen itereren: Conversation Simulation API
Zodra we hebben vastgesteld wat we moeten verbeteren, is de volgende stap testen. Daar komt onze Conversation Simulation API bij kijken. Deze simuleert realistische gebruikersscenario's — zowel volledig als in gerichte segmenten — en evalueert de resultaten automatisch aan de hand van dezelfde criteria die we in productie gebruiken. De API ondersteunt tool mocking en aangepaste evaluaties, waardoor we specifieke gedragingen flexibel kunnen testen.
We gebruiken twee methoden:
- Volledige simulaties: Test volledige gesprekken van begin tot eind.
- Gedeeltelijke simulaties: Begin midden in een gesprek om beslismomenten of subflows te valideren. Dit is onze voorkeursmethode voor unit tests, waarmee we snel kunnen itereren en gericht kunnen debuggen.
Met duidelijke, gerichte scenario's kunnen we bepalen waarop de LLM wordt getest. Zo zorgen we voor dekking van edge cases, toolgebruik en fallbacklogica.
Automatiseren op schaal: tests opnemen in CI/CD
Het laatste onderdeel is automatisering. We gebruikten de open API's van ElevenLabs om evaluatie en simulatie in onze CI/CD-pipeline op te nemen en deze te verbinden met onze GitHub DevOps-flow. Elke update wordt automatisch getest vóór de deployment. Dit voorkomt regressies en geeft ons snel feedback over prestaties in de praktijk.
Resultaten: een sterkere, slimmere El
Dit proces heeft veranderd hoe we El bouwen en onderhouden. We hebben een feedbackloop gecreëerd die werkelijk gebruik koppelt aan gestructureerde evaluatie, gerichte tests en geautomatiseerde validatie. Daardoor kunnen we verbeteringen sneller en met meer vertrouwen uitbrengen.
En dit framework kunnen we nu toepassen op elke agent die we bouwen.
Anna Neely focuses on product strategy and partners with enterprise customers on solution design and implementation



