Vibe Draw bouwen: ElevenLabs combineren met FLUX Kontext voor beeldcreatie met spraak
- Geschreven door
- Ryan Morrison
- Gepubliceerd
- Laatst bijgewerkt
LuisterenLuister naar dit artikel
Spraakinterfaces veranderen de manier waarop we met AI communiceren. Wat als een afbeelding maken net zo eenvoudig was als hem hardop beschrijven?
Dat idee bracht me ertoe om Vibe Draw als weekendproject te bouwen. Het is een creatieve tool waarbij spraak centraal staat en die Voice AI van ElevenLabs combineert met FLUX Kontext van Black Forest Labs om gesproken prompts om te zetten in afbeeldingen.
FLUX Kontext vertegenwoordigt een nieuwe categorie beeldmodellen. Anders dan traditionele text-to-image-systemen ondersteunt Kontext zowel generatie als bewerking. Het kan nieuwe afbeeldingen maken op basis van prompts, bestaande afbeeldingen aanpassen en zelfs meerdere referentieafbeeldingen samenvoegen tot één resultaat.
Hoewel modellen zoals GPT-4o en Gemini 2 Flash multimodale mogelijkheden bieden, is FLUX Kontext speciaal ontwikkeld voor visuele bewerking van hoge kwaliteit. Tijdens tests kon ik afzonderlijke letters in gestileerde tekst wijzigen of een object verplaatsen — alleen door de wijziging te beschrijven.
Toen dacht ik: „Waarom zou je dit niet met spraak doen?” En welke betere basis is er dan de krachtige spraaktechnologie van ElevenLabs?
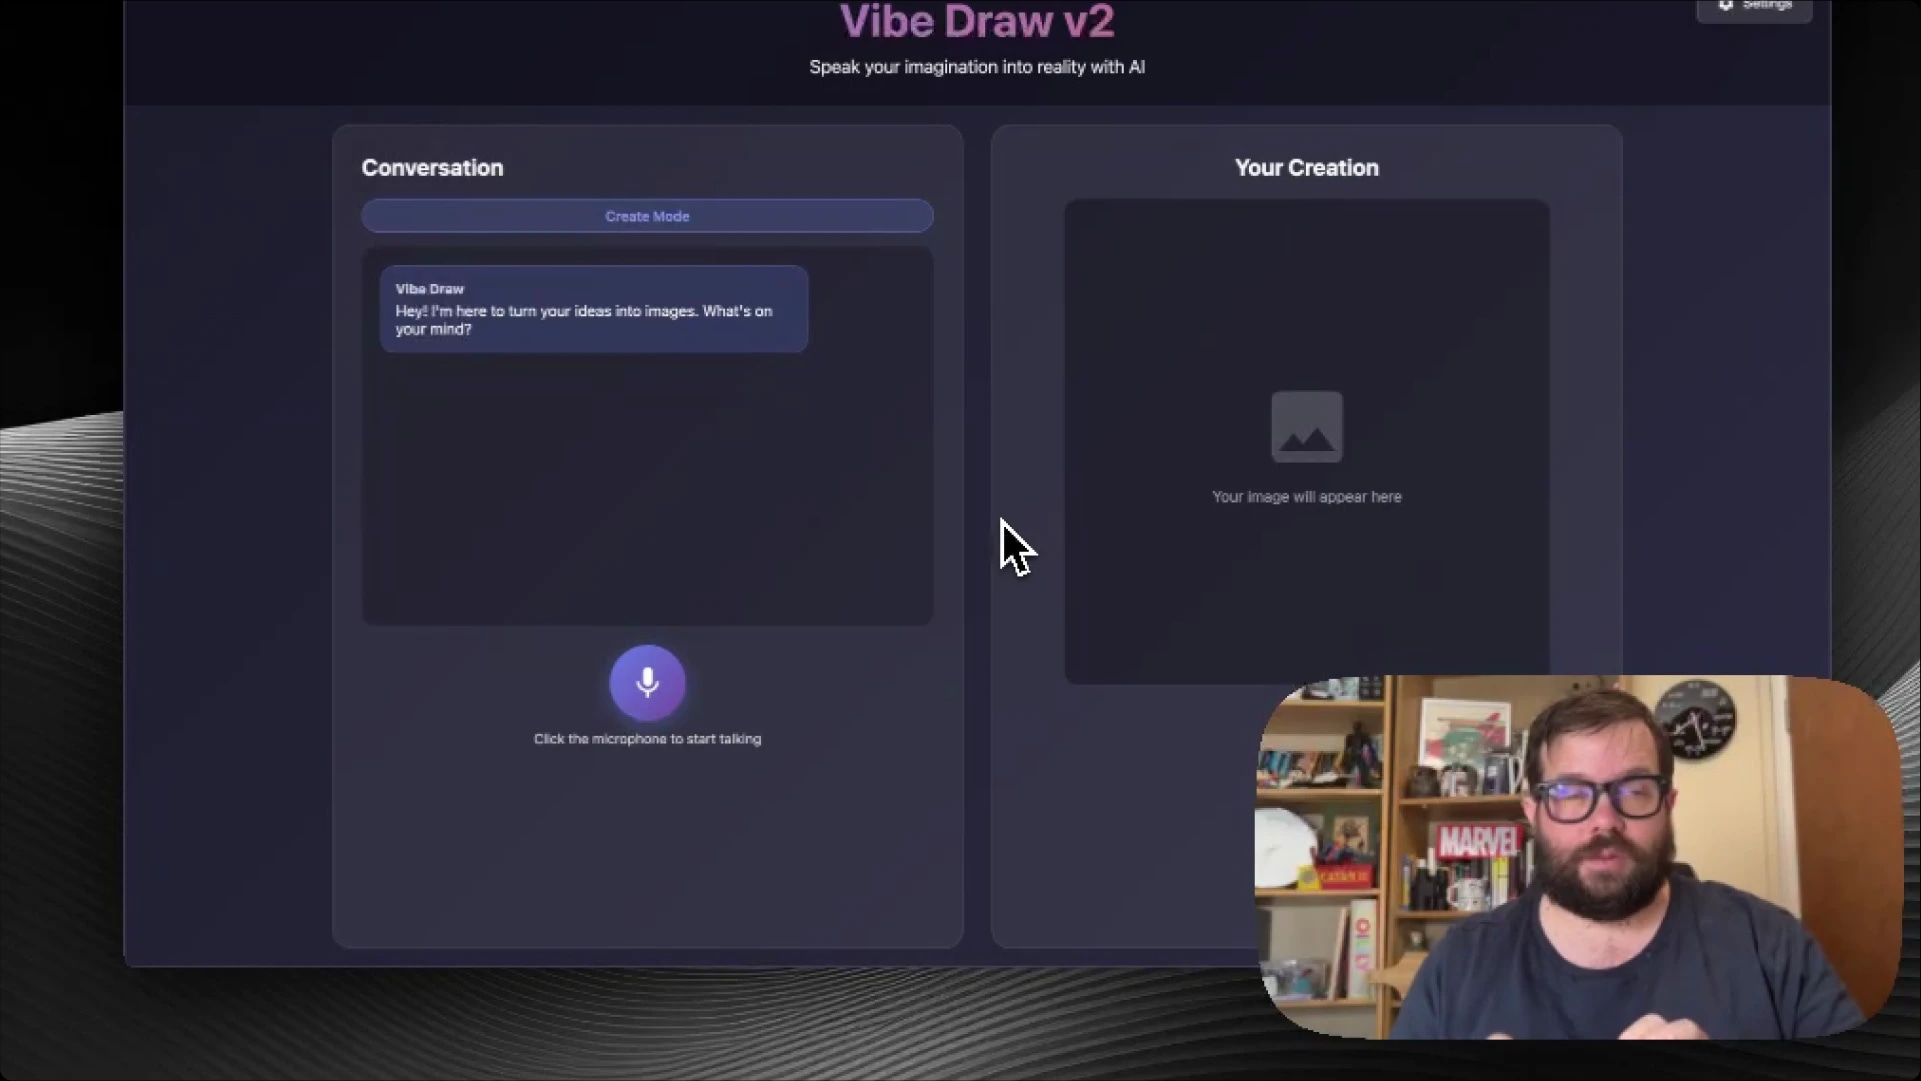
De technische uitdaging
Voor het bouwen van een beeldsysteem met spraak moesten vijf belangrijke problemen worden opgelost:
- Begrip van natuurlijke taal — Onderscheid maken tussen nieuwe creaties en bewerkingen
- Contextbewustzijn — Continuïteit behouden tussen interacties
- Audiobeheer — Overlappende reacties voorkomen en wachtrijen beheren
- Visuele generatie — Vloeiende overgangen tussen generatie en bewerking
- Gebruikerservaring — Geavanceerde AI-interacties intuïtief maken
Overzicht van de architectuur
Vibe Draw draait volledig client-side en integreert de volgende onderdelen:
- Web Speech API voor spraakherkenning
- ElevenLabs TTS-API voor spraakreacties
- FLUX Kontext API voor beeldgeneratie en -bewerking
- Aangepaste intentdetectie om gebruikersinvoer te begrijpen
Deze aanpak houdt het prototype lichtgewicht, maar voor de veiligheid moeten productie-implementaties requests via een server-side proxy laten lopen.
Spraak implementeren met ElevenLabs
Vibe Draw gebruikt de text-to-speech API van ElevenLabs, afgestemd op snelle reacties in gesprekken:
Voor afwisseling worden spraakreacties willekeurig geselecteerd uit vooraf gedefinieerde templates:
Audio afspelen beheren
Overlappende spraakreacties doorbreken de illusie van een gesprek. Vibe Draw lost dit op met een systeem voor audiowachtrijen:
Elk bericht wordt volledig afgespeeld voordat het volgende wordt gestart.
Intentdetectie en contextbeheer
Het systeem gebruikt detectie van trefwoorden en context om te bepalen of een gebruikersprompt een nieuw beeldverzoek of een bewerking is:
Deze aanpak zorgt ervoor dat bewerkingen alleen worden toegepast als er al een afbeelding is en de context dat duidelijk maakt.
Beeldgeneratie met FLUX Kontext
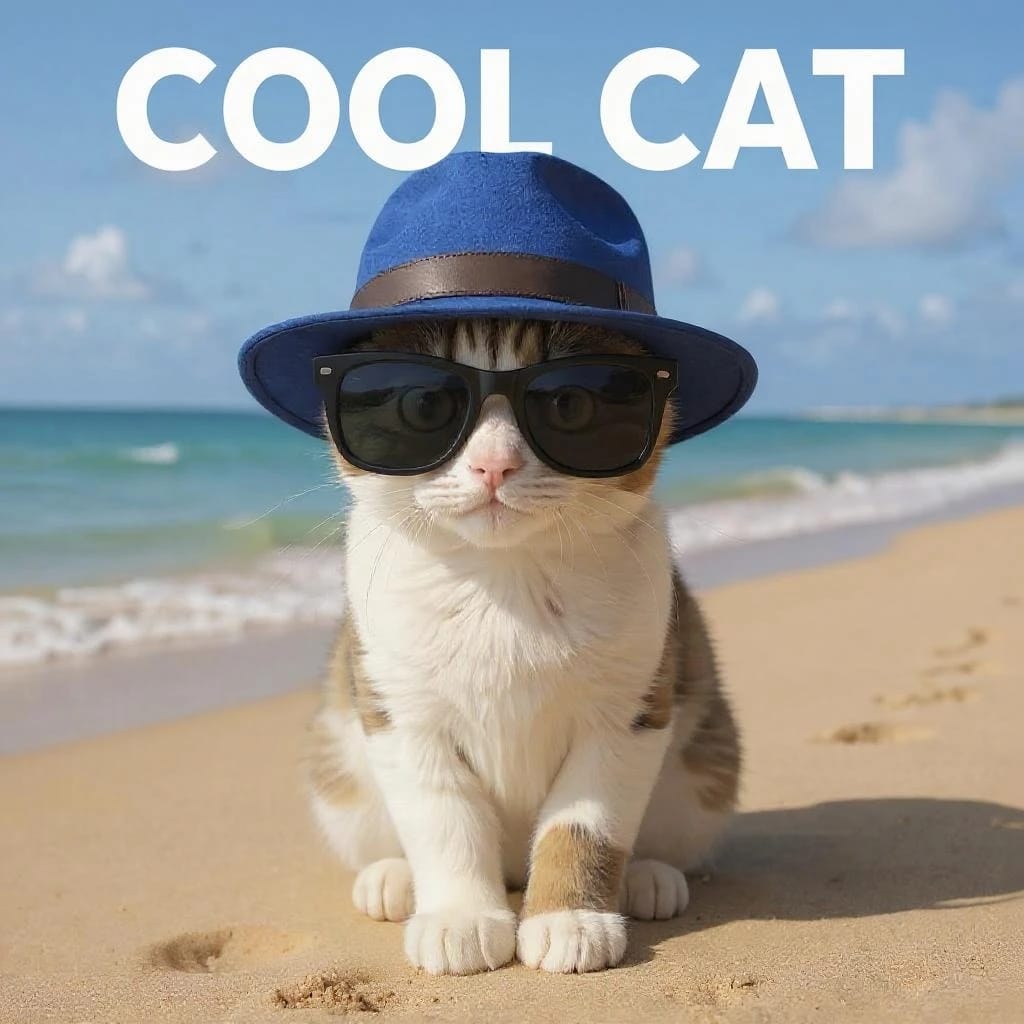
Kontext ondersteunt twee modi: generatie en bewerking.
Generatie (text to image)
Bewerking (contextuele transformatie)
Complexe transformaties afhandelen
Sommige prompts impliceren wijzigingen die de limieten van de bewerkings-API overschrijden. Als dit wordt gedetecteerd, biedt het systeem een alternatief:
De ervaring optimaliseren
Progressieve feedback
UI-feedback helpt gebruikers de status van het systeem te volgen:
Slimme timing
Een natuurlijk gesprek vereist natuurlijke timing:
Sessiestatus
Om de context te behouden, worden sessiegegevens opgeslagen:
Overwegingen voor prestaties
Voor een snelle respons:
- Lazy loading — API's alleen initialiseren wanneer dat nodig is
- Debouncing — API-requests per interactie beperken
- Foutafhandeling — Soepel herstellen van time-outs of fouten
- Resources opruimen — Audio-objecten en event listeners correct verwijderen
Wat volgt
Conversationele UI's openen de deur naar nieuwe mogelijkheden:
- Multimodale invoer — „Laat het meer op deze foto lijken.”
- Samenwerkende sessies — Meerdere gebruikers dragen bij aan één ontwerp
- Stijlgeheugen — Het systeem leert je esthetiek na verloop van tijd kennen
- Realtime streaming — Beeldupdates streamen terwijl de gebruiker spreekt en Conversational AI integreren voor gestreamde spraak.
Belangrijkste conclusies
Het bouwen van Vibe Draw bracht verschillende kernprincipes voor tools waarbij spraak centraal staat aan het licht:
- Context is alles — Het bijhouden van de status maakt interacties samenhangend
- Timing geeft persoonlijkheid — Het tempo van reacties zorgt dat AI responsief aanvoelt
- Alternatieven houden de vaart erin — Bied alternatieven wanneer generatie mislukt
- Variatie houdt het fris — Dezelfde zin herhalen doorbreekt de onderdompeling
Conclusie
Vibe Draw laat zien wat er gebeurt wanneer conversationele stem-AI visuele creativiteit ontmoet. De natuurlijke spraaksynthese van ElevenLabs en de beeld-API's van FLUX Kontext vormen samen een nieuwe manier om te creëren — geen klikken, geen sliders, alleen spraak.
Wanneer creëren net zo eenvoudig is als beschrijven, nemen we de barrières tussen verbeelding en uitvoering weg.
Probeer het zelf
De volledige broncode is beschikbaar op GitHub. Zo voer je je eigen versie uit:
- Kloon de repository
- Voeg je ElevenLabs API-sleutel toe
- Voeg je FAL.ai API-sleutel toe
- Open vibe-draw-v2.html in een moderne browser
- Klik op de microfoon en begin met creëren
Wil je je eigen ervaring bouwen waarbij spraak centraal staat? Bekijk ElevenLabs Conversational AI of neem contact met ons op.
Ryan joined ElevenLabs after more than two decades in news and publishing, including roles at the BBC and Future Plc. He focuses on content strategy and storytelling, helping ElevenLabs shape and share its narrative.