
会話型AIのレイテンシーとは?影響する要因を解説
- 公開日
- 最終更新日
聴くこの記事を聴く
会話型AIでは会話型AIのレイテンシーが、良いアプリケーションと優れたアプリケーションを分けます。
会話型AIは、本質的に理想を目指すものです。人と会話するときと同じ感覚を再現し、同様の感情表現の幅、ピッチ、話すリズムを模倣しようとします。話し終えてからAIエージェントが応答を始めるまでの「自然な」間を加味すれば、人間が実際にどのようにコミュニケーションを取るかに基づいたレイテンシーの目標が見えてきます。
大規模に会話型AIエージェントを導入する企業は、この自然な感覚を実現するために、可能な限りレイテンシーを抑える必要があります。この記事では、会話型AIのレイテンシーとは何か、パイプライン全体で遅延が発生する原因、そしてそれらを減らす方法の概要を解説します。
概要
- 会話型AIのレイテンシーとは、ユーザーが話し終えてからエージェントの最初の言葉を聞くまでの、エンドツーエンドの合計遅延です。
- 700msを超えるエージェントは不自然に感じられることがあり、1,200msを超えると離脱率が高くなります。
- レイテンシーは、会話型AIパイプラインのすべての段階で蓄積します。
- ElevenAgentsは、統合された単一のアーキテクチャでパイプライン全体を処理し、低レイテンシーの会話型AIをビジネスで利用しやすくします。
会話型AIのレイテンシーとは?
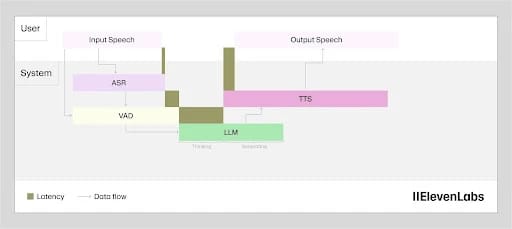
会話型AIのレイテンシーとは、話しかけた後にシステムが応答するまでにかかる合計時間です。最新のAIモデルでは、レイテンシーはms単位で測定されます。実際には、この合計レイテンシーはいくつかの独立した処理で構成され、それぞれがエンドツーエンドのパイプラインの一部を担っています。
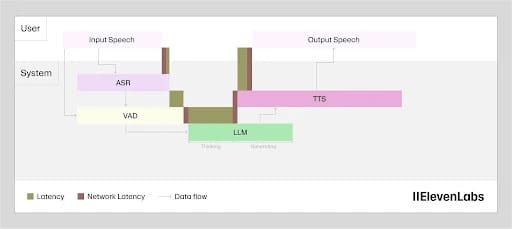
一般的な会話型AIのパイプラインは次のとおりです。
- ユーザーが話す
- スピーチtoテキストモデルがオーディオを文字起こしする
- 文字起こし結果がLLMに渡され、応答が生成される
- 次に、LLMのテキストがテキスト読み上げモデルによってオーディオに合成される
- オーディオがユーザーに再生される
これらの段階はすべて、会話型AIシステムにレイテンシーを追加します。そのため、レイテンシーを議論する際には、いくつかの略語を区別して理解する必要があります。
モデル推論レイテンシー
モデル推論レイテンシーとは、外部要因を除外して内部で測定した、モデルが出力を生成するのに費やす時間です。一般的な入力に対してエンジンがどれだけ速く動作するかを示す、モデル固有の指標です。たとえば、Flash v2.5のモデル推論レイテンシーは約75msです。この数値があれば、競合他社のモデルとの速度比較ができます。
ただし、これはユーザーが実際に体験するレイテンシーではないことを覚えておいてください。あくまでモデルが出力生成に費やす合計時間に特化した数値です。
LLMの初回トークン生成時間
大規模言語モデル(LLM)の初回トークン生成時間(TTFT)とは、LLMがプロンプトを処理し、使用可能な最初の出力トークンを生成するまでの合計時間です。
TTSの生成はLLMから最初のトークンが届くと始まるため、LLMがTTSモデルの実行を開始させるまでにかかる時間の指標となります。多くのエンドツーエンド会話型AIシステムでは、LLMのTTFTが総レイテンシーの大きな割合を占めます。
TTSの初回オーディオ生成時間(TTFA)
TTSの初回オーディオ生成時間(TTFA)は、最初のTTSリクエストから、最初のオーディオチャンクが実際にモデルから出力されるまでの時間を測定します。モデル推論レイテンシーを表す方法の一つですが、TTSエンジンに特化したものです。
エンドツーエンドの初回オーディオ生成時間(TTFA)
エンドツーエンドのTTFAは、会話型AIの総レイテンシーです。これは、音声認識、LLMのTTFT、TTS、TTFA、各ステップ間のすべてのネットワーク転送を含む、パイプラインのあらゆる部分の合計です。会話型AIのレイテンシー全体を考える際、これがユーザーが体感する指標です。
ユーザーが話すと、エージェントから何か聞こえるまで、エンドツーエンドのTTFAを待つことになります。これは包括的な指標であり、パイプラインのどの部分を改善しても向上します。
会話型AIのレイテンシーが重要な理由
ユーザーがAIエージェントと話すとき、レイテンシーはその体験をどう評価するかを左右する重要な要素になります。レイテンシーが低いほど応答を待つ時間が短くなり、会話が自然に感じられ、エージェントも有能に見えます。
レイテンシーが高いエージェントは、応答の品質が同じでも、人工的で能力が低いように感じられます。企業にとっては、わずか数百msの差でも永遠のように感じられ、カスタマーサポートエージェントが扱いにくく、効果のないものに見えてしまいます。
会話型AIのレイテンシーが実際に重要となる理由を示す、いくつかのシナリオをご紹介します。
- 500ms未満:会話型エージェントは、応答性が高くスムーズに感じられます。ユーザーは話し終えてから最初の応答を受け取るまでの遅延に気付かないこともあり、会話は自然に進みます。
- 500ms~1,000ms:ユーザーが話し終えてから応答を受け取るまでの遅れを、はっきりと感じるようになる場合があります。わずかに長すぎるため、ユーザーは先回りして同じことを繰り返したり、エージェントが本当に理解したか確認するために間を置いたりするかもしれません。
- 1,000ms超:遅延が遅いと感じられ始め、間が空くことで、AIエージェントが会話に十分ついてきていないと感じるユーザーもいます。文字起こしには、時折の割り込みや人間のエージェントとの会話を求める発言が見られることがあります。場合によっては、ユーザーが通話を中断することもあります。
これらのしきい値はすべて、実際のビジネス成果につながります。
レイテンシースペクトラムの低い側では、追加の支援なしに自然に問い合わせに対応し、ユーザーの問題解決を支援できるカスタマーサービスエージェントを実現できます。人間のエージェントの負担を軽減し、顧客満足度を高く保てます。一方、レイテンシースペクトラムの高い側では、あまりに長くためらっているように見えるエージェントによって、顧客を苛立たせることになります。
別の記事では、音声エージェントのレイテンシーバジェットベンチマークを定義し、P50とP95の両方で優れたレイテンシーがどのようなものかを示しています。
会話型AIのレイテンシーの原因は?
会話型AIのレイテンシーは、複数の異なる処理をまとめた用語であり、各セグメントが全体に影響します。そのため、低レイテンシーを妨げるボトルネックは、単により優れたモデルを選ぶだけで解決できるものではなく、システムレベルの問題です。結局のところ、パイプラインでは複数のモデルが連携します。
デベロッパー向けに、エンドツーエンドの初回オーディオ生成時間(TTFA)の各段階を改善するための詳細な技術ガイド「音声エージェントのレイテンシー最適化」を用意しています。
コアパイプライン以外にも、テレフォニーや関数呼び出しなどの要因がレイテンシーを追加します。これらはモデルインフラストラクチャの内部要素ではありません。
会話型AIのレイテンシーに影響するすべての要因を見ていきましょう。
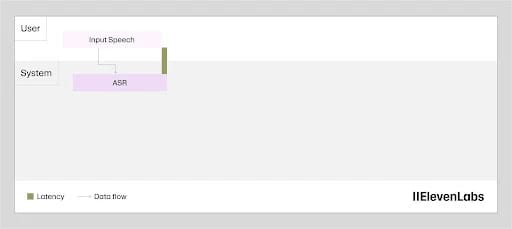
自動音声認識
音声認識のレイテンシーは、文字起こしを生成するまでの時間ではありません。文字起こし処理はユーザーが話している間にバックグラウンドで実行されるため、発話が終わる頃にはテキストの大部分が準備できています。
ここでのレイテンシーとは、実際には発話が終わってから文字起こしが確定し、次の段階に渡されるまでの間隔です。Scribe v2 Realtimeは継続的にストリーミングすることで、このギャップを約150msまで短縮し、ターンが終わった瞬間に出力を利用可能にします。
ターンテイキングとエンドポインティング
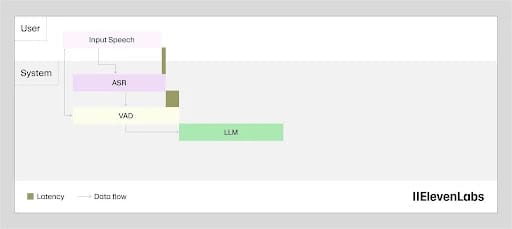
音声認識と語学モデルの間には、Voice Activity Detector(VAD)が配置されます。その役割は、ユーザーが実際に話し終えたタイミングを判断することです。
エラーを避けるため、VADは一定時間の無音状態を待ってからターンの終了を判断します。この待機時間は、言語モデルが単語を処理する前に追加されるレイテンシーです。このわずかな追加レイテンシーは時間を要しますが、ユーザーがまだ話している間にシステムが応答を始めることを防ぎます。
技術的に言えば、他のすべての会話型AIコンポーネントのレイテンシーがゼロなら、ターンテイキングに起因するレイテンシーは良いものです。人間は発話に応答する前に少し間を取ります。機械が同様に間を取ることで、やり取りにリアリティが生まれます。ただし、会話型AIの他のコンポーネントですでにレイテンシーが発生するため、最小限のレイテンシーが理想的です。
言語モデルの処理
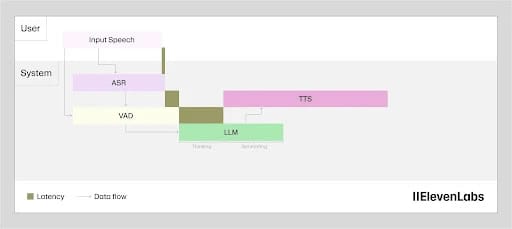
スピーチtoテキスト(STT)エンジンから文字起こし結果が準備されると、言語モデルが応答を生成します。ここでのレイテンシーは、完全な応答の生成時間ではなく、トークンの生成を開始するまでの時間です。トークンは到着次第直接TTS段階へストリーミングされるため、最も重要なのはTTFTです。
モデルの選択以外にも、プロンプトの長さとナレッジベースの規模の両方がこの段階に影響します。LLMが考慮するコンテキストが多いほど、時間がかかります。こうしたシステムを大規模に設計する際は、高速性を保つために、有用なナレッジベースと簡潔なプロンプトの適切なバランスを取る必要があります。
音声合成
TTSのレイテンシーとは、言語モデルから最初のトークンを受け取ってからオーディオが始まるまでの時間です。トークンは人間の音声が再生されるよりも速く届くため、合成モデルが完全な応答を待つことはありません。TTSのレイテンシーは厳密には、最初のオーディオチャンクまでの時間です。
この段階は以前、会話型AIのレイテンシーに最も大きく影響する要因であり、古いモデルでは音声生成の開始までに2~3秒かかっていました。ElevenLabsのFlash v2.5はこの問題を直接解決し、約75msのレイテンシーで音声合成を提供することで、数秒かかっていたボトルネックを1秒未満に短縮します。
ネットワークレイテンシー
データをある場所から別の場所へ送信すると、必ずレイテンシーが追加されます。地理的な距離が離れるほど、ネットワークの往復レイテンシーはさらに増大します。
エンドツーエンドの応答には複数のコンポーネントが連携するため、複数回のネットワークホップを通じて大きなレイテンシーが蓄積する可能性があります。
関数呼び出し
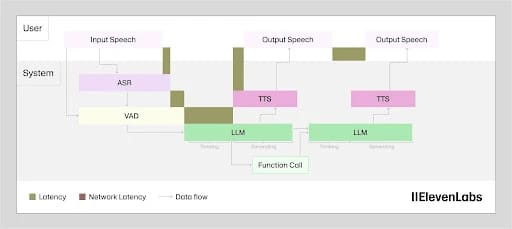
関数呼び出しは、LLMの段階でAPIの往復通信を追加します。高速な内部検索では数十ミリ秒が追加されますが、決済処理システムや在庫管理システムでは数秒かかることもあります。レイテンシーの大きさは呼び出すサービスに完全に依存するため、これが直接最適化するのが最も難しい段階です。
最も効果的なパターンは、ツール呼び出しが完了する前にLLMへ応答を促すことです。「確認しますね」のようなフレーズを使えば、無音のままにするのではなく、外部呼び出しの解決中もユーザーの関心を保てます。ツールが並行して実行されている間に、音声応答が始まります。
会話型AIのレイテンシーを減らす方法
会話型AIのレイテンシーを減らすには、影響度の高い順にパイプラインの各段階へ対処する必要があります。個別の改善もレイテンシーに影響しますが、最大の変化を得るにはパイプライン全体に包括的に取り組む必要があります。
会話型AIのレイテンシーを大まかに削減するための指針をいくつか紹介します。
- TTSモデルの選択:Flash v2.5のように速度向けに最適化されたTTSモデルは、Eleven v3 とEleven v4。リアルタイムの音声エージェントでは、レイテンシーの目標を満たす最高品質のモデルが適切な選択であり、ほとんどの場合は速度向けに最適化されたモデルです。
- LLMモデルの選択:一般に、小さく高速なLLMは、大きなモデルよりも初回トークン生成時間が短くなります。タスクに求める品質基準を満たす最速のLLMを選ぶことは、TTSモデルの選択と同じくらい重要です。
- ストリーミング:ストリーミングTTSは、合成の進行に合わせてオーディオをチャンク単位で返すため、モデルが残りを生成している間にユーザーは最初の言葉を聞けます。この考え方はLLMの出力にも適用されます。言語モデルが続く文を生成している間に最初の文からTTS合成を始めることで、パイプラインのレイテンシーを取り戻せます。
- システムプロンプトの設計:ユーザーは、システムプロンプトを簡素化できます。すべての意思決定ステップに含めるのではなく、指示を手順やワークフローに移すことで実現します。これにより、モデルが各ターンで推論する必要があるコンテキスト量を減らせます。
- ガードレール:ガードレールをストリーミングモデルで実行すると、チェックの完了まで再生をブロックするのではなく、ガードレールチェックが完了する前に出力の再生を開始できます。
- モデルのコロケーション:ElevenLabs Agentsスタックのように、可能な限りモデルを同じ場所に配置することで、コンポーネント同士を近くに保ち、個別にホストされたモデル間のホップによるレイテンシーを防げます。
- 地理的な近接性:サーバーとユーザーの距離を近づけることで、エンドツーエンドTTFAにおけるネットワークの影響を直接削減し、レイテンシーを大幅に抑えられます。
これらの要因に加えて、より詳しくは「レイテンシー最適化の技術ガイド」をご覧ください。
ElevenAgentsで低レイテンシーの会話型AIを始めましょう
会話型AIのレイテンシーは、エージェントの構築と導入において非常に重要な検討事項です。ElevenAgentsでは、レイテンシー最適化がプロセスに組み込まれています。時間を取り戻すためのオーバーラップ技術から、各コンポーネントの低いモデル推論レイテンシーまで、ElevenAgentsはビジネス向けの低レイテンシー会話型AIスタックを構築します。
最終的な目標は、リアリティを生み出すことです。ユーザーはコンピュータープログラムの利点を得ながら、人と話す気軽さを感じる必要があります。各サブプロセスを短縮することで、これは今や実現可能です。
ElevenAgentsの詳細をご覧いただくか、営業にお問い合わせのうえ、今すぐ始めましょう。
会話型AIのレイテンシーに関するよくある質問

Jack LimebearはGrowthチームに所属し、ブログやインサイトページのコンテンツライター兼ストラテジストとして活躍しています。ElevenLabsに入社する前は、急成長中のSaaSスタートアップからFortune 500企業まで、さまざまな組織で10年以上にわたりコンテンツ戦略をリードしてきました。ケンブリッジ大学で英文学の修士号を取得しています。




