Tester les agents IA conversationnels
- Rédigé par
- Anna Neely
- Publié
- Dernière mise à jour
ÉcouterÉcouter cet article
Lorsque des agents vocaux conversationnels sont mis en production, comment les surveiller à grande échelle ? Comment détecter les écarts par rapport au comportement attendu ? Et après avoir apporté des modifications, comment les tester ?
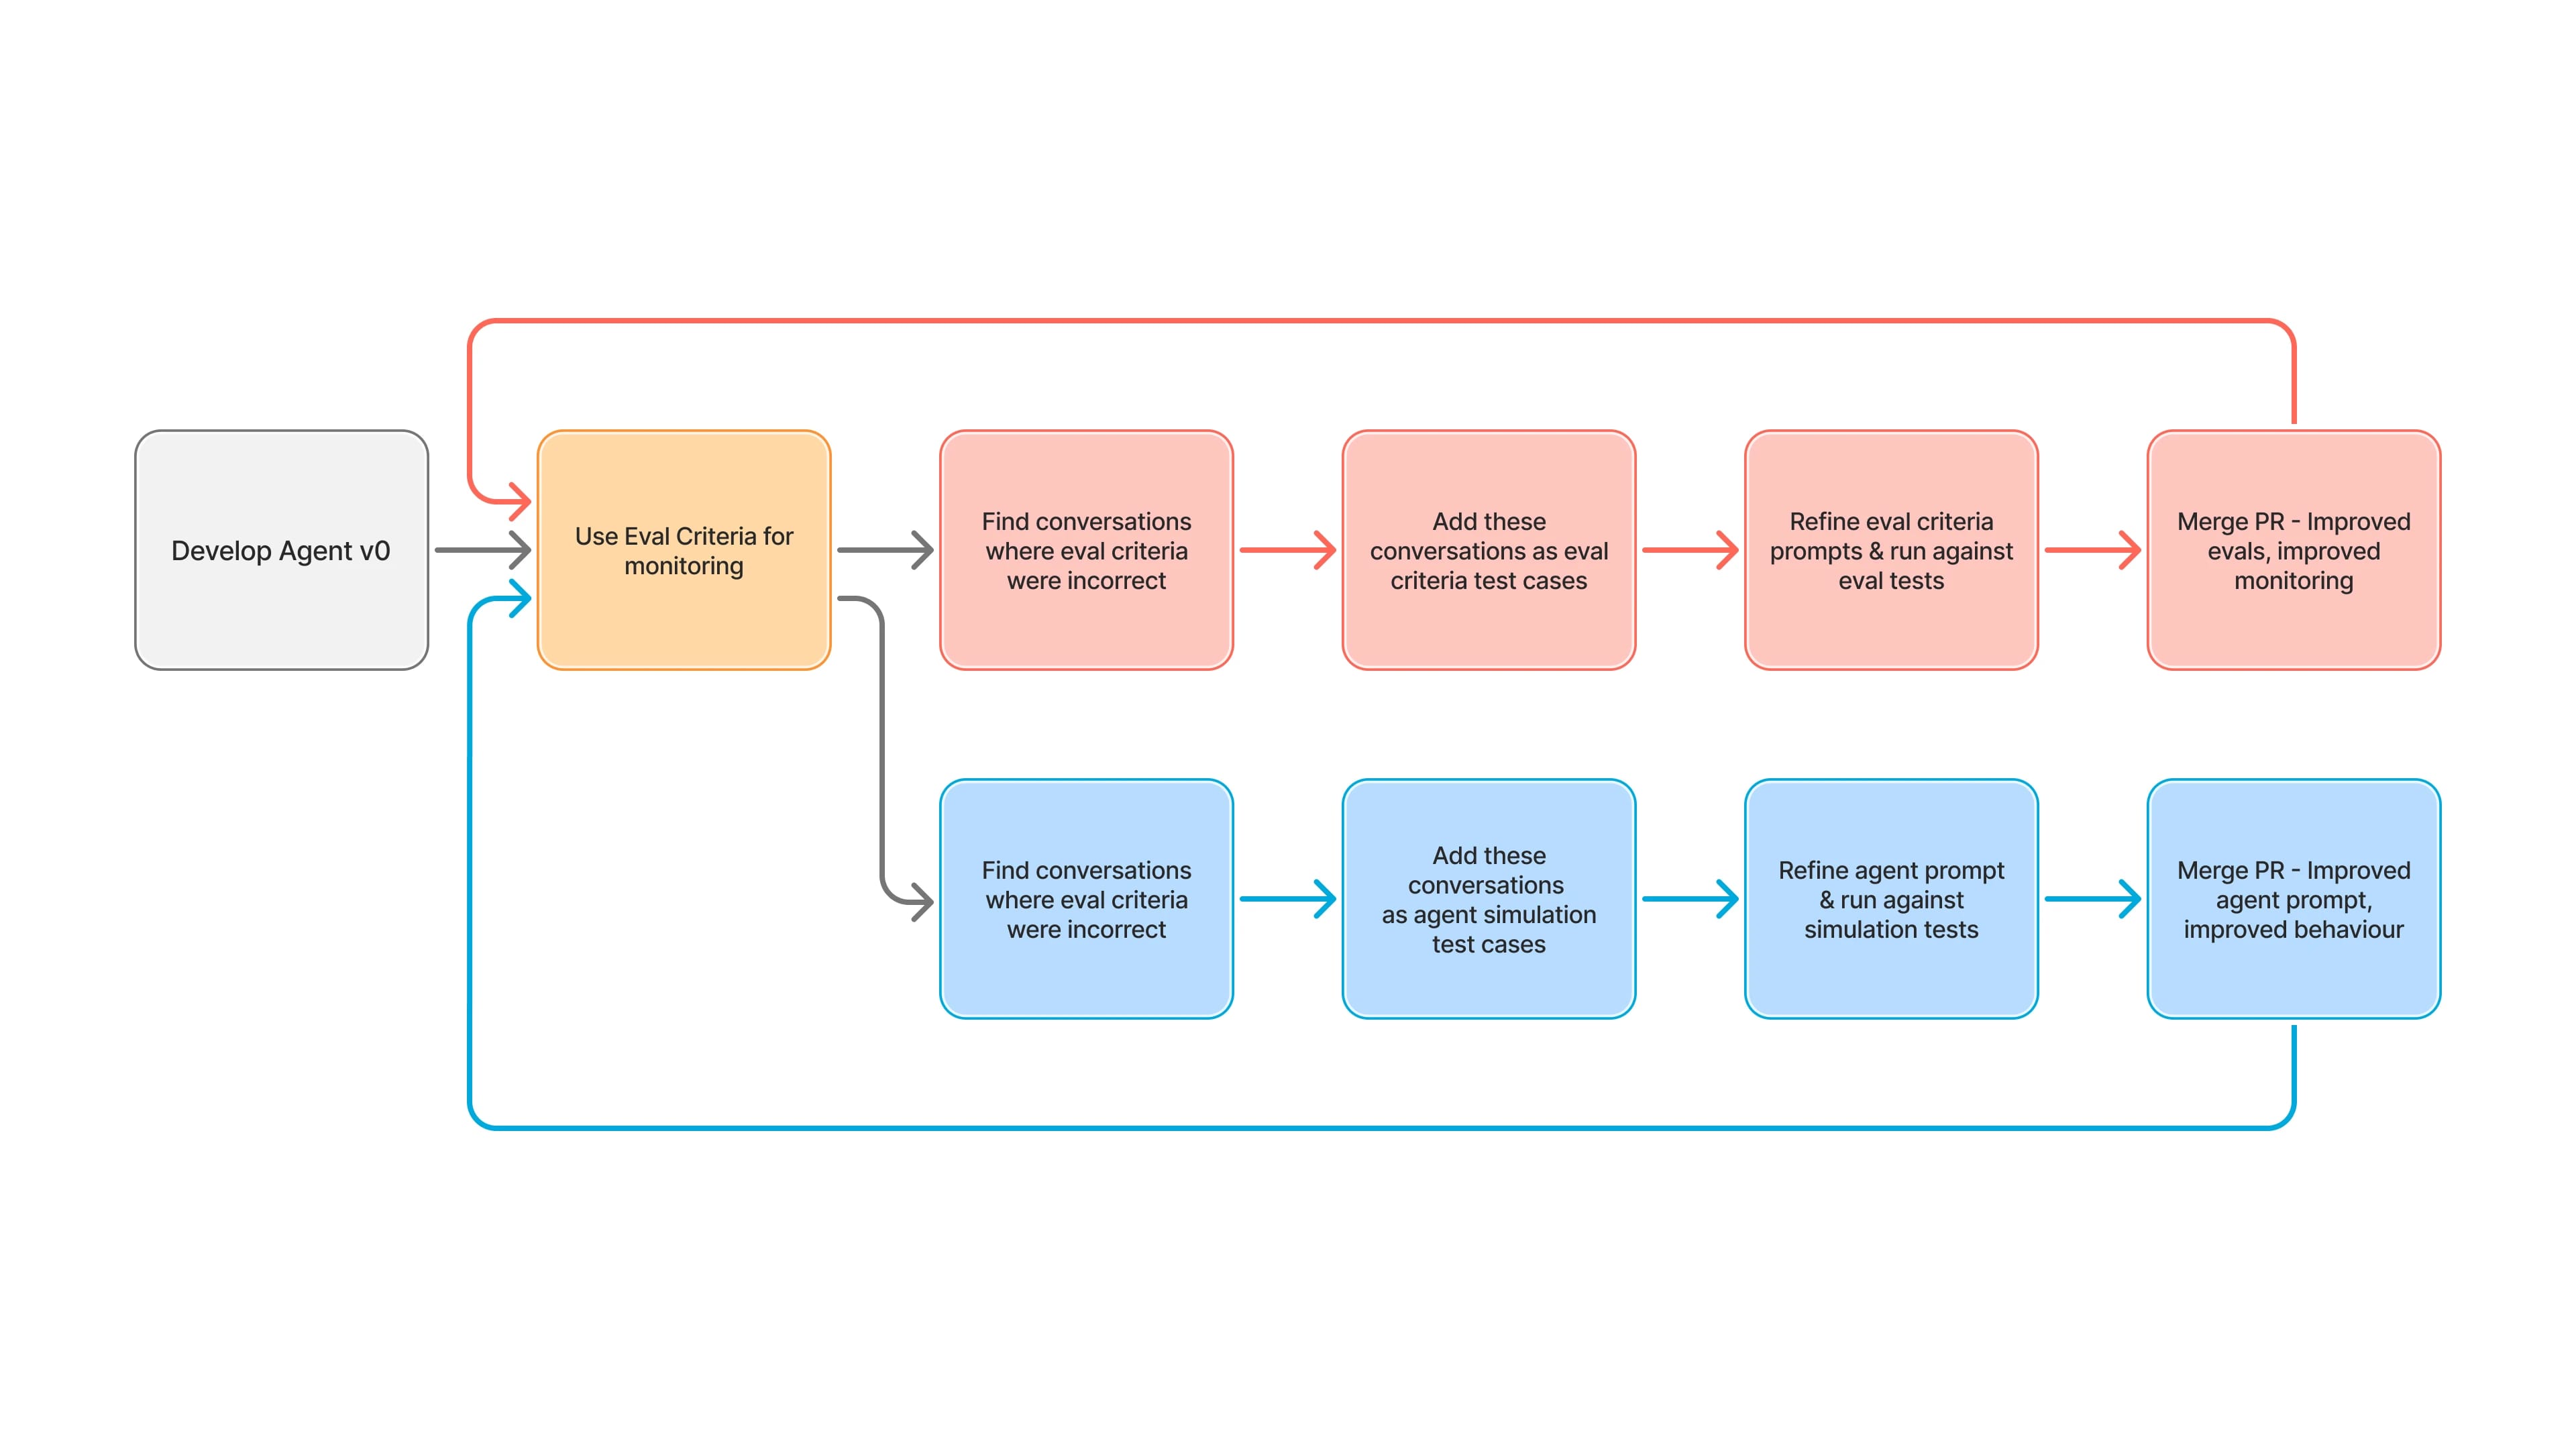
Ces questions ont guidé notre travail sur El, notre assistant de documentation propulsé par l’IA conversationnelle. À mesure qu’El évoluait, nous avons conçu un système pour surveiller, évaluer et tester les agents, fondé sur des critères d’évaluation et des simulations de conversation.
Poser les bases : des critères d’évaluation fiables
Pour améliorer un agent, il faut d’abord comprendre son comportement en conditions réelles. Nous avons donc affiné nos critères d’évaluation et veillé à ce qu’ils soient suffisamment précis et fiables pour surveiller les performances des agents. Nous considérons qu’une conversation a échoué lorsque l’agent fournit des informations incorrectes ou n’aide pas l’utilisateur à atteindre son objectif.
Nous avons défini les critères d’évaluation suivants :
- Interaction : la conversation est-elle valide ? L’utilisateur a-t-il posé des questions pertinentes ? La conversation était-elle cohérente ?
- Interaction positive : l’utilisateur est-il reparti satisfait, ou était-il confus ou frustré ?
- Compréhension de la cause racine : l’agent a-t-il correctement identifié le problème sous-jacent de l’utilisateur ?
- Résolution de la demande de l’utilisateur : l’agent a-t-il résolu le problème de l’utilisateur ou proposé une autre méthode d’assistance ?
- Hallucination : l’agent a-t-il inventé des informations absentes de la base de connaissances ?
Si l’interaction échoue, la conversation n’est pas valide. Si un autre critère échoue, nous approfondissons l’analyse. Cette analyse guide les améliorations apportées à l’agent. Il peut s’agir d’affiner l’utilisation des outils ou leur synchronisation. Dans d’autres cas, nous ajoutons des garde-fous pour empêcher des actions non prises en charge.
Itérer en confiance : l’API de simulation de conversation
Une fois les améliorations identifiées, l’étape suivante consiste à les tester. C’est là que notre API de simulation de conversation intervient. Elle simule des scénarios utilisateurs réalistes, de bout en bout comme sur des segments ciblés, et évalue automatiquement les résultats selon les mêmes critères qu’en production. Elle prend en charge la simulation des outils et les évaluations personnalisées, ce qui permet de tester des comportements spécifiques.
Nous utilisons deux approches :
- Simulations complètes : Testez des conversations complètes du début à la fin.
- Simulations partielles : commencez au milieu d’une conversation pour valider des points de décision ou des sous-flux. C’est notre méthode privilégiée pour les tests unitaires : elle permet d’itérer rapidement et de cibler le débogage.
Des scénarios clairs et ciblés nous permettent de contrôler ce sur quoi le LLM est testé et de couvrir les cas limites, l’utilisation des outils et la logique de repli.
Automatiser à grande échelle : intégrer les tests au CI/CD
La dernière étape est l’automatisation. Nous avons utilisé les API ouvertes d’ElevenLabs pour les connecter à notre flux DevOps GitHub, en intégrant l’évaluation et la simulation à notre pipeline CI/CD. Chaque mise à jour est automatiquement testée avant son déploiement. Cela évite les régressions et nous fournit rapidement des retours sur les performances en conditions réelles.
Résultats : un El plus robuste et plus intelligent
Ce processus a transformé notre façon de développer et de maintenir El. Nous avons créé une boucle de feedback qui relie l’utilisation réelle à une évaluation structurée, des tests ciblés et une validation automatisée. Nous pouvons ainsi déployer des améliorations plus rapidement et avec davantage de confiance.
Ce cadre peut désormais s’appliquer à tout agent que nous développons.



