Qu’est-ce que la latence de l’IA conversationnelle et quels facteurs l’influencent ?
- Rédigé par
- Jack Limebear
- Publié
- Dernière mise à jour
ÉcouterÉcouter cet article
Pour l’IA conversationnelle, la latence fait la différence entre une bonne application et une excellente application.
Par nature, l’IA conversationnelle est ambitieuse. Elle cherche à reproduire la sensation d’une conversation avec un interlocuteur humain, en imitant la même palette émotionnelle, la même hauteur de voix et le même rythme. Ajoutez à cela le délai qui paraît « naturel » entre le moment où vous cessez de parler et celui où un agent IA commence à répondre, et vous obtenez un objectif de latence fondé sur la manière dont les humains communiquent réellement.
Les entreprises qui souhaitent déployer des agents d’IA conversationnelle à grande échelle doivent réduire cette latence autant que possible pour créer cette impression naturelle. Cet article explique ce qu’est la latence de l’IA conversationnelle, ce qui provoque les délais dans l’ensemble du pipeline et comment les réduire.
En résumé
- La latence de l’IA conversationnelle correspond au délai total de bout en bout entre le moment où un utilisateur cesse de parler et celui où il entend le premier mot de l’agent.
- Au-delà de 700 ms, les agents peuvent paraître peu naturels. Au-delà de 1 200 ms, les taux d’abandon sont élevés.
- La latence s’accumule à chaque étape du pipeline d’IA conversationnelle.
- ElevenAgents gère l’intégralité du pipeline dans une architecture unifiée, rendant l’IA conversationnelle à faible latence accessible à votre entreprise.
Qu’est-ce que la latence de l’IA conversationnelle ?
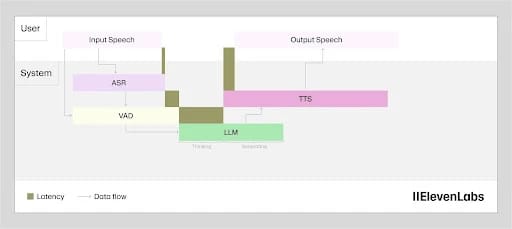
La latence de l’IA conversationnelle désigne le temps total nécessaire à un système pour répondre après votre prise de parole. Pour les modèles IA modernes, elle se mesure en ms. En coulisses, la latence totale résulte de plusieurs processus distincts, qui contribuent chacun au pipeline de bout en bout.
Un pipeline d’IA conversationnelle classique se présente ainsi :
- Un utilisateur parle
- L’audio est transcrit par un modèle de Speech to Text
- La transcription est transmise à un modèle LLM, qui produit une réponse
- Le texte du LLM est ensuite synthétisé en audio à l’aide d’un modèle de Text to Speech
- L’audio est ensuite diffusé à l’utilisateur
Chacune de ces étapes ajoute de la latence à un système d’IA conversationnelle. Il convient donc de distinguer plusieurs acronymes lorsque l’on parle de latence.
Latence d’inférence du modèle
La latence d’inférence du modèle est le temps qu’un modèle consacre à générer une sortie, mesuré en interne et sans tenir compte des facteurs externes. Elle mesure la vitesse d’exécution de votre moteur pour des entrées classiques. Par exemple, Flash v2.5 présente une latence d’inférence d’environ 75 ms. Cette mesure permet de comparer la rapidité des modèles entre différents fournisseurs.
Gardez toutefois à l’esprit qu’il ne s’agit pas de la latence réellement perçue par l’utilisateur. Elle concerne uniquement le temps total que le modèle consacre à générer une sortie.
Délai jusqu’au premier token du LLM
Le délai jusqu’au premier token (TTFT) d’un grand modèle de langage (LLM) correspond au temps total nécessaire au modèle pour traiter un prompt et générer son premier token de sortie exploitable.
La génération TTS commence lorsque le premier token arrive depuis votre LLM. Cette mesure indique donc le temps nécessaire au LLM pour commencer à solliciter votre modèle TTS. Pour la plupart des systèmes d’IA conversationnelle de bout en bout, le TTFT du LLM représente une part importante de la latence totale.
Délai TTS jusqu’au premier audio (TTFA)
Le délai TTS jusqu’au premier audio (TTFA) mesure le temps entre la première requête TTS et le moment où le premier segment audio quitte réellement le modèle. Il décrit la latence d’inférence du modèle, spécifiquement pour les moteurs TTS.
Délai de bout en bout jusqu’au premier audio (TTFA)
Le TTFA de bout en bout correspond à la latence totale de l’IA conversationnelle. Il additionne chaque composant du pipeline, de la reconnaissance vocale au TTFT du LLM, au TTS, au TTFA et à toutes les transmissions réseau entre les étapes. Pour parler de la latence globale de l’IA conversationnelle, c’est la mesure que perçoit l’utilisateur.
Lorsqu’il parle, l’utilisateur attend le TTFA de bout en bout avant d’entendre une réponse de votre agent. C’est une mesure globale : améliorer une partie du pipeline l’améliore également.
Pourquoi la latence de l’IA conversationnelle est importante
Lorsqu’un utilisateur parle à votre agent IA, la latence devient un facteur central de son expérience. Une faible latence réduit le temps d’attente avant une réponse, rend la conversation plus naturelle et donne une impression de compétence à votre agent.
Les agents à forte latence semblent artificiels et moins compétents, même si la qualité de leurs réponses est identique. Pour les entreprises, quelques centaines de ms peuvent sembler une éternité et donner à votre agent de support client un caractère lourd et inefficace.
Voici plusieurs scénarios qui illustrent concrètement l’importance de la latence de l’IA conversationnelle :
- Moins de 500 ms : un agent conversationnel paraît réactif et fluide. Les utilisateurs peuvent ne pas percevoir le délai entre la fin de leur prise de parole et la première réponse, ce qui permet à la conversation de se dérouler naturellement.
- De 500 à 1 000 ms : le délai entre le moment où l’utilisateur cesse de parler et celui où il reçoit une réponse peut devenir perceptible. Il est légèrement trop long : les utilisateurs peuvent alors se répéter ou marquer une pause pour vérifier que l’agent les a bien compris.
- Plus de 1 000 ms : les délais commencent à sembler longs, avec des silences qui donnent à certains utilisateurs l’impression que l’agent IA ne suit pas pleinement la conversation. Les transcriptions peuvent révéler des interruptions occasionnelles ou des demandes de transfert vers un intervenant humain. Dans certains cas, les utilisateurs peuvent abandonner l’appel.
Chacun de ces seuils a des conséquences concrètes pour l’entreprise.
Dans la partie basse du spectre de latence, votre agent de service client peut traiter naturellement les questions entrantes et aider les utilisateurs à résoudre leurs demandes sans assistance supplémentaire. Il réduit la charge de vos intervenants humains et préserve la satisfaction client. Dans la partie haute, vous risquez de frustrer vos clients avec un agent qui semble hésiter trop longtemps.
Nous avons défini les références de budget de latence des agents vocaux dans un autre article afin d’illustrer ce qu’est une bonne latence aux valeurs P50 comme P95.
Qu’est-ce qui provoque la latence de l’IA conversationnelle ?
La latence de l’IA conversationnelle résume plusieurs processus, chaque segment contribuant à l’ensemble. Le principal obstacle à une faible latence relève donc davantage du système dans son ensemble que du simple choix d’un meilleur modèle. Plusieurs modèles interagissent en effet dans le pipeline.
Pour les développeurs, nous avons rédigé un guide technique approfondi sur l’optimisation de la latence des agents vocaux afin d’améliorer chaque étape du délai de bout en bout jusqu’au premier audio (TTFA).
Au-delà du pipeline central, d’autres facteurs, tels que la téléphonie et l’appel de fonctions, ajoutent également de la latence, même s’ils ne relèvent pas de l’infrastructure interne des modèles.
Voici un aperçu de tous les facteurs qui contribuent à la latence de l’IA conversationnelle.
Reconnaissance automatique de la parole
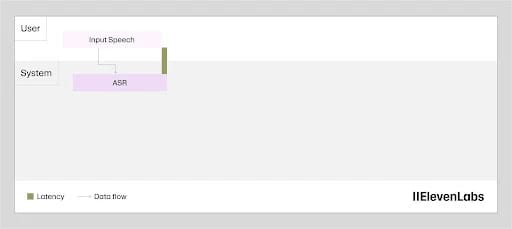
La latence de la reconnaissance vocale ne correspond pas au temps nécessaire pour générer une transcription. La transcription s’exécute en arrière-plan pendant que l’utilisateur parle ; lorsque sa prise de parole se termine, le texte est donc déjà largement prêt.
La latence correspond ici au délai entre la fin de la prise de parole et la finalisation de la transcription, puis sa transmission à l’étape suivante. Scribe v2 Realtime ramène ce délai à environ 150 ms grâce à un streaming continu : la sortie est prête dès la fin du tour de parole.
Prise de tour et détection de fin de parole
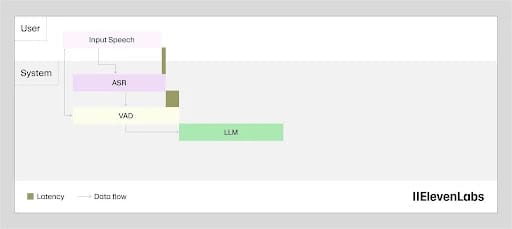
Un détecteur d’activité vocale (VAD) se situe entre la reconnaissance vocale et le modèle de langage. Il détermine le moment où l’utilisateur a réellement fini de parler.
Pour éviter les erreurs, le VAD attend un seuil de silence prolongé avant de déclarer le tour de parole terminé. Cette attente ajoute de la latence avant que le modèle de langage traite un mot. Ce léger délai supplémentaire évite toutefois que le système commence à répondre alors que l’utilisateur parle encore.
Techniquement, si tous les autres composants de l’IA conversationnelle n’ajoutaient aucune latence, la latence attribuée à la prise de tour serait bénéfique. Les humains marquent un temps d’arrêt avant de répondre. Une pause similaire de la part d’une machine apporte du réalisme à l’interaction. Toutefois, les autres composants de l’IA conversationnelle ajoutant déjà de la latence, le minimum est idéal.
Traitement par le modèle de langage
Une fois la transcription prête depuis le moteur de Speech to Text (STT), le modèle de langage génère une réponse. La latence correspond ici au temps nécessaire pour commencer à générer des tokens, et non à générer la réponse complète. Ces tokens sont transmis directement à l’étape TTS dès leur arrivée : le TTFT est donc la mesure la plus importante.
Au-delà du choix du modèle, la longueur du prompt et la taille de la base de connaissances influent sur cette étape. Plus le LLM doit prendre en compte de contexte, plus il lui faut de temps. Lors de la conception de ces systèmes à grande échelle, trouvez le juste équilibre entre une base de connaissances utile et un prompt concis pour maintenir la rapidité.
Synthèse vocale
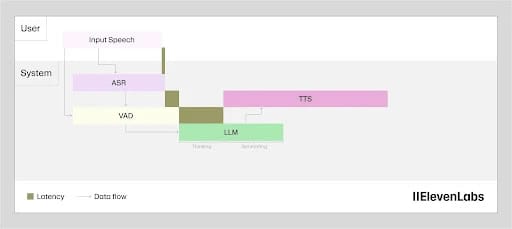
La latence TTS est le délai entre la réception des premiers tokens du modèle de langage et le début de l’audio. Les tokens arrivant plus vite que la parole humaine n’est diffusée, le modèle de synthèse n’attend jamais la réponse complète. La latence TTS correspond strictement au délai jusqu’au premier segment audio.
Cette étape était autrefois la principale source de latence de l’IA conversationnelle : les anciens modèles mettaient 2 à 3 secondes à commencer à générer la parole. Flash v2.5 d’ElevenLabs répond directement à cet enjeu, avec une synthèse vocale offrant une latence d’environ 75 ms et un goulot d’étranglement réduit de plusieurs secondes à une fraction de seconde.
Latence réseau
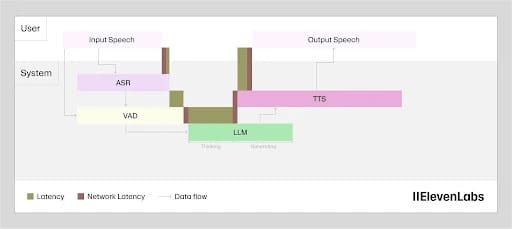
L’envoi de données d’un emplacement à un autre ajoute toujours de la latence, la distance géographique aggravant encore la latence réseau aller-retour.
Comme plusieurs composants collaborent pour fournir une réponse de bout en bout, une latence importante peut s’accumuler au fil de plusieurs sauts réseau.
Appel de fonctions
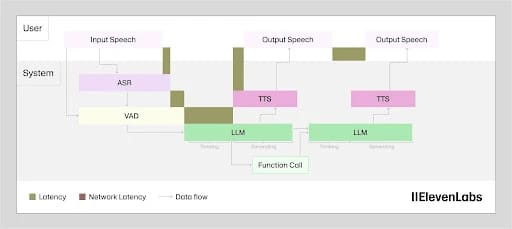
Les appels de fonctions ajoutent des allers-retours API à l’étape du LLM. Une recherche interne rapide ajoute quelques dizaines de millisecondes, tandis qu’un processeur de paiement ou un système de gestion des stocks peut ajouter plusieurs secondes. La latence dépend entièrement du service appelé, ce qui en fait l’étape la plus difficile à optimiser directement.
Le modèle le plus efficace consiste à demander au LLM de répondre avant la fin de l’appel à l’outil. Une phrase telle que « Laissez-moi vérifier cela pour vous » maintient l’engagement de l’utilisateur pendant la résolution de l’appel externe, plutôt que de laisser un silence. La réponse vocale commence pendant que l’outil s’exécute en parallèle.
Comment réduire la latence de l’IA conversationnelle
Réduire la latence de l’IA conversationnelle exige d’agir sur chaque étape du pipeline selon son impact. Chaque amélioration a un effet sur la latence, mais seule une approche globale du pipeline permettra d’obtenir le changement le plus important.
Voici quelques principes pour réduire globalement la latence de l’IA conversationnelle :
- Choix du modèle TTS : les modèles TTS optimisés pour la vitesse, tels que Flash v2.5, utilisent des architectures différentes des modèles optimisés pour la qualité, comme Eleven v3 et Eleven v4. Pour les agents vocaux en temps réel, le bon choix est le modèle de meilleure qualité qui respecte votre objectif de latence, presque toujours un modèle optimisé pour la vitesse.
- Choix du modèle LLM : les LLM plus petits et plus rapides produisent généralement un délai jusqu’au premier token plus faible que les modèles plus grands. Choisir le LLM le plus rapide qui répond toujours à vos exigences de qualité est tout aussi important que le choix du modèle TTS.
- Streaming : le streaming TTS renvoie l’audio par segments à mesure que la synthèse progresse, afin que l’utilisateur entende le premier mot pendant que le modèle génère encore le reste. Ce principe s’applique aussi à la sortie du LLM : commencer la synthèse TTS dès la première phrase, tandis que le modèle de langage génère les suivantes, permet de récupérer de la latence dans le pipeline.
- Prompt système : les utilisateurs peuvent rationaliser les prompts système en plaçant les instructions dans des procédures ou des workflows, plutôt que de les conserver à chaque étape de décision. Cela réduit le volume de contexte que le modèle doit analyser à chaque tour.
- Garde-fous : exécuter les garde-fous dans le modèle de streaming permet de commencer la lecture de la sortie avant la fin de la vérification, plutôt que de bloquer la lecture jusqu’à son terme.
- Colocalisation des modèles : l’utilisation de modèles colocalisés lorsque cela est possible, par exemple avec la pile ElevenLabs Agents, rapproche les composants afin d’éviter la latence due aux sauts entre des modèles hébergés séparément.
- Géographie : la proximité entre vos serveurs et vos utilisateurs peut réduire considérablement la latence, car elle diminue directement la contribution du réseau au TTFA de bout en bout.
Au-delà de ces facteurs, consultez ce guide technique sur l’optimisation de la latence pour plus de détails.
Essayez l’IA conversationnelle à faible latence avec ElevenAgents dès aujourd’hui
La latence de l’IA conversationnelle est un élément majeur à prendre en compte lors de la conception et du déploiement d’agents. Avec ElevenAgents, l’optimisation de la latence est intégrée au processus. Des techniques de chevauchement qui récupèrent du temps à la faible latence d’inférence des composants individuels, ElevenAgents conçoit des piles d’IA conversationnelle à faible latence pour votre entreprise.
L’objectif final est de créer une interaction réaliste. L’utilisateur doit retrouver la simplicité d’un échange avec un interlocuteur humain, tout en bénéficiant des avantages d’un programme informatique. En optimisant les sous-processus, cela est désormais possible.
Retrouvez plus d’informations sur ElevenAgents ou Nous contacter pour commencer dès aujourd’hui.
FAQ sur la latence de l’IA conversationnelle

Jack Limebear fait partie de l’équipe Growth, où il rédige et conçoit des contenus pour le blog et les pages d’analyses. Avant de rejoindre ElevenLabs, il a passé plus de dix ans à piloter la stratégie de contenu pour des organisations allant de start-ups SaaS en forte croissance à des entreprises du Fortune 500. Il est titulaire d’un master en littérature anglaise de l’Université de Cambridge.