Was ist Latenz bei Conversational KI und was beeinflusst sie?
- Verfasst von
- Jack Limebear
- Veröffentlicht
- Zuletzt aktualisiert
AnhörenArtikel anhören
Bei konversationeller KI entscheidet die Latenz darüber, ob Anwendungen gut oder hervorragend sind.
Konversationelle KI ist ihrem Wesen nach ambitioniert. Sie soll das Gefühl eines Gesprächs mit einem Menschen nachbilden und dabei dieselbe emotionale Bandbreite, Tonhöhe und Sprachmelodie widerspiegeln. Berücksichtigt man zudem, welche Verzögerung zwischen Ihrem Sprechende und der Antwort eines KI-Agenten als „natürlich“ empfunden wird, ergibt sich ein Latenzziel, das auf der tatsächlichen menschlichen Kommunikation basiert.
Unternehmen, die konversationelle KI-Agenten im großen Maßstab einsetzen möchten, müssen diese Latenz so weit wie möglich senken, um diese natürliche Illusion zu erreichen. Dieser Artikel erklärt, was Latenz bei konversationeller KI ist, was Verzögerungen entlang der gesamten Pipeline verursacht und wie sie sich grundsätzlich reduzieren lassen.
Zusammenfassung
- Die Latenz bei konversationeller KI ist die gesamte Ende-zu-Ende-Verzögerung vom Ende der Nutzereingabe bis zum ersten Wort des Agenten.
- Agenten mit mehr als 700 ms können unnatürlich wirken; bei über 1.200 ms sind die Abbruchraten hoch.
- Die Latenz summiert sich über jede Stufe der Pipeline für konversationelle KI.
- ElevenAgents verarbeitet die gesamte Pipeline in einer einheitlichen Architektur und macht konversationelle KI mit niedriger Latenz für Ihr Unternehmen zugänglich.
Was ist Latenz bei konversationeller KI?
Die Latenz bei konversationeller KI bezeichnet die Gesamtzeit, die ein System für eine Antwort benötigt, nachdem Sie gesprochen haben. Bei modernen KI-Modellen wird die Latenz in ms gemessen. Hinter diesem Gesamtwert stehen mehrere einzelne Prozesse, die jeweils einen Teil der Ende-zu-Ende-Pipeline abdecken.
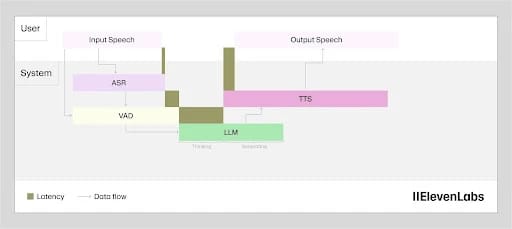
Eine typische Pipeline für konversationelle KI sieht so aus:
- Ein Nutzer spricht
- Das Audio wird von einem Speech-to-Text-Modell transkribiert
- Das Transkript wird an ein LLM weitergegeben, das eine Antwort erzeugt
- Der Text des LLM wird dann mit einem Text-to-Speech-Modell in Audio umgewandelt
- Das Audio wird anschließend für den Nutzer wiedergegeben
Jede dieser Stufen erhöht die Latenz eines Systems für konversationelle KI. Deshalb sollten bei der Diskussion über Latenz einige verschiedene Abkürzungen geklärt werden.
Modell-Inferenzlatenz
Die Modell-Inferenzlatenz ist die Zeit, die ein Modell intern für die Ausgabeerzeugung benötigt, ohne externe Faktoren. Sie ist die modellspezifische Kennzahl dafür, wie schnell Ihre Engine bei typischen Eingaben arbeitet. Flash v2.5 hat beispielsweise eine Modell-Inferenzlatenz von etwa 75 ms. Damit können Sie die Geschwindigkeit von Modellen verschiedener Anbieter vergleichen.
Beachten Sie jedoch: Das ist nicht die Latenz, die Nutzer tatsächlich erleben. Sie bezieht sich ausschließlich auf die Gesamtzeit, die ein Modell für die Ausgabeerzeugung benötigt.
LLM Time-to-First-Token
Die Time-to-First-Token (TTFT) eines Large Language Model (LLM) ist die Gesamtzeit, die ein Large Language Model benötigt, um einen Prompt zu verarbeiten und sein erstes nutzbares Ausgabe-Token zu erzeugen.
Die TTS-Generierung beginnt, sobald das erste Token Ihres LLM eintrifft. Diese Kennzahl misst also, wie lange das LLM benötigt, um Ihr TTS-Modell zu starten. Bei den meisten Ende-zu-Ende-Systemen für konversationelle KI ist die LLM-TTFT ein wesentlicher Teil der Gesamtlatenz.
TTS Time-to-First-Audio (TTFA)
Die TTS Time-to-First-Audio (TTFA) misst die Zeit von der ersten TTS-Anfrage bis zum Verlassen des ersten Audio-Blocks aus dem Modell. Sie beschreibt die Modell-Inferenzlatenz speziell für TTS-Engines.
Ende-zu-Ende Time-to-First-Audio (TTFA)
Die Ende-zu-Ende-TTFA ist die gesamte Latenz der konversationellen KI. Sie ist die Summe aller Teile der Pipeline, von Spracherkennung, LLM-TTFT, TTS und TTFA bis zu allen Netzwerkübertragungen zwischen den Schritten. Wenn von der Latenz konversationeller KI insgesamt die Rede ist, ist dies die Kennzahl, die Nutzer wahrnehmen.
Wenn Nutzer sprechen, warten sie auf die Ende-zu-Ende-TTFA, bevor sie eine Antwort Ihres Agenten hören. Sie ist ein ganzheitliches Maß, sodass jede Verbesserung in der Pipeline sie reduziert.
Warum die Latenz konversationeller KI wichtig ist
Wenn ein Nutzer mit Ihrem KI-Agenten spricht, wird die Latenz zu einem zentralen Faktor für die Wahrnehmung dieses Erlebnisses. Niedrige Latenzzeiten verkürzen die Wartezeit auf eine Antwort. Das Gespräch wirkt dadurch natürlich und Ihr Agent kompetent.
Agenten mit hoher Latenz wirken künstlich und weniger kompetent, selbst wenn ihre Antworten gleich gut sind. Für Unternehmen können bereits wenige hundert ms wie eine Ewigkeit wirken und Ihren Kundensupport-Agenten schwerfällig und ineffektiv erscheinen lassen.
Diese Szenarien zeigen, warum die Latenz konversationeller KI in der Praxis wichtig ist:
- Unter 500 ms: Ein konversationeller Agent wirkt reaktionsschnell und effizient. Nutzer bemerken die Verzögerung zwischen dem Ende ihrer Eingabe und der ersten Antwort möglicherweise nicht, sodass das Gespräch flüssig verläuft.
- 500 bis 1.000 ms: Die Verzögerung zwischen dem Ende der Nutzereingabe und der Antwort kann spürbar werden. Sie ist nur etwas zu lang, sodass Nutzer sich möglicherweise vorsorglich anpassen, indem sie sich wiederholen oder pausieren, um zu prüfen, ob der Agent sie tatsächlich verstanden hat.
- Über 1.000 ms: Verzögerungen fühlen sich langsam an. Pausen können bei manchen Nutzern den Eindruck erwecken, dass der KI-Agent dem Gespräch nicht ganz folgen kann. Transkripte können gelegentliche Unterbrechungen oder Bitten zeigen, mit einem menschlichen Agenten zu sprechen. In manchen Fällen brechen Nutzer den Anruf ab.
Jeder dieser Schwellenwerte hat konkrete geschäftliche Auswirkungen.
Am unteren Ende des Latenzspektrums kann ein Kundendienst-Agent eingehende Fragen natürlich bearbeiten und Nutzern helfen, ihre Anliegen ohne zusätzliche Unterstützung zu lösen. Das entlastet Ihre menschlichen Agenten und hält die Kundenzufriedenheit hoch. Am oberen Ende des Latenzspektrums frustrieren Sie Ihre Kunden mit einem Agenten, der scheinbar viel zu lange zögert.
In einem anderen Artikel haben wir die Benchmarks für das Latenzbudget von Voice Agents definiert, um zu zeigen, wie gute Latenz bei P50- und P95-Werten aussieht.
Was verursacht Latenz bei konversationeller KI?
Latenz bei konversationeller KI ist ein Begriff für mehrere verschiedene Prozesse, bei denen jedes Segment zum Ganzen beiträgt. Der Engpass für niedrige Latenz ist daher eher ein Problem auf Systemebene als eines, das sich durch die Wahl eines besseren Modells lösen lässt. Schließlich interagieren mehrere Modelle mit der Pipeline.
Für Entwickler haben wir einen ausführlichen technischen Leitfaden zur Latenzoptimierung von Voice Agents erstellt. Damit können Sie jede Stufe der Ende-zu-Ende Time-to-First-Audio (TTFA) verbessern.
Neben der Kernpipeline erhöhen auch andere Faktoren wie Telefonie und Function Calling die Latenz, obwohl sie nicht Teil der Modellinfrastruktur sind.
Hier finden Sie einen Überblick über alle Faktoren, die zur Latenz konversationeller KI beitragen.
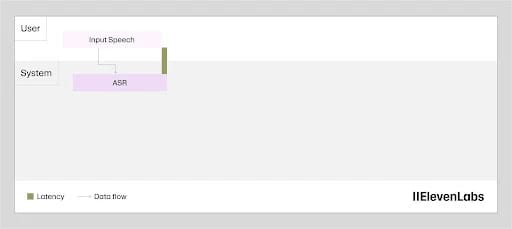
Automatische Spracherkennung
Die Latenz der Spracherkennung ist nicht die Zeit, die zum Erstellen eines Transkripts benötigt wird. Die Transkription läuft im Hintergrund, während der Nutzer spricht. Wenn die Sprache endet, ist der Text daher größtenteils bereits fertig.
Die Latenz ist hier vielmehr die Zeitspanne zwischen dem Ende der Sprache und dem Abschluss sowie der Weitergabe des Transkripts an die nächste Stufe. Scribe v2 Realtime verkürzt diese Lücke auf etwa 150 ms und streamt kontinuierlich, sodass die Ausgabe bereit ist, sobald der Gesprächszug endet.
Sprecherwechsel und Endpunkterkennung
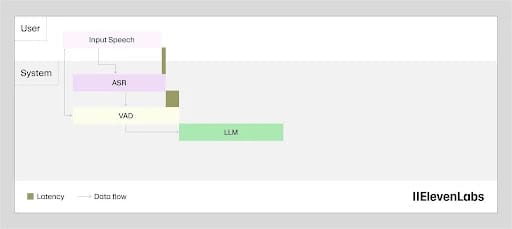
Ein Voice Activity Detector (VAD) befindet sich zwischen der Spracherkennung und dem Sprachmodell. Seine Aufgabe ist es, festzustellen, wann der Nutzer tatsächlich aufgehört hat zu sprechen.
Um Fehler zu vermeiden, wartet der VAD eine bestimmte Dauer anhaltender Stille ab, bevor er den Gesprächszug für beendet erklärt. Diese Wartezeit erhöht die Latenz, bevor das Sprachmodell ein Wort verarbeitet. Die zusätzliche Latenz kostet zwar Zeit, verhindert aber auch, dass das System zu antworten beginnt, während der Nutzer noch spricht.
Rein technisch wäre die dem Sprecherwechsel zugeschriebene Latenz vorteilhaft, wenn alle anderen Komponenten der konversationellen KI keine Latenz verursachten. Menschen warten kurz, bevor sie auf Sprache antworten. Wenn eine Maschine ähnlich pausiert, wirkt die Interaktion realistischer. Da andere Komponenten der konversationellen KI jedoch bereits Latenz verursachen, ist minimale Latenz ideal.
Verarbeitung durch das Sprachmodell
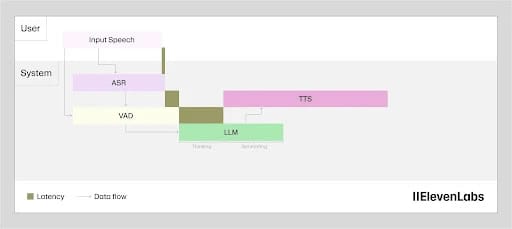
Sobald das Transkript aus der Speech-to-Text-Engine (STT) vorliegt, erzeugt das Sprachmodell eine Antwort. Die Latenz ist hier die Zeit bis zum Beginn der Token-Generierung, nicht bis zur vollständigen Antwort. Diese Tokens werden direkt nach ihrem Eintreffen an die TTS-Stufe gestreamt. Entscheidend ist daher die TTFT.
Neben der Modellwahl beeinflussen auch Prompt-Länge und Größe der Wissensdatenbank diese Stufe. Je mehr Kontext das LLM berücksichtigen muss, desto länger dauert es. Bei der Entwicklung dieser Systeme im großen Maßstab sollten Sie für hohe Geschwindigkeit die richtige Balance zwischen einer nützlichen Wissensdatenbank und einem schlanken Prompt finden.
Sprachsynthese
Die TTS-Latenz ist die Zeit zwischen dem Empfang der ersten Tokens vom Sprachmodell und dem Beginn der Audiowiedergabe. Da Tokens schneller eintreffen, als menschliche Sprache wiedergegeben wird, wartet das Synthesemodell nie auf die vollständige Antwort. Die TTS-Latenz ist ausschließlich die Zeit bis zum ersten Audio-Block.
Diese Stufe war früher der größte einzelne Faktor für die Latenz konversationeller KI, da ältere Modelle 2–3 Sekunden benötigten, um mit der Spracherzeugung zu beginnen. Flash v2.5 von ElevenLabs löst dieses Problem direkt: Es liefert Sprachsynthese mit etwa 75 ms Latenz und reduziert diesen Engpass von Sekunden auf einen Sekundenbruchteil.
Netzwerklatenz
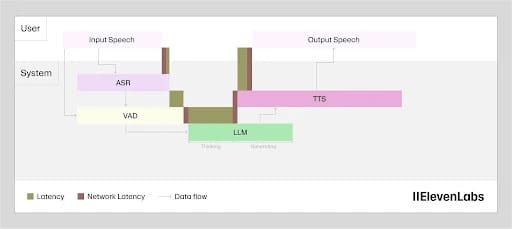
Das Senden von Daten von einem Ort zu einem anderen verursacht immer Latenz. Geografische Distanz verstärkt dabei nur die Netzwerklatenz für Hin- und Rückwege.
Da mehrere Komponenten für eine Ende-zu-Ende-Antwort zusammenarbeiten, kann sich über mehrere Netzwerk-Hops hinweg erhebliche Latenz ansammeln.
Function Calling
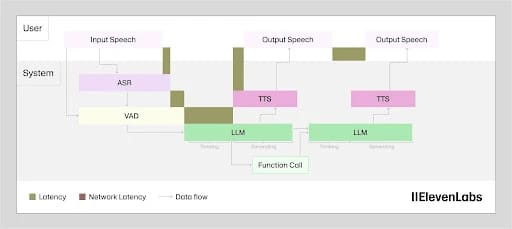
Funktionsaufrufe fügen in der LLM-Stufe API-Hin- und Rückwege hinzu. Eine schnelle interne Abfrage benötigt einige zehn Millisekunden, während ein Zahlungsabwickler oder Warenwirtschaftssystem Sekunden hinzufügen kann. Die Latenz hängt vollständig vom aufgerufenen Dienst ab. Das macht diese Stufe zur am schwierigsten direkt optimierbaren.
Am effektivsten ist es, das LLM zu einer Antwort aufzufordern, bevor der Tool-Aufruf abgeschlossen ist. Ein Satz wie „Ich prüfe das für Sie“ hält den Nutzer beschäftigt, während der externe Aufruf abgeschlossen wird, statt Stille entstehen zu lassen. Die Sprachantwort beginnt, während das Tool parallel ausgeführt wird.
So reduzieren Sie die Latenz konversationeller KI
Um die Latenz konversationeller KI zu reduzieren, müssen Sie jede Stufe der Pipeline nach ihrem Einfluss angehen. Einzelne Verbesserungen wirken sich zwar auf die Latenz aus, doch für die größte Veränderung müssen Sie die gesamte Pipeline ganzheitlich optimieren.
Diese Prinzipien helfen Ihnen dabei, die Latenz konversationeller KI grundsätzlich zu reduzieren:
- TTS-Modellauswahl: Auf Geschwindigkeit optimierte TTS-Modelle wie Flash v2.5 verwenden andere Architekturen als auf Qualität optimierte Modelle wie Eleven v3 und Eleven v4. Für Echtzeit-Voice Agents ist das Modell mit der höchsten Qualität, das Ihr Latenzziel erfüllt, die richtige Wahl – fast immer ein auf Geschwindigkeit optimiertes Modell.
- LLM-Modellauswahl: Kleinere, schnellere LLMs erzielen in der Regel eine niedrigere Time-to-First-Token als größere Modelle. Die Wahl des schnellsten LLM, das Ihren Qualitätsanspruch für die Aufgabe noch erfüllt, ist genauso wichtig wie die TTS-Modellauswahl.
- Streaming: Streaming-TTS gibt Audio während der Synthese in Blöcken zurück. So hört der Nutzer das erste Wort, während das Modell den Rest noch erzeugt. Das gilt auch für die LLM-Ausgabe: Beginnt die TTS-Synthese mit dem ersten Satz, während das Sprachmodell die folgenden generiert, lässt sich Latenz aus der Pipeline zurückgewinnen.
- System-Prompt-Design: Sie können System-Prompts verschlanken, indem Sie Anweisungen in Verfahren oder Workflows verlagern, statt sie in jedem Entscheidungsschritt beizubehalten. Dadurch verringert sich der Kontext, über den das Modell bei jedem Gesprächszug nachdenken muss.
- Guardrails: Wenn Guardrails im Streaming-Modell ausgeführt werden, kann die Ausgabe bereits abgespielt werden, bevor die Guardrail-Prüfung abgeschlossen ist. So wird die Wiedergabe nicht bis zum Ende der Prüfung blockiert.
- Modell-Kollokation: Kollokierte Modelle, etwa der ElevenLabs-Agents-Stack, halten Komponenten nah beieinander. So entsteht keine zusätzliche Latenz durch Hops zwischen separat gehosteten Modellen.
- Geografie: Eine geringe Distanz zwischen Ihren Servern und Ihren Nutzern kann die Latenz deutlich reduzieren, da sie direkt den Netzwerkanteil an der Ende-zu-Ende-TTFA verringert.
Weitere Details finden Sie in diesem technischen Leitfaden zur Latenzoptimierung.
Starten Sie mit konversationeller KI mit niedriger Latenz auf ElevenAgents
Die Latenz konversationeller KI ist ein wichtiger Faktor beim Entwickeln und Bereitstellen von Agenten. Mit ElevenAgents ist die Latenzoptimierung in den Prozess integriert. Von Overlap-Techniken zur Zeitgewinnung bis zur niedrigen Modell-Inferenzlatenz einzelner Komponenten erstellt ElevenAgents Stacks für konversationelle KI mit niedriger Latenz für Ihr Unternehmen.
Letztlich geht es darum, Realismus zu schaffen. Nutzer sollen die Leichtigkeit eines Gesprächs mit einem Menschen spüren und zugleich von den Vorteilen eines Computerprogramms profitieren. Durch die Optimierung der Teilprozesse ist das jetzt möglich.
Erfahren Sie mehr über ElevenAgents oder kontaktieren Sie den Vertrieb, um noch heute zu starten.
FAQ zur Latenz konversationeller KI

Jack Limebear ist Teil des Growth-Teams und arbeitet als Content Writer und Stratege für Blog- und Insights-Seiten. Vor ElevenLabs leitete er über zehn Jahre die Content-Strategie für Unternehmen – von schnell wachsenden SaaS-Startups bis zu Fortune-500-Konzernen. Er hat einen Masterabschluss in Englischer Literatur von der University of Cambridge.