Testando Agentes de Conversação com IA
- Escrito por
- Anna Neely
- Publicado
- Última atualização
OuvirOuça este artigo
Quando agentes de voz entram em operação, como monitorá-los em escala? Como identificar quando não estão se comportando como deveriam? E, depois de fazer alterações, como testá-los?
Essas perguntas orientaram nosso trabalho no El, nosso assistente de documentação com IA Conversacional. À medida que o El evoluiu, criamos um sistema para monitorar, avaliar e testar agentes, com base em critérios de avaliação e simulações de conversas.
Criando a base: critérios de avaliação confiáveis
Melhorar qualquer agente começa com entender como ele se comporta no mundo real. Isso exigiu aprimorar nossos critérios de avaliação e garantir que fossem precisos e confiáveis o suficiente para monitorar o desempenho dos agentes. Definimos uma conversa com falha como aquela em que o agente fornece informações incorretas ou não ajuda o usuário a alcançar seu objetivo.
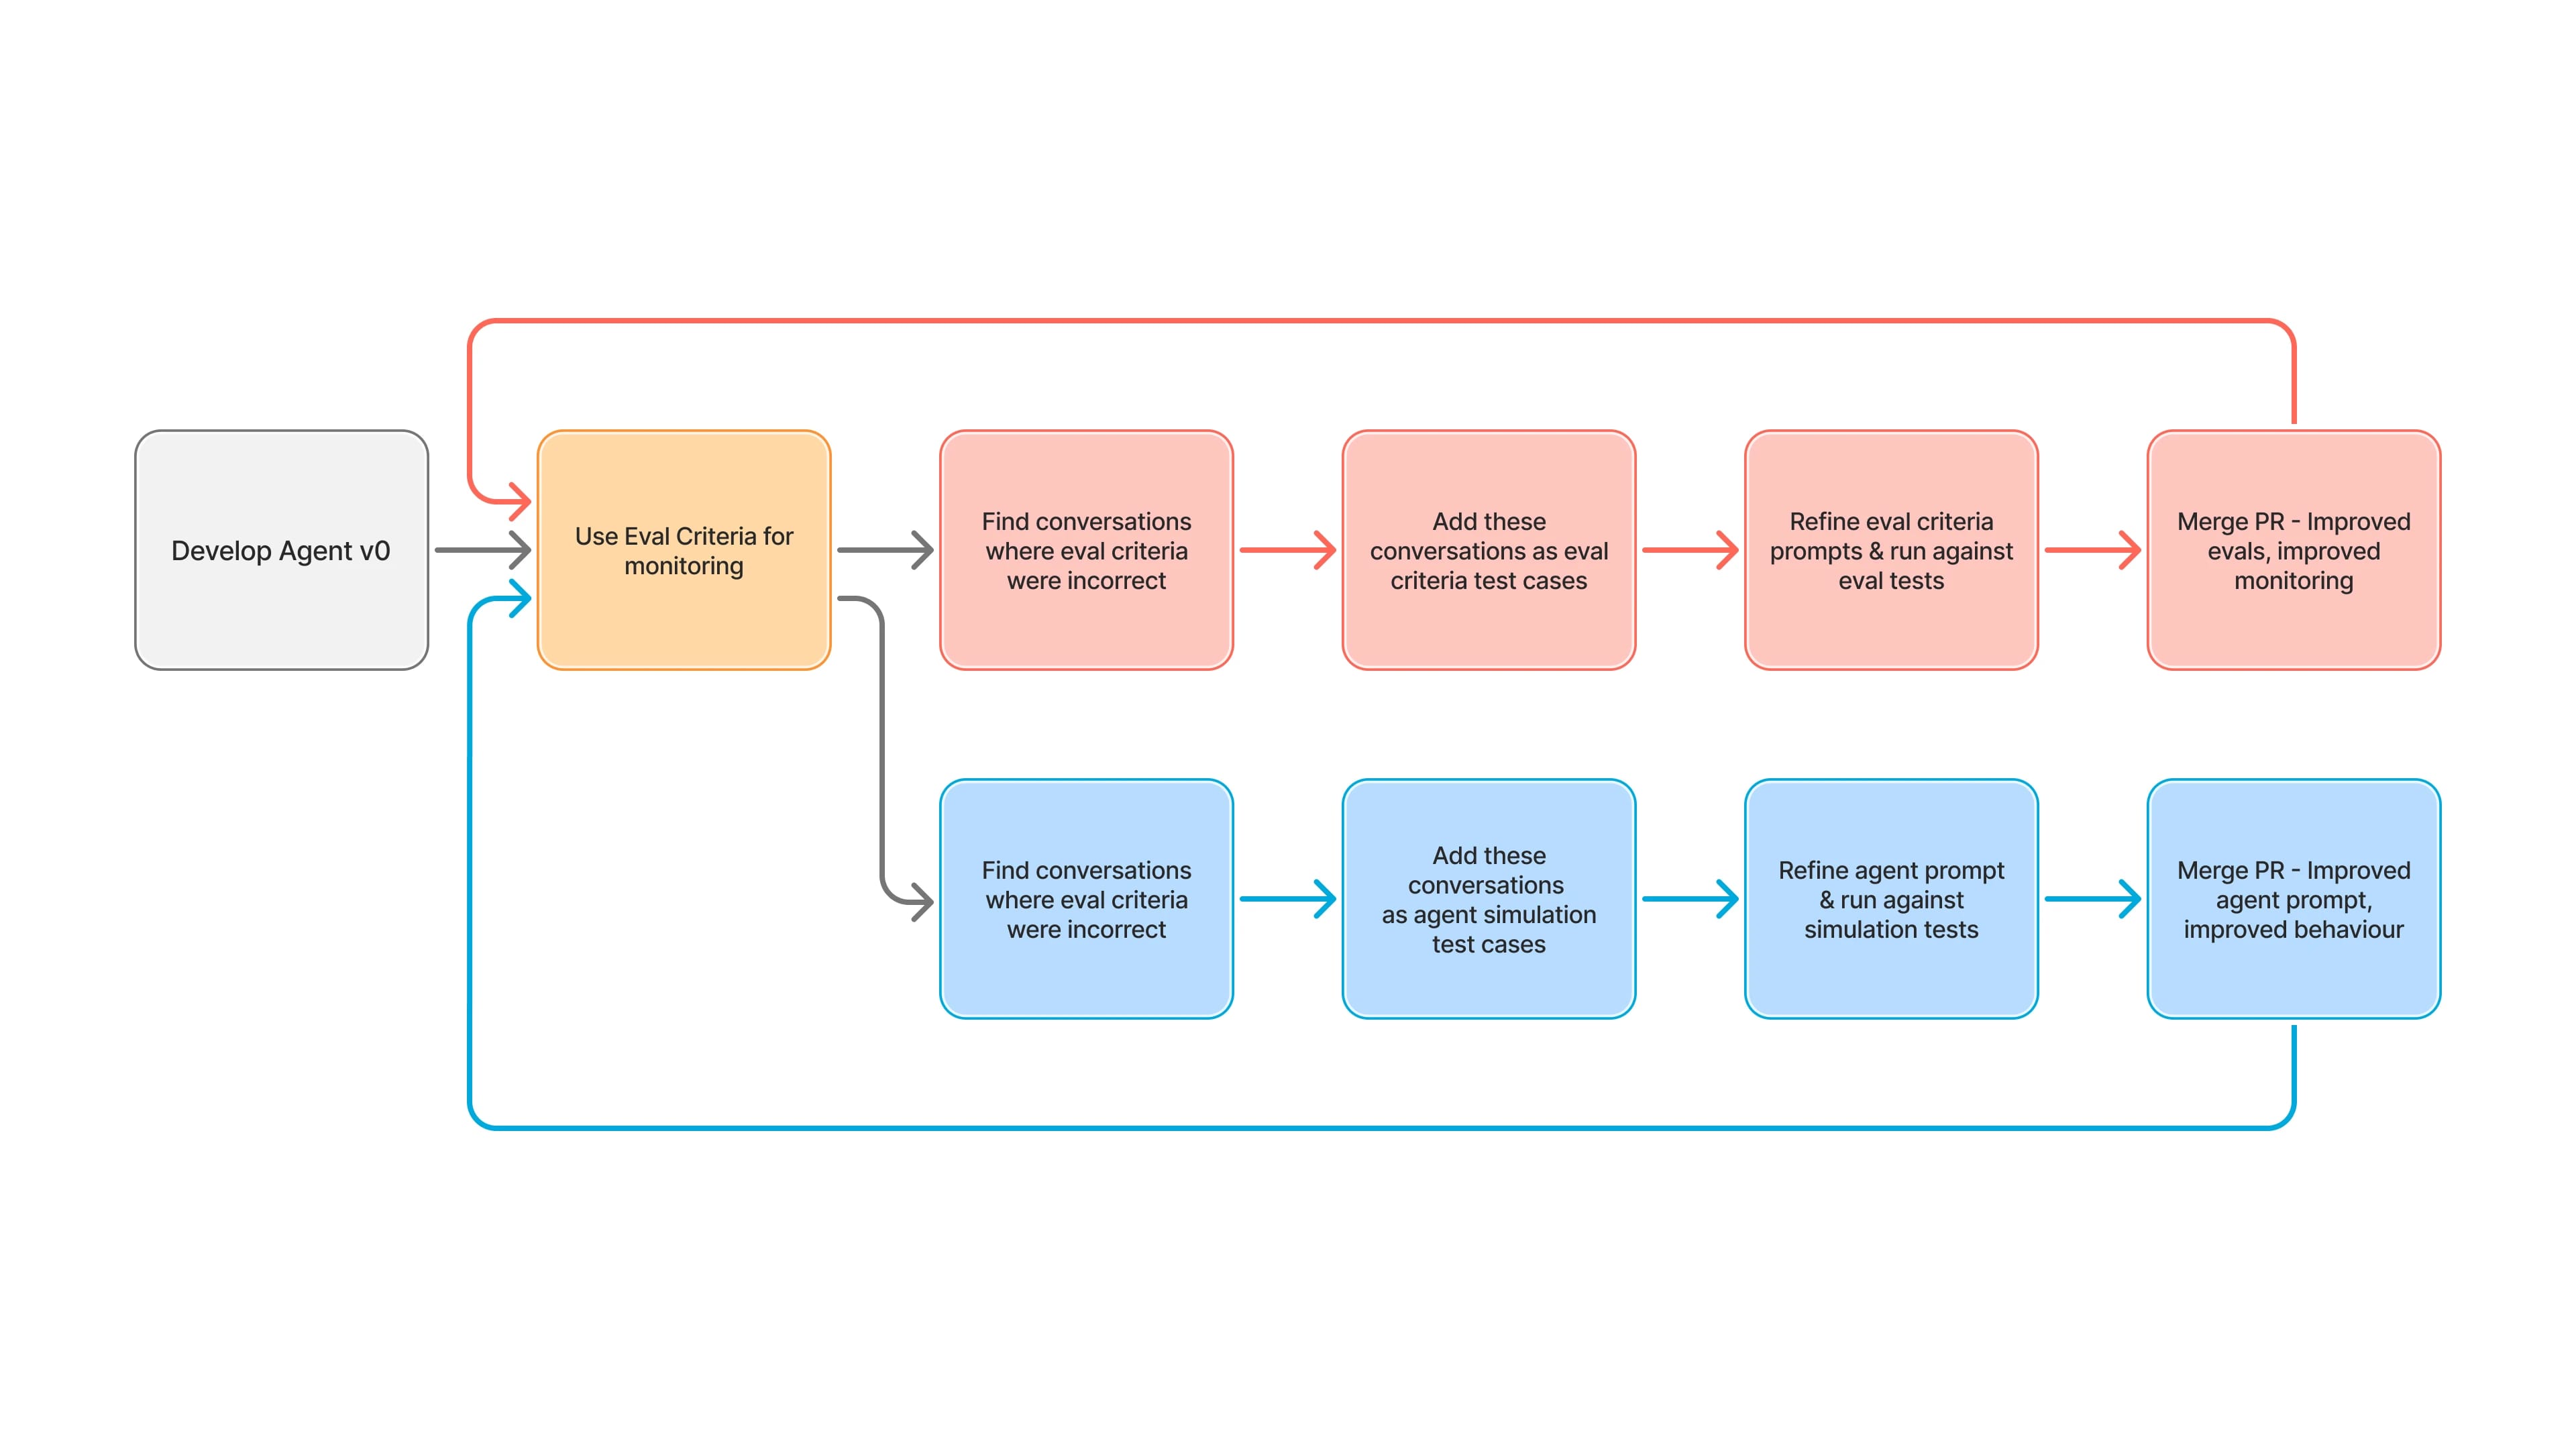
Desenvolvemos os seguintes critérios de avaliação:
- Interação: esta é uma conversa válida? O usuário fez perguntas relevantes? A conversa fez sentido?
- Interação positiva: o usuário ficou satisfeito ou saiu confuso ou frustrado?
- Entendimento da causa raiz: o agente identificou corretamente o problema subjacente do usuário?
- Resolução da solicitação do usuário: o agente resolveu o problema do usuário ou ofereceu um método alternativo de suporte?
- Alucinação: o agente inventou informações que não estão na base de conhecimento?
Se Interação falhar, a conversa em si não é válida. Se qualquer outro critério falhar, investigamos mais a fundo. A investigação orienta como aprimoramos o agente. Às vezes, trata-se de refinar o uso ou o timing das ferramentas. Em outros casos, adicionamos barreiras de proteção para evitar ações sem suporte.
Iterando com confiança: API de simulação de conversas
Depois de identificar o que melhorar, o próximo passo é testar. É aí que entra nossa API de simulação de conversas . Ela simula cenários realistas de usuários — tanto de ponta a ponta quanto em segmentos específicos — e avalia automaticamente os resultados usando os mesmos critérios aplicados em produção. Ela oferece suporte a simulação de ferramentas e avaliação personalizada, sendo flexível o bastante para testar comportamentos específicos.
Usamos duas abordagens:
- Simulações completas: Teste conversas completas do início ao fim.
- Simulações parciais: comece no meio da conversa para validar pontos de decisão ou subfluxos. Esse é nosso método preferido para testes de unidade, pois permite iteração rápida e depuração direcionada.
Cenários claros e focados nos permitem controlar o que está sendo testado no LLM, garantindo cobertura para casos extremos, uso de ferramentas e lógica de contingência.
Automação em escala: incorporando testes ao CI/CD
A peça final é a automação. Usamos as APIs abertas da ElevenLabs para nos conectar ao nosso fluxo de DevOps no GitHub, incorporando avaliações e simulações ao nosso pipeline de CI/CD. Todas as atualizações são testadas automaticamente antes da implantação. Isso evita regressões e nos dá feedback rápido sobre o desempenho no mundo real.
Resultados: um El mais forte e inteligente
Esse processo transformou a forma como criamos e mantemos o El. Criamos um ciclo de feedback que conecta o uso real a avaliações estruturadas, testes direcionados e validação automatizada, permitindo lançar melhorias mais rápido e com mais confiança.
E essa é uma estrutura que agora podemos aplicar a qualquer agente que criarmos.
Anna Neely atua em estratégia de produto e trabalha com clientes empresariais no design e implementação de soluções