Testowanie agentów Conversational AI
- Autor
- Anna Neely
- Opublikowano
- Ostatnia aktualizacja
PosłuchajPosłuchaj tego artykułu
Gdy konwersacyjne agenty głosowe trafiają do użytku, jak monitorować je na dużą skalę? Jak wykryć, że nie działają zgodnie z założeniami? A gdy wprowadzisz zmiany, jak je przetestować?
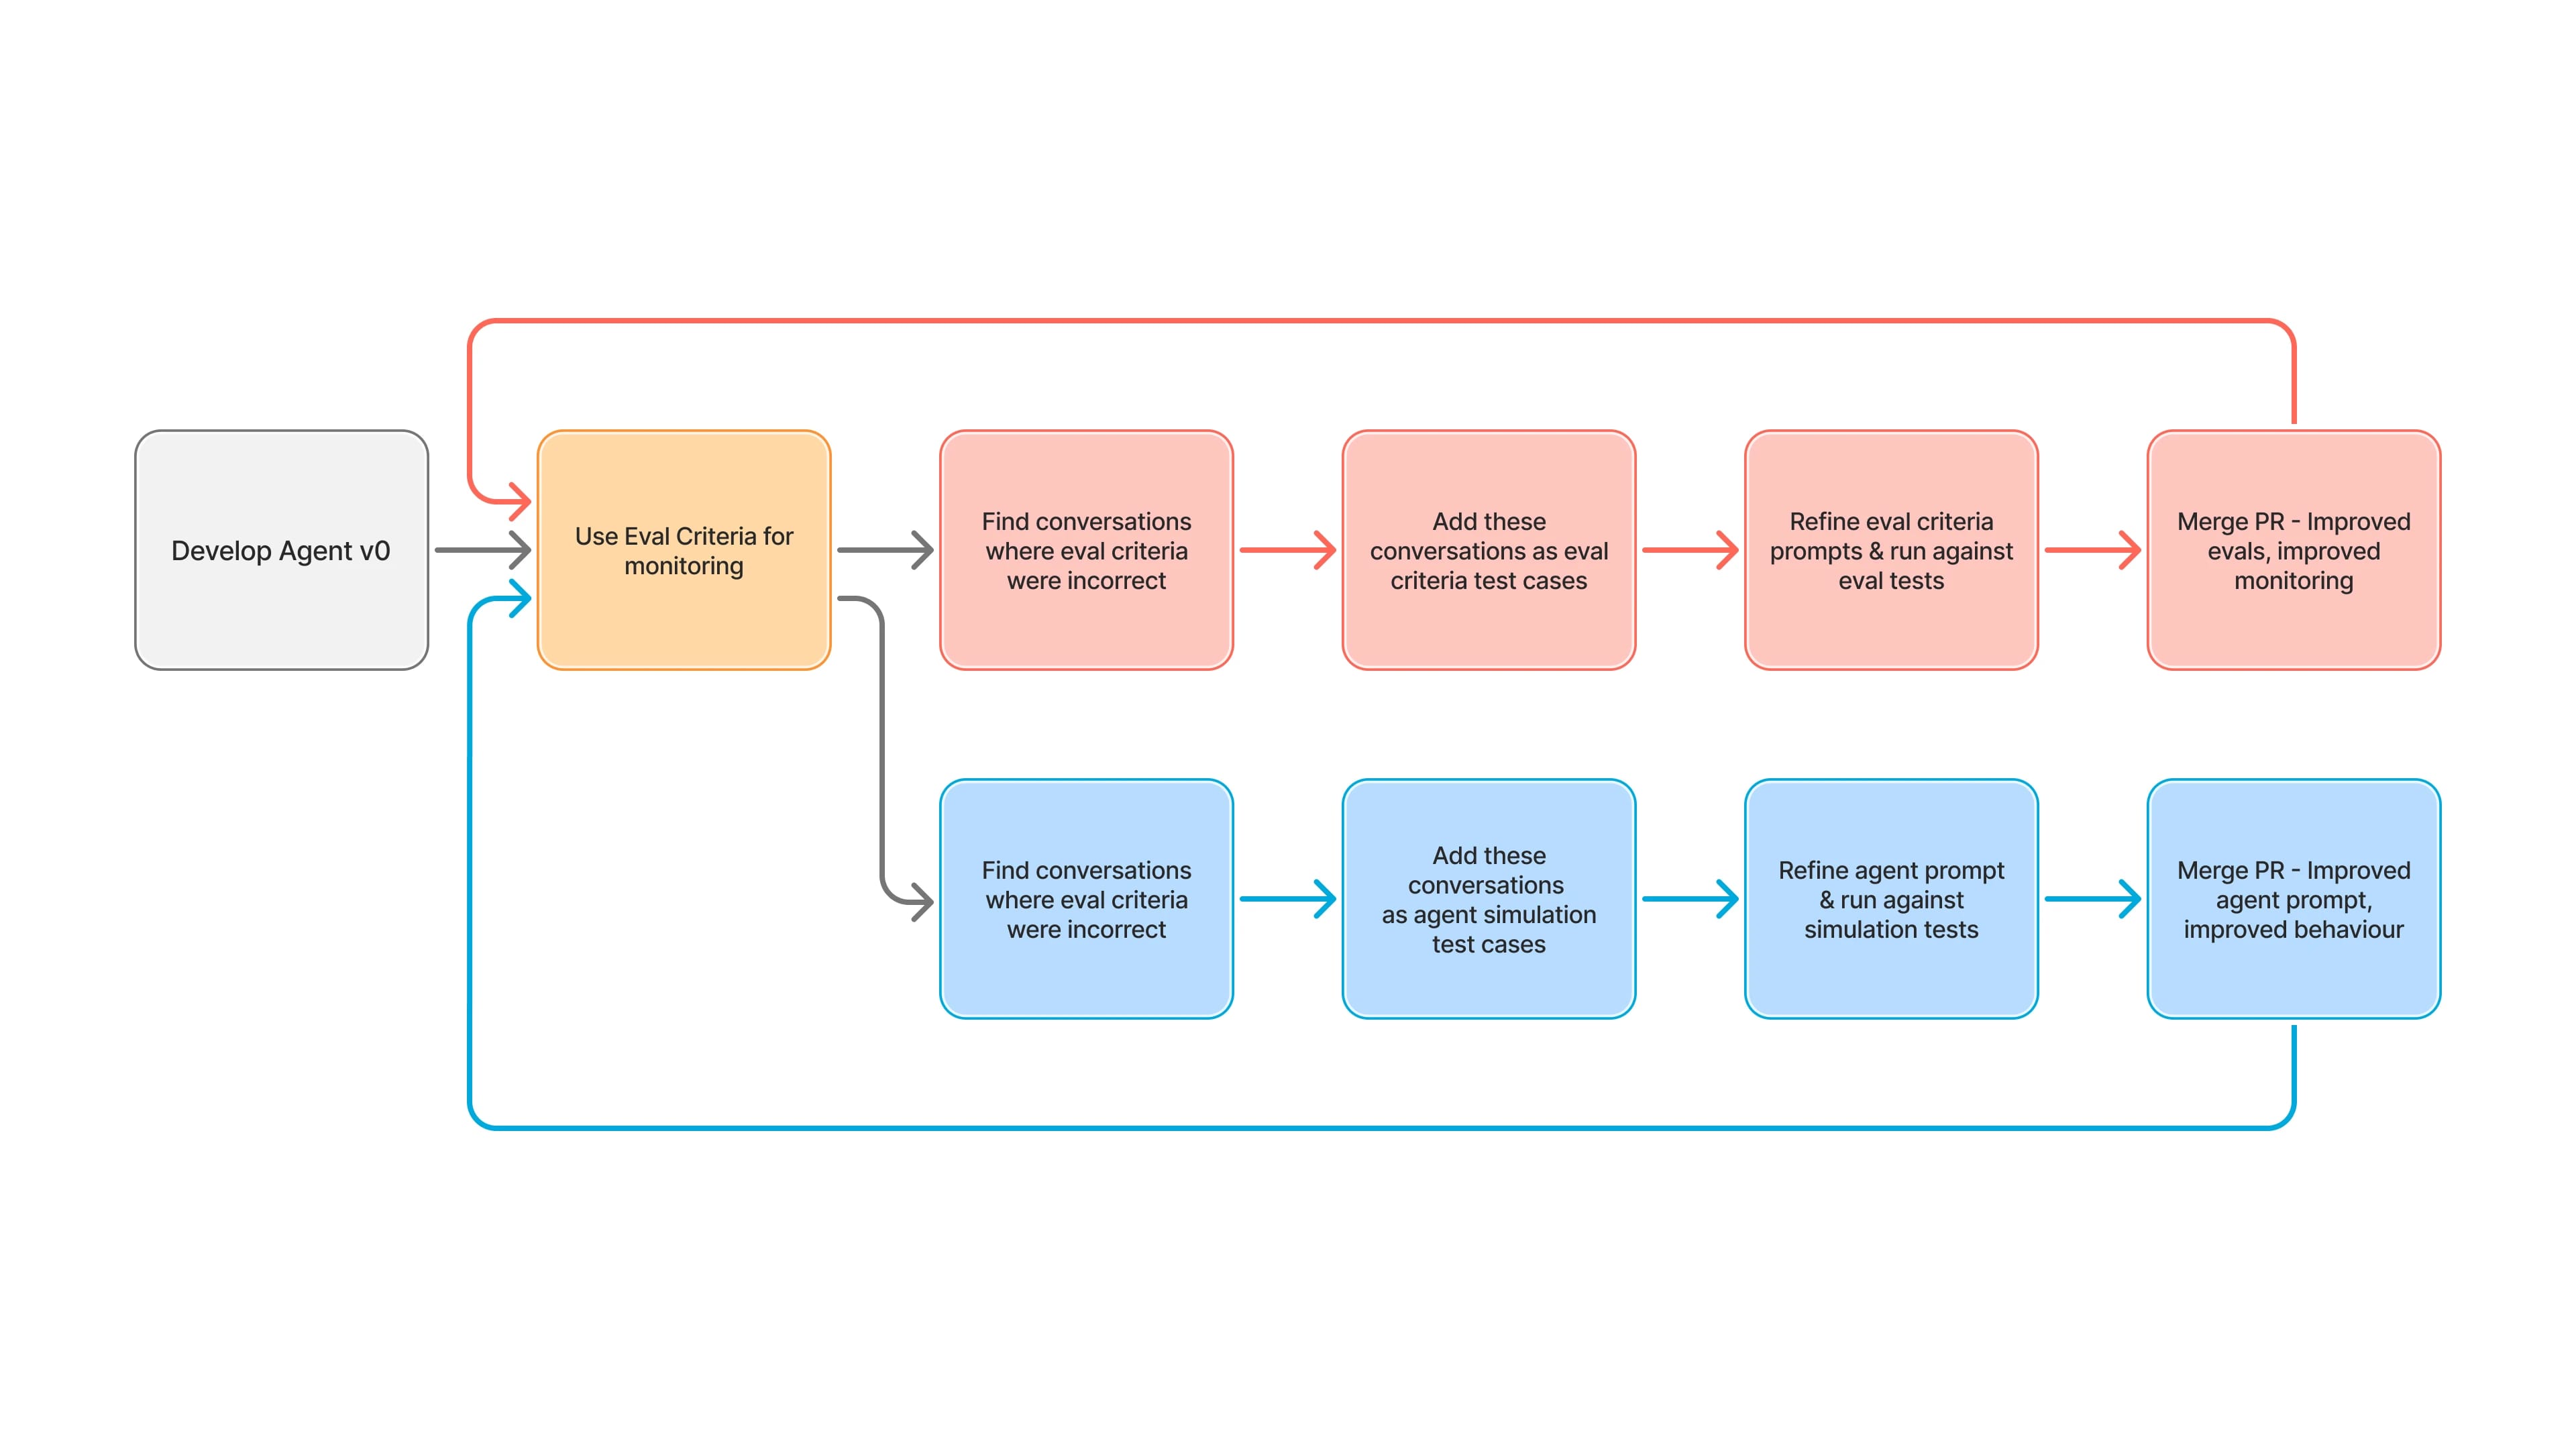
Te pytania kierowały naszą pracą nad El, naszym asystentem dokumentacji opartym na Conversational AI. Wraz z rozwojem El stworzyliśmy system do monitorowania, oceny i testowania agentów, oparty na kryteriach oceny i symulacjach rozmów.
Podstawa działania: wiarygodne kryteria oceny
Ulepszanie każdego agenta zaczyna się od zrozumienia, jak działa w praktyce. Musieliśmy więc dopracować kryteria oceny i zadbać o ich dokładność oraz wiarygodność, by monitorować działanie agenta. Za nieudaną rozmowę uznajemy taką, w której agent podaje błędne informacje lub nie pomaga użytkownikowi osiągnąć celu.
Opracowaliśmy następujące kryteria oceny:
- Interakcja: czy rozmowa jest prawidłowa, czy użytkownik zadał trafne pytania i czy rozmowa miała sens?
- Pozytywna interakcja: czy użytkownik odszedł zadowolony, czy był zdezorientowany lub sfrustrowany?
- Zrozumienie głównej przyczyny: czy agent prawidłowo rozpoznał źródło problemu użytkownika?
- Rozwiązanie problemu użytkownika: czy agent rozwiązał problem użytkownika lub zaproponował inną formę wsparcia?
- Halucynacje: czy agent zmyślił informacje, których nie ma w bazie wiedzy?
Jeśli kryterium Interakcja nie zostanie spełnione, sama rozmowa jest nieprawidłowa. Jeśli nie zostanie spełnione inne kryterium, badamy sprawę dokładniej. Wyniki tego badania wskazują, jak ulepszyć agenta. Czasem trzeba dopracować użycie narzędzi lub ich czas działania. Innym razem dodać zabezpieczenia, by zapobiec nieobsługiwanym działaniom.
Pewne iteracje: Conversation Simulation API
Gdy już wiemy, co ulepszyć, kolejnym krokiem są testy. W tym pomaga nasze Conversation Simulation API . Symuluje realistyczne scenariusze użytkownika — zarówno end-to-end, jak i w wybranych fragmentach — oraz automatycznie ocenia wyniki według tych samych kryteriów, których używamy na produkcji. Obsługuje mockowanie narzędzi i własne kryteria oceny, więc pozwala testować konkretne zachowania.
Stosujemy dwa podejścia:
- Pełne symulacje: Testuj całe rozmowy od początku do końca.
- Częściowe symulacje: zacznij w środku rozmowy, by sprawdzić punkty decyzyjne lub podprocesy. To nasza sprawdzona metoda testów jednostkowych, która pozwala szybko iterować i precyzyjnie debugować.
Jasne, konkretne scenariusze pozwalają nam kontrolować, co testujemy w LLM-ie, i zapewniają pokrycie przypadków brzegowych, użycia narzędzi oraz logiki awaryjnej.
Automatyzacja na dużą skalę: testy w CI/CD
Ostatnim elementem jest automatyzacja. Korzystając z otwartych API ElevenLabs, połączyliśmy się z naszym procesem DevOps w GitHubie i osadziliśmy ocenę oraz symulacje w pipeline CI/CD. Każda aktualizacja jest automatycznie testowana przed wdrożeniem. To zapobiega regresjom i szybko daje nam informacje o działaniu w praktyce.
Wyniki: silniejszy i mądrzejszy El
Ten proces zmienił sposób, w jaki tworzymy i utrzymujemy El. Stworzyliśmy pętlę informacji zwrotnej, która łączy realne użycie z uporządkowaną oceną, ukierunkowanymi testami i automatyczną walidacją. Dzięki temu szybciej wdrażamy ulepszenia i mamy większą pewność ich działania.
To model, który możemy teraz zastosować do każdego agenta, którego tworzymy.


