कन्वर्सेशनल AI लेटेंसी क्या है और इसे कौन से कारक प्रभावित करते हैं?
- लेखक
- Jack Limebear
- प्रकाशित
- आखिरी बार अपडेट किया गया
सुनेंइस आर्टिकल को सुनें
कन्वर्सेशनल AI के लिए कन्वर्सेशनल AI में, लेटेंसी ही अच्छे ऐप्लिकेशन और बेहतरीन ऐप्लिकेशन के बीच अंतर पैदा करती है।
कन्वर्सेशनल AI स्वभाव से ही महत्वाकांक्षी है। इसका लक्ष्य इंसान से बातचीत करने जैसा अनुभव दोहराना है, जिसमें वही भावनात्मक विविधता, पिच और लय शामिल हों। जब आप बोलना बंद करते हैं और AI एजेंट जवाब देना शुरू करता है, उसके बीच का जो अंतराल ‘स्वाभाविक’ लगता है, उसे जोड़ें, तो आपको इंसानों के वास्तविक संवाद के आधार पर तय किया गया लेटेंसी लक्ष्य मिलता है।
जो व्यवसाय बड़े पैमाने पर कन्वर्सेशनल AI एजेंट तैनात करना चाहते हैं, उन्हें उस स्वाभाविक अनुभव को पाने के लिए लेटेंसी को जितना हो सके कम करना होगा। इस लेख में बताया गया है कि कन्वर्सेशनल AI लेटेंसी क्या है, पूरी पाइपलाइन में देरी किन वजहों से होती है और उसे कम करने के तरीके क्या हैं।
सारांश
- कन्वर्सेशनल AI लेटेंसी, यूज़र के बोलना बंद करने से लेकर एजेंट का पहला शब्द सुनाई देने तक की कुल एंड-टू-एंड देरी है।
- 700 ms से अधिक लेटेंसी वाले एजेंट अस्वाभाविक लग सकते हैं, और 1,200 ms से ऊपर वाले एजेंटों में कॉल छोड़ने की दर अधिक होती है।
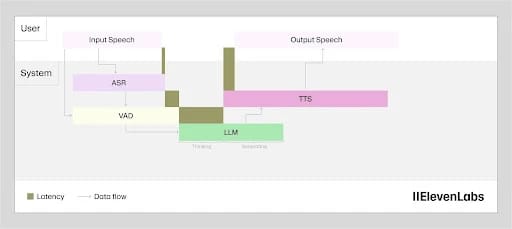
- कन्वर्सेशनल AI पाइपलाइन के हर चरण में लेटेंसी जुड़ती जाती है।
- ElevenAgents एक ही एकीकृत आर्किटेक्चर में पूरी पाइपलाइन संभालता है, जिससे आपके व्यवसाय के लिए कम-लेटेंसी वाला कन्वर्सेशनल AI सुलभ बनता है।
कन्वर्सेशनल AI लेटेंसी क्या है?
कन्वर्सेशनल AI लेटेंसी वह कुल समय है जो आपके बोलने के बाद सिस्टम को जवाब देने में लगता है। आधुनिक AI मॉडल के लिए लेटेंसी को ms में मापा जाता है। पर्दे के पीछे, कुल लेटेंसी कई अलग-अलग प्रक्रियाओं से मिलकर बनती है, जिनमें से हर एक एंड-टू-एंड पाइपलाइन का एक हिस्सा देती है।
एक सामान्य कन्वर्सेशनल AI पाइपलाइन इस तरह होती है:
- यूज़र बोलता है
- स्पीच टू टेक्स्ट मॉडल ऑडियो को ट्रांसक्राइब करता है
- ट्रांसक्रिप्ट को LLM मॉडल को भेजा जाता है, जो जवाब तैयार करता है
- फिर LLM के टेक्स्ट को टेक्स्ट टू स्पीच मॉडल की मदद से ऑडियो में बदला जाता है
- फिर ऑडियो यूज़र को सुनाया जाता है
इनमें से हर चरण कन्वर्सेशनल AI सिस्टम में लेटेंसी जोड़ता है। इसलिए लेटेंसी पर चर्चा करते समय कुछ अलग-अलग संक्षिप्त शब्दों को समझना ज़रूरी है।
मॉडल इन्फ़रेंस लेटेंसी
मॉडल इन्फ़रेंस लेटेंसी वह समय है जो मॉडल आउटपुट जनरेट करने में लगाता है। इसे आंतरिक रूप से मापा जाता है और इसमें बाहरी कारक शामिल नहीं होते। यह मॉडल-विशिष्ट माप है कि सामान्य इनपुट पर आपका इंजन कितनी तेज़ी से काम करता है। उदाहरण के लिए, Flash v2.5 की मॉडल इन्फ़रेंस लेटेंसी लगभग 75 ms है। इससे आप प्रतिस्पर्धियों के मॉडल की गति की तुलना कर सकते हैं।
लेकिन ध्यान रखें कि यह वह लेटेंसी आंकड़ा नहीं है जिसे यूज़र वास्तव में अनुभव करता है। यह केवल मॉडल के आउटपुट जनरेट करने में लगे कुल समय को दर्शाता है।
LLM टाइम-टू-फर्स्ट-टोकन
लार्ज लैंग्वेज मॉडल (LLM) टाइम-टू-फर्स्ट टोकन (TTFT) वह कुल समय है जो लार्ज लैंग्वेज मॉडल को प्रॉम्प्ट प्रोसेस करने और आउटपुट का पहला उपयोगी टोकन जनरेट करने में लगता है।
आपके LLM से पहला टोकन आते ही TTS जनरेशन शुरू हो जाती है, इसलिए यह मापता है कि LLM को आपके TTS मॉडल को चलाने के लिए प्रॉम्प्ट देना शुरू करने में कितना समय लगता है। ज़्यादातर एंड-टू-एंड कन्वर्सेशनल AI सिस्टम में LLM TTFT कुल लेटेंसी का अहम हिस्सा होता है।
TTS टाइम-टू-फर्स्ट ऑडियो (TTFA)
TTS टाइम-टू-फर्स्ट ऑडियो (TTFA), पहली TTS रिक्वेस्ट से लेकर मॉडल से पहला ऑडियो चंक वास्तव में निकलने तक का समय मापता है। यह मॉडल इन्फ़रेंस लेटेंसी बताने का तरीका है, लेकिन खास तौर पर TTS इंजन के लिए।
एंड-टू-एंड टाइम-टू-फर्स्ट ऑडियो (TTFA)
एंड-टू-एंड TTFA कुल कन्वर्सेशनल AI लेटेंसी है। यह पाइपलाइन के हर हिस्से का योग है, जिसमें स्पीच रिकग्निशन, LLM TTFT, TTS, TTFA और चरणों के बीच होने वाले सभी नेटवर्क ट्रांसमिशन शामिल हैं। पूरी कन्वर्सेशनल AI लेटेंसी की बात करें, तो यूज़र इसी मेट्रिक को अनुभव करता है।
यूज़र के बोलने पर, उसे आपके एजेंट से कुछ सुनाई देने से पहले एंड-टू-एंड TTFA का इंतज़ार करना होगा। यह एक समग्र माप है, यानी पाइपलाइन के किसी भी हिस्से में सुधार से इसमें सुधार होगा।
कन्वर्सेशनल AI लेटेंसी क्यों महत्वपूर्ण है
जब यूज़र आपके AI एजेंट से बात करता है, तो उस अनुभव के बारे में उसकी राय बनाने में लेटेंसी एक अहम भूमिका निभाती है। कम लेटेंसी से जवाब का इंतज़ार कम होता है, बातचीत स्वाभाविक लगती है और आपका एजेंट सक्षम दिखता है।
ज़्यादा लेटेंसी वाले एजेंट कृत्रिम और कम सक्षम लगते हैं, भले ही उनके जवाबों की गुणवत्ता वही हो। व्यवसायों के लिए, कुछ 100 ms का अंतर भी बहुत लंबा लग सकता है और आपके कस्टमर सपोर्ट एजेंट को धीमा और अप्रभावी बना सकता है।
कन्वर्सेशनल AI लेटेंसी व्यवहार में क्यों मायने रखती है, इसे दिखाने के लिए कुछ स्थितियां यहां दी गई हैं:
- 500 ms से कम: कन्वर्सेशनल एजेंट तेज़ और सहज लगता है। यूज़र के बोलना बंद करने और पहला जवाब मिलने के बीच की देरी शायद महसूस न हो, जिससे बातचीत आसानी से चलती रहती है।
- 500 ms से 1000 ms: यूज़र के बोलना बंद करने और जवाब मिलने के बीच की देरी महसूस होने लग सकती है। यह बस थोड़ी ज़्यादा लंबी होती है, इसलिए यूज़र खुद को दोहराकर या रुककर यह देखने की कोशिश कर सकते हैं कि एजेंट ने उन्हें समझा भी है या नहीं।
- 1000 ms से अधिक: देरी धीमी लगने लगती है और कुछ यूज़र्स को लग सकता है कि AI एजेंट बातचीत की गति के साथ पूरी तरह नहीं चल पा रहा। ट्रांसक्रिप्ट में कभी-कभार बीच में रोकना या किसी मानव एजेंट से बात करने के अनुरोध दिख सकते हैं। कुछ मामलों में, यूज़र कॉल छोड़ सकते हैं।
इनमें से हर सीमा वास्तविक व्यावसायिक नतीजों में बदलती है।
लेटेंसी स्पेक्ट्रम के निचले छोर पर, आपके पास ऐसा कस्टमर सर्विस एजेंट होगा जो आने वाले सवालों को स्वाभाविक रूप से संभाल सके और यूज़र्स को बिना अतिरिक्त मदद के उनके सवाल हल करने में मदद कर सके। इससे आपके मानव एजेंटों का दबाव कम होता है और ग्राहक संतुष्टि ऊंची रहती है। लेटेंसी स्पेक्ट्रम के ऊपरी छोर पर, बहुत देर तक हिचकता हुआ दिखने वाला एजेंट आपके ग्राहकों को निराश करेगा।
हमने वॉइस एजेंट लेटेंसी बजट बेंचमार्क को एक दूसरे लेख में परिभाषित किया है, ताकि दिखाया जा सके कि P50 और P95 दोनों वैल्यू पर अच्छी लेटेंसी कैसी दिखती है।
कन्वर्सेशनल AI लेटेंसी किन कारणों से होती है?
कन्वर्सेशनल AI लेटेंसी एक ऐसा शब्द है जो कई अलग-अलग प्रक्रियाओं का सार बताता है, जिसमें हर हिस्सा कुल लेटेंसी में योगदान देता है। इसलिए कम लेटेंसी की रुकावट केवल बेहतर मॉडल चुनने से हल होने वाली समस्या नहीं, बल्कि सिस्टम-स्तर की समस्या है। आखिरकार, पाइपलाइन में कई मॉडल काम करते हैं।
डेवलपर्स के लिए, हमने वॉइस एजेंट लेटेंसी ऑप्टिमाइज़ेशन पर एक विस्तृत तकनीकी गाइड लिखी है, जिसका उपयोग करके आप एंड-टू-एंड टाइम-टू-फर्स्ट ऑडियो (TTFA) के हर चरण को बेहतर बना सकते हैं।
मुख्य पाइपलाइन के अलावा, टेलीफोनी और फंक्शन कॉलिंग जैसे अन्य कारक भी लेटेंसी बढ़ाते हैं, भले ही वे मॉडल इन्फ्रास्ट्रक्चर के अंदर के हिस्से न हों।
कन्वर्सेशनल AI लेटेंसी में योगदान देने वाले सभी कारकों का एक संक्षिप्त विवरण यहां है।
ऑटोमैटिक स्पीच रिकग्निशन
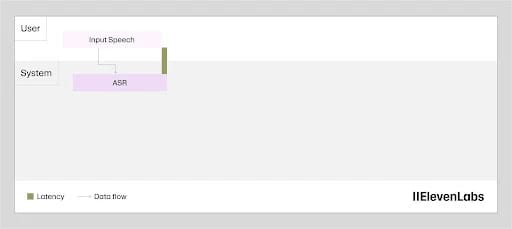
स्पीच रिकग्निशन की लेटेंसी, ट्रांसक्रिप्ट जनरेट करने में लगा समय नहीं है। यूज़र के बोलते समय ट्रांसक्रिप्शन प्रक्रिया बैकग्राउंड में चलती रहती है, इसलिए बोलना खत्म होने तक टेक्स्ट काफी हद तक तैयार होता है।
यहां लेटेंसी वास्तव में बोलना खत्म होने और ट्रांसक्रिप्ट को अंतिम रूप देकर अगले चरण में भेजे जाने के बीच का अंतर है। Scribe v2 Realtime इस अंतर को लगभग 150 ms तक लाता है और लगातार स्ट्रीम करता है, ताकि टर्न खत्म होते ही आउटपुट तैयार हो।
टर्न-टेकिंग और एंडपॉइंटिंग
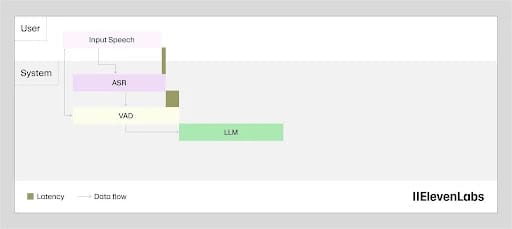
वॉइस एक्टिविटी डिटेक्टर (VAD) स्पीच रिकग्निशन और लैंग्वेज मॉडल के बीच काम करता है। इसका काम तय करना है कि यूज़र ने वास्तव में बोलना खत्म कर दिया है या नहीं।
गलतियों से बचने के लिए, VAD टर्न खत्म घोषित करने से पहले लगातार बनी रहने वाली चुप्पी की एक सीमा तक इंतज़ार करता है। यह इंतज़ार लैंग्वेज मॉडल के किसी शब्द को प्रोसेस करने से पहले जुड़ने वाली लेटेंसी है। यह थोड़ी अतिरिक्त लेटेंसी समय तो बढ़ाती है, लेकिन सिस्टम को यूज़र के बोलते रहने के दौरान जवाब देना शुरू करने से भी रोकती है।
तकनीकी रूप से कहें तो, अगर कन्वर्सेशनल AI के बाकी सभी कॉम्पोनेंट की लेटेंसी शून्य होती, तो टर्न-टेकिंग से जुड़ी लेटेंसी अच्छी होती। इंसान बात का जवाब देने से पहले एक पल रुकते हैं। मशीन का इसी तरह रुकना इंटरैक्शन को वास्तविक बनाता है। हालांकि, कन्वर्सेशनल AI के दूसरे कॉम्पोनेंट पहले से ही लेटेंसी जोड़ते हैं, इसलिए न्यूनतम लेटेंसी आदर्श है।
लैंग्वेज मॉडल प्रोसेसिंग
जब स्पीच टू टेक्स्ट (STT) इंजन से ट्रांसक्रिप्ट तैयार हो जाता है, तो लैंग्वेज मॉडल जवाब जनरेट करता है। यहां लेटेंसी पूरे जवाब को जनरेट करने में लगा समय नहीं, बल्कि टोकन जनरेट करना शुरू करने में लगा समय है। टोकन आते ही वे सीधे TTS चरण में स्ट्रीम होते हैं, इसलिए सबसे महत्वपूर्ण TTFT है।
मॉडल चुनने के अलावा, प्रॉम्प्ट की लंबाई और नॉलेज बेस का आकार भी इस चरण को प्रभावित करते हैं। LLM को जितना अधिक संदर्भ देखना होगा, उतना अधिक समय लगेगा। बड़े पैमाने पर ऐसे सिस्टम डिज़ाइन करते समय, गति बनाए रखने के लिए उपयोगी नॉलेज बेस और संक्षिप्त प्रॉम्प्ट के बीच सही संतुलन बनाना होगा।
स्पीच सिंथेसिस
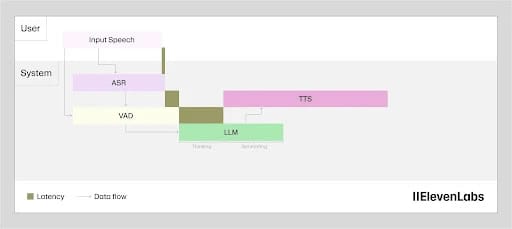
TTS लेटेंसी, लैंग्वेज मॉडल से पहले टोकन मिलने और ऑडियो शुरू होने के बीच का समय है। टोकन मानव आवाज़ के चलने की गति से तेज़ आते हैं, इसलिए सिंथेसिस मॉडल कभी पूरे जवाब का इंतज़ार नहीं करता। TTS लेटेंसी केवल पहले ऑडियो चंक तक का समय है।
पहले यह चरण कन्वर्सेशनल AI लेटेंसी में सबसे बड़ा योगदान देने वाला एकल चरण था, क्योंकि पुराने मॉडल को बोलना जनरेट करना शुरू करने में 2-3 सेकंड लगते थे। ElevenLabs का Flash v2.5 इस समस्या को सीधे हल करता है: यह ~75 ms लेटेंसी के साथ स्पीच सिंथेसिस देता है और इस बाधा को सेकंडों से घटाकर सेकंड के एक अंश तक ले आता है।
नेटवर्क लेटेंसी
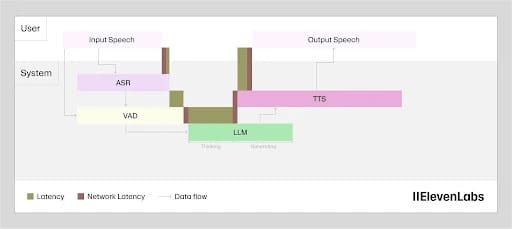
डेटा को एक स्थान से दूसरे स्थान पर भेजने से हमेशा लेटेंसी जुड़ती है, और भौगोलिक दूरी राउंड-ट्रिप नेटवर्क लेटेंसी को और बढ़ाती है।
एंड-टू-एंड जवाब के लिए कई कॉम्पोनेंट साथ काम करते हैं, इसलिए नेटवर्क हॉप के कई सेट में काफी लेटेंसी जमा हो सकती है।
फंक्शन कॉलिंग
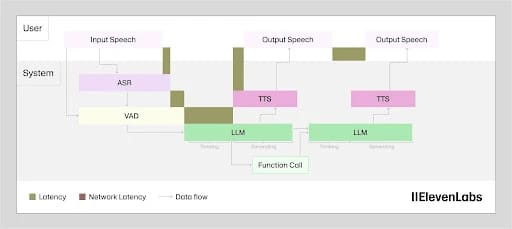
फंक्शन कॉल, LLM चरण में API राउंड-ट्रिप जोड़ते हैं। एक तेज़ आंतरिक लुकअप में कुछ दर्जन मिलीसेकंड जुड़ते हैं, जबकि पेमेंट प्रोसेसर या इन्वेंट्री सिस्टम में कई सेकंड लग सकते हैं। लेटेंसी पूरी तरह उस सर्विस पर निर्भर करती है जिसे कॉल किया जा रहा है, इसलिए इसे सीधे ऑप्टिमाइज़ करना सबसे कठिन चरण है।
सबसे प्रभावी तरीका LLM को टूल कॉल पूरा होने से पहले जवाब देने के लिए प्रॉम्प्ट करना है। "मैं आपके लिए यह जांचता हूं" जैसा वाक्य, बाहरी कॉल के पूरा होने तक यूज़र को जोड़े रखता है, बजाय इसके कि चुप्पी रहे। टूल के समानांतर चलते समय वॉइस रिस्पॉन्स शुरू हो जाता है।
कन्वर्सेशनल AI लेटेंसी कैसे कम करें
कन्वर्सेशनल AI लेटेंसी कम करने के लिए, असर के क्रम में पाइपलाइन के हर चरण पर काम करना होगा। अलग-अलग सुधार लेटेंसी पर असर डालते हैं, लेकिन सबसे बड़ा बदलाव देखने के लिए आपको पूरी पाइपलाइन को समग्र रूप से बेहतर बनाना होगा।
यहां कुछ सिद्धांत हैं जो उच्च स्तर पर कन्वर्सेशनल AI लेटेंसी कम करने में आपका मार्गदर्शन कर सकते हैं:
- TTS मॉडल चयन: Flash v2.5 जैसे गति के लिए ऑप्टिमाइज़ किए गए TTS मॉडल, गुणवत्ता के लिए ऑप्टिमाइज़ किए गए Eleven v3 और Eleven v4 जैसे मॉडल से अलग आर्किटेक्चर का उपयोग करते हैं। रियल-टाइम वॉइस एजेंट के लिए सही विकल्प वह उच्चतम-गुणवत्ता वाला मॉडल है जो आपके लेटेंसी लक्ष्य को पूरा करे—और यह लगभग हमेशा गति के लिए ऑप्टिमाइज़ किया गया मॉडल होता है।
- LLM मॉडल चयन: छोटे और तेज़ LLM आमतौर पर बड़े LLM की तुलना में कम टाइम-टू-फर्स्ट-टोकन देते हैं। ऐसा सबसे तेज़ LLM चुनना जो काम के लिए आपके गुणवत्ता मानक को भी पूरा करता हो, TTS मॉडल चुनने जितना ही महत्वपूर्ण है।
- स्ट्रीमिंग: स्ट्रीमिंग TTS, सिंथेसिस के दौरान ऑडियो को चंक में लौटाता है, इसलिए मॉडल के बाकी ऑडियो जनरेट करते रहने पर भी यूज़र पहला शब्द सुन लेता है। यह अवधारणा LLM आउटपुट पर भी लागू होती है: लैंग्वेज मॉडल के अगले वाक्य जनरेट करने के दौरान पहले वाक्य पर TTS सिंथेसिस शुरू करने से पाइपलाइन की लेटेंसी कम हो सकती है।
- सिस्टम प्रॉम्प्ट डिज़ाइन: यूज़र सिस्टम प्रॉम्प्ट को सरल बना सकते हैं और निर्देशों को हर निर्णय चरण का हिस्सा रखने के बजाय प्रक्रियाओं या वर्कफ़्लो में डाल सकते हैं। इससे हर टर्न पर मॉडल को समझने के लिए कम संदर्भ चाहिए होता है।
- गार्डरेल्स: गार्डरेल्स को स्ट्रीमिंग मॉडल में चलाने पर, गार्डरेल जांच पूरी होने से पहले ही आउटपुट चलना शुरू हो सकता है, बजाय इसके कि जांच पूरी होने तक प्लेबैक रुका रहे।
- मॉडल कोलोकेशन: जहां संभव हो, कोलोकेटेड मॉडल का उपयोग करें, जैसे ElevenLabs Agents स्टैक। इससे कॉम्पोनेंट एक-दूसरे के पास रहते हैं और अलग-अलग होस्ट किए गए मॉडल के बीच हॉप से लेटेंसी नहीं जुड़ती।
- भौगोलिक स्थिति: आपके सर्वर और यूज़र्स के बीच कम दूरी लेटेंसी को काफी घटा सकती है, क्योंकि इससे एंड-टू-एंड TTFA में नेटवर्क का योगदान सीधे कम होता है।
इन कारकों के अलावा, अधिक जानकारी के लिए आप लेटेंसी ऑप्टिमाइज़ करने की इस तकनीकी गाइड का उपयोग कर सकते हैं।
ElevenAgents पर कम-लेटेंसी वाले कन्वर्सेशनल AI के साथ शुरुआत करें
एजेंट बनाते और तैनात करते समय कन्वर्सेशनल AI लेटेंसी एक बहुत महत्वपूर्ण पहलू है। ElevenAgents में लेटेंसी ऑप्टिमाइज़ेशन प्रक्रिया में ही शामिल है। समय बचाने वाली ओवरलैप तकनीकों से लेकर अलग-अलग कॉम्पोनेंट की कम मॉडल इन्फ़रेंस लेटेंसी तक, ElevenAgents आपके व्यवसाय के लिए कम-लेटेंसी वाले कन्वर्सेशनल AI स्टैक बनाता है।
अंततः लक्ष्य वास्तविकता जैसा अनुभव बनाना है। यूज़र को कंप्यूटर प्रोग्राम के फायदे मिलते हुए, इंसान से बात करने की सहजता महसूस होनी चाहिए। उप-प्रक्रियाओं को बेहतर बनाकर यह अब संभव है।
इसके बारे में और जानें: ElevenAgents या सेल्स से संपर्क करें और आज ही शुरुआत करें।
कन्वर्सेशनल AI लेटेंसी FAQ

Jack Limebear हमारी ग्रोथ टीम में हैं और ब्लॉग व इनसाइट्स पेज के लिए कंटेंट राइटर और स्ट्रैटेजिस्ट के तौर पर काम करते हैं। ElevenLabs से पहले, उन्होंने दस साल से ज़्यादा समय तक तेज़ी से बढ़ती SaaS स्टार्टअप्स से लेकर Fortune 500 कंपनियों तक के लिए कंटेंट स्ट्रैटेजी लीड की है। उनके पास यूनिवर्सिटी ऑफ़ कैम्ब्रिज से इंग्लिश लिटरेचर में मास्टर डिग्री है।