Stream tworzy multimodalnych agentów AI z ElevenLabs
- Autor
- Fergal Burnett Small
- Opublikowano
PosłuchajPosłuchaj tego artykułu
Stream wprowadził Vision Agents – framework open source, który pozwala deweloperom tworzyć niskolatencyjne, multimodalne doświadczenia AI łączące wideo, audio i rozmowę w czasie rzeczywistym. Framework integruje ElevenLabs Text to Speech, by zapewniać ekspresyjne, responsywne głosy umożliwiające płynną interakcję między użytkownikami a systemami AI.
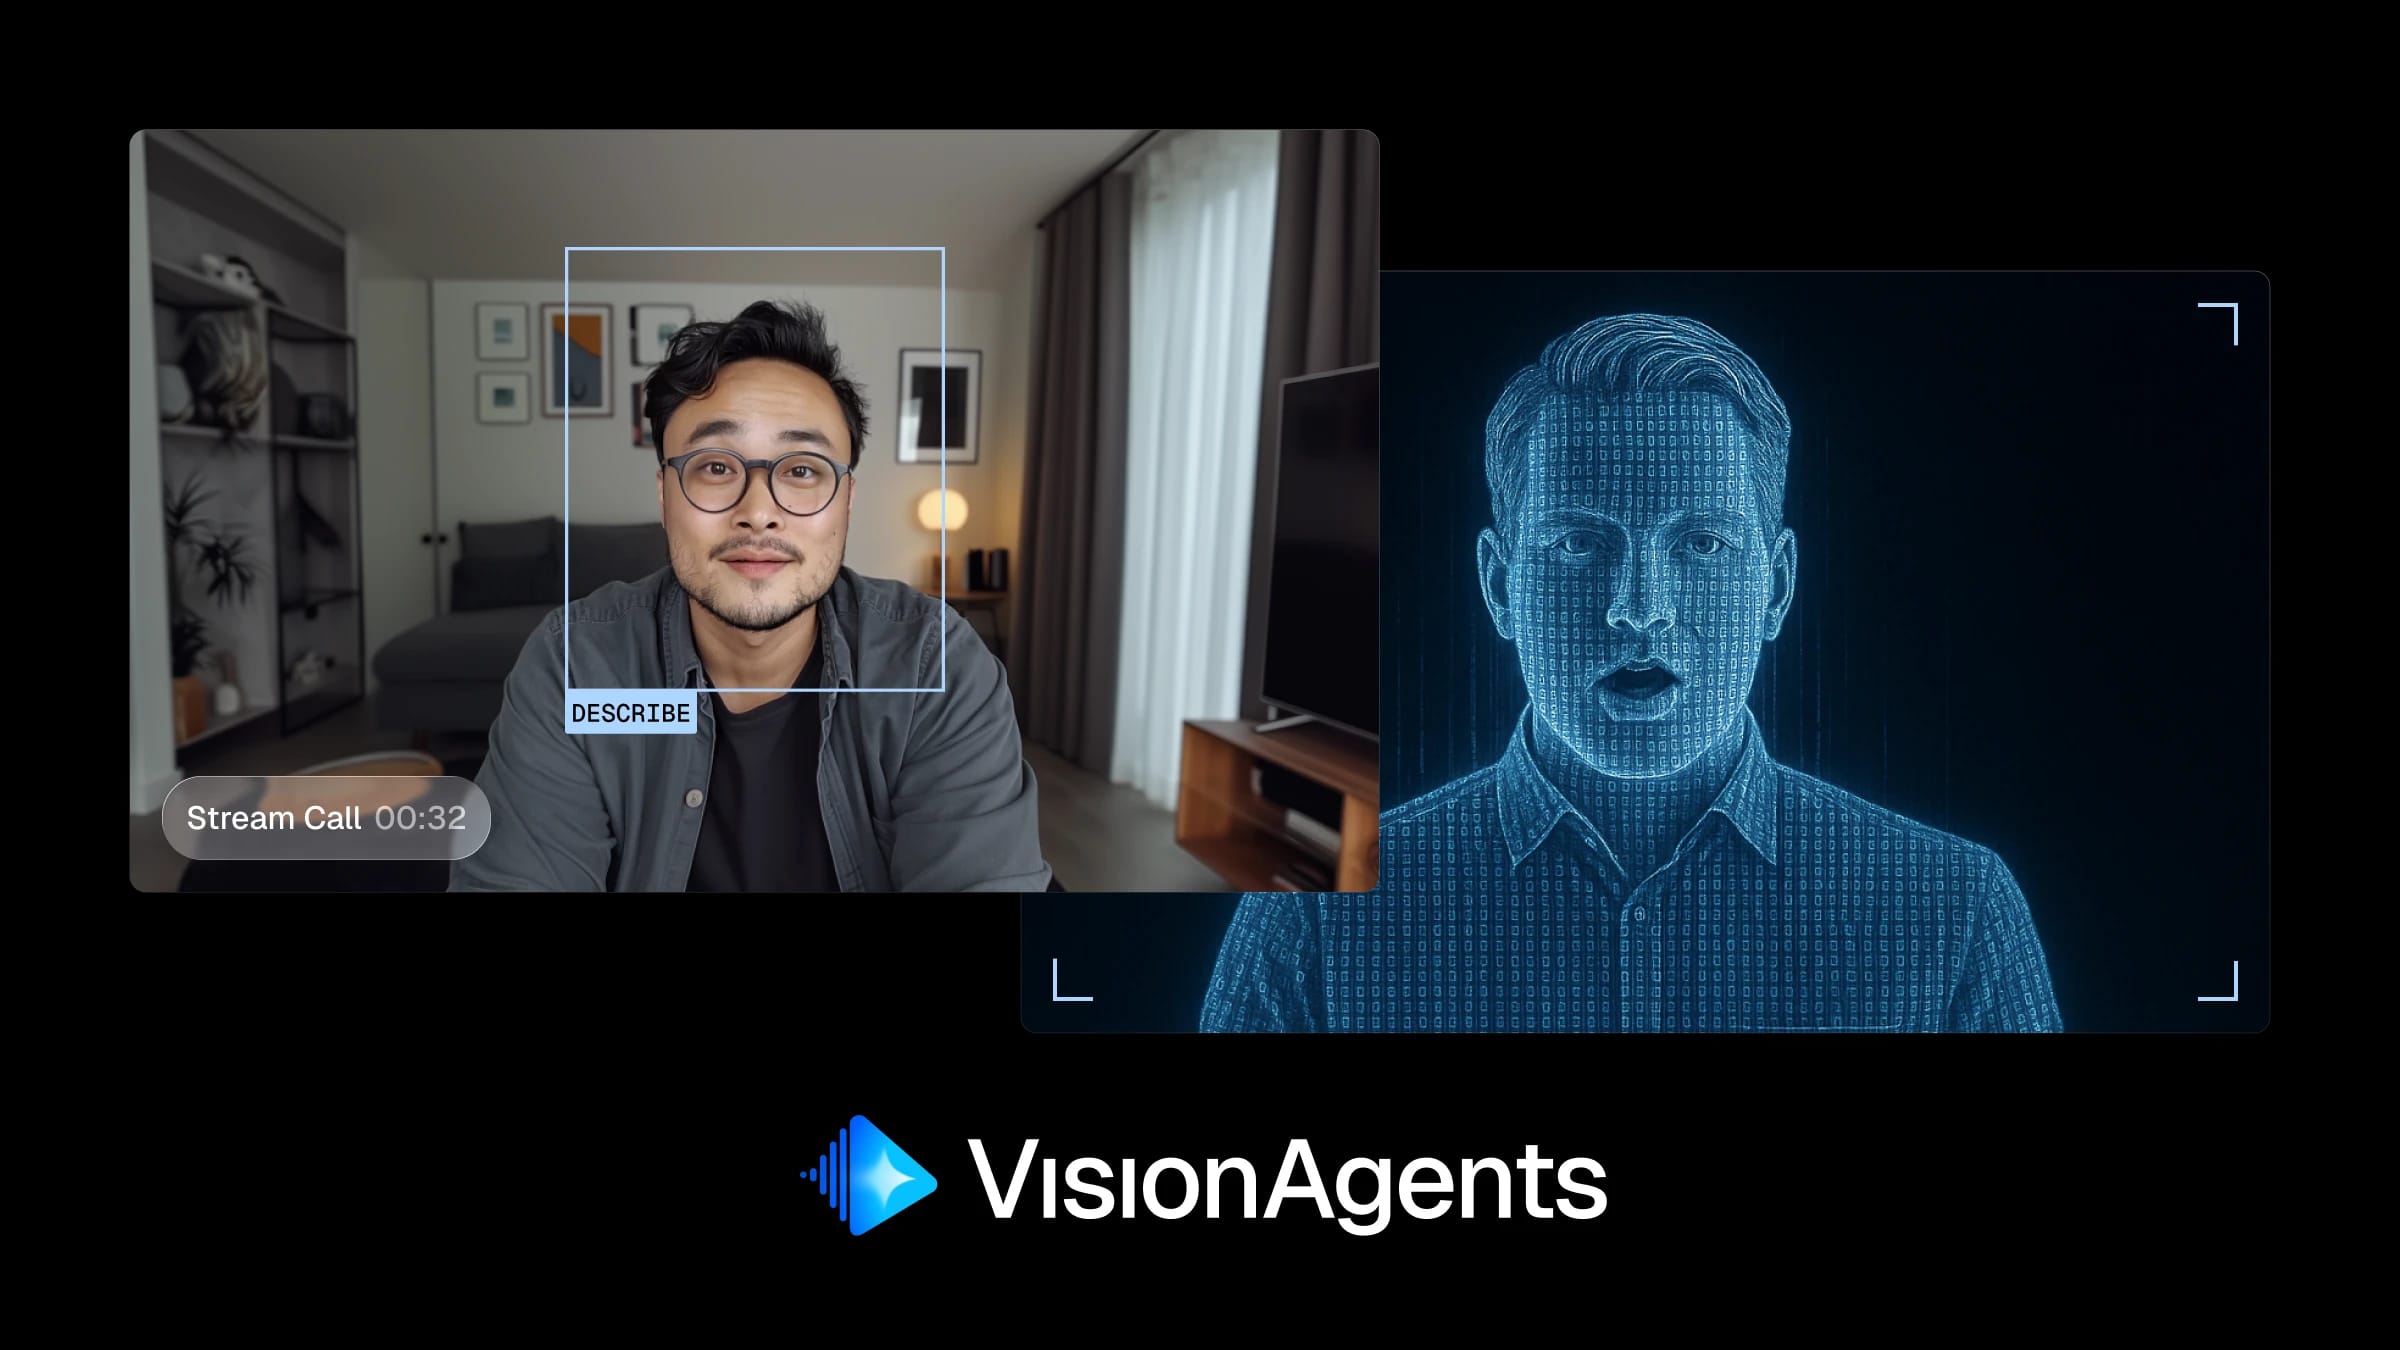
Multimodalni agenci działający w czasie rzeczywistym
Vision Agents daje AI możliwość widzenia, słyszenia i reagowania w czasie rzeczywistym. Framework oparty na SDK Stream do wideo i audio zapewnia deweloperom niskolatencyjną bazę do prototypowania i wdrażania multimodalnych agentów.
Oceniając dostawców Text to Speech, Stream wybrał ElevenLabs ze względu na wiodącą na rynku jakość i łatwość integracji. ElevenLabs jest teraz główną opcją głosową dla użytkowników Stream.
„ElevenLabs ułatwiło nam szybkie dodanie zaawansowanych funkcji zamiany tekstu na mowę do naszego SDK, dzięki czemu Agents mogą reagować w czasie rzeczywistym ekspresyjnymi głosami na pytania użytkowników lub na to, co widzą.” – Neevash Ramdial, dyrektor marketingu, Stream
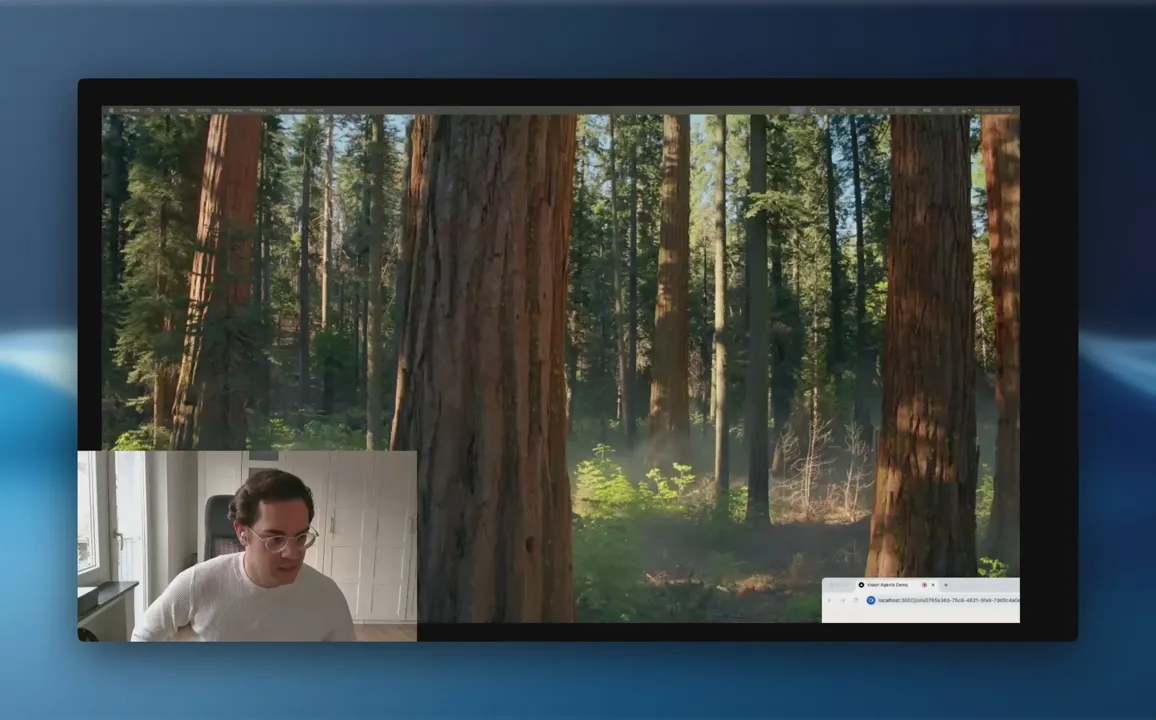
Szybka, niezawodna i przyjazna deweloperom integracja
Stream zintegrował ElevenLabs z całym swoim kodem w zaledwie kilka dni, dzięki czemu deweloperzy mogą dodać realistyczny głos do swoich agentów Vision przy minimalnej konfiguracji. Integracja zapewnia teraz:
- Konfiguracja 10x szybsza – Wstępna integracja z ElevenLabs skraca czas konfiguracji głosu z 400 do zaledwie 40 linii kodu.
- Niskie opóźnienia – Szybkie generowanie głosu przez ElevenLabs w połączeniu z globalną siecią edge Stream zapewnia naturalną, ludzką responsywność.
- Skalowalne doświadczenie dla deweloperów – SDK Stream upraszczają tworzenie, testowanie i wdrażanie multimodalnych agentów.
Przyszłość multimodalnego AI
Vision Agents od Stream pokazują, jak modele ElevenLabs poszerzają możliwości multimodalnego AI. Łącząc rozumienie obrazu z Text to Speech, deweloperzy mogą tworzyć agentów, którzy nie tylko widzą, lecz także mówią i słuchają z płynnością zbliżoną do ludzkiej.
Chcesz tworzyć z Text to Speech? Skontaktuj się z nami tutaj.
Fergal jest w zespole Growth – pomaga wprowadzać nasze badania i produkty do świata i do rąk użytkowników.