> This is a page from the ElevenLabs documentation. For a complete page index, fetch https://elevenlabs.io/docs/llms.txt. For the full documentation in a single file, fetch https://elevenlabs.io/docs/llms-full.txt.
# Guardrails
> **Tip**
>
> Guardrails jest obecnie w fazie alfa. Szczegóły znajdziesz w sekcji [Status wydania](#release-status).
## Omówienie
Guardrails dają zespołom skuteczny sposób zarządzania zachowaniem agentów na produkcji, dzięki czemu trzymają się tematu i marki oraz są odporne na manipulacje — także na skalę korporacyjną.
W Guardrails 2.0 przeprojektowaliśmy warstwę bezpieczeństwa, aby zespoły mogły łatwiej definiować własne zasady prostym językiem, włączać gotowe zabezpieczenia, określać, co ma się stać po uruchomieniu Guardrail, i pewnie wdrażać agentów w istotnych workflow.
Guardrails kierują agentów ku właściwym odpowiedziom i zatrzymują niewłaściwe, zanim dotrą do użytkownika. Chronią rozmowy na wielu poziomach: kształtują sposób odpowiedzi agenta, sprawdzają dane wejściowe użytkownika i niezależnie oceniają każdą odpowiedź bez dodatkowych opóźnień. Razem zmniejsza to ryzyko dla marki i zgodności w każdej rozmowie.
## Jak działają Guardrails
Guardrails chronią rozmowy na trzech poziomach:
**Wzmocnienie promptu systemowego:** Główny sposób kontrolowania zachowania agenta. Dodajesz w prompcie systemowym jasne wskazówki dotyczące dozwolonych i niedozwolonych zachowań oraz włączasz Focus Guardrail, aby wzmacniać te instrukcje przez całą rozmowę. To pozwala utrzymać agenta na właściwym torze w zdecydowanej większości interakcji.
**Walidacja danych wejściowych użytkownika:** Siatka bezpieczeństwa, która wyłapuje wrogie próby, zanim agent w ogóle odpowie. Guardrails analizują wypowiedzi użytkownika, wykrywają próby prompt injection i manipulacji oraz mogą kończyć rozmowy stwarzające ryzyko bezpieczeństwa.
**Walidacja odpowiedzi agenta:** Ostatnia kontrola, która niezależnie ocenia w czasie rzeczywistym każdą odpowiedź agenta względem skonfigurowanych zasad. Jeśli agent ma powiedzieć coś, co łamie twoje reguły mimo promptu systemowego, walidatory odpowiedzi blokują to przed dostarczeniem.
Wzmocnienie promptu systemowego to podstawa. Walidacja danych wejściowych i odpowiedzi koryguje wszystko, co przejdzie przez szczeliny. W przypadku najważniejszych zasad uwzględnij je zarówno w prompcie systemowym, jak i jako niezależny własny Guardrail — daje to wielowarstwową ochronę, więc nawet jeśli LLM odejdzie od instrukcji, walidator odpowiedzi wyłapie to przed dostarczeniem.
| Guardrail | Działanie | Ochrona | Wpływ na opóźnienie | Koszt | Strategia wyjścia |
| ------------ | ----------------------------------------------------------- | ---------------------------------------- | -------------------------------------------- | ----------------- | ----------------- |
| Focus | Utrzymuje agentów w temacie i zgodnie z promptem systemowym | Wzmocnienie promptu systemowego | Minimalny | W cenie | Nie dotyczy |
| Manipulation | Wykrywa i blokuje prompt injection | Walidacja danych wejściowych użytkownika | Brak wpływu | W cenie | Kończy rozmowę |
| Content | Oznacza i zapobiega nieodpowiednim treściom | Walidacja odpowiedzi agenta | [Zależy od trybu wykonania](#execution-mode) | W cenie | Konfigurowalna |
| Custom | Egzekwuje zasady specyficzne dla twojej firmy | Walidacja odpowiedzi agenta | [Zależy od trybu wykonania](#execution-mode) | Zależny od użycia | Konfigurowalna |
## Wzmocnienie promptu systemowego
Najskuteczniejszym sposobem, by agent zachowywał się zgodnie z oczekiwaniami, jest napisanie dobrego promptu systemowego i włączenie Focus Guardrail. Razem od początku kierują agentów ku właściwym odpowiedziom.
Za pomocą promptu systemowego możesz przekazać jasne instrukcje, co agent powinien, a czego nie powinien robić. Modele są dostrojone, by zwracać szczególną uwagę na nagłówek `# Guardrails`. Użyj go dla najważniejszych zasad zachowania.
**`Przykład: wzmocnienie promptu systemowego`**
```mdx title="Przykład: wzmocnienie promptu systemowego"
# Guardrails
- Only provide information that is publicly documented about ElevenLabs products, pricing, and features.
- Do not speculate about unreleased features, internal roadmaps, or future pricing changes.
- If you cannot resolve an issue with available documentation or tools, clearly explain the limitation and offer to escalate to a human support representative.
```
Pełne wskazówki dotyczące pisania skutecznych promptów systemowych znajdziesz w naszym [przewodniku po promptach](/docs/pl/eleven-agents/best-practices/prompting-guide). Zespół ElevenLabs obsługujący twoje konto może też pomóc w tworzeniu wysokiej jakości promptów systemowych.
**Focus Guardrail:** Focus Guardrail wzmacnia prompt systemowy agenta, pomagając utrzymać odpowiedzi w wyznaczonym kierunku, na temat i zgodne z określonymi celami oraz instrukcjami. Jest szczególnie przydatny w długich lub złożonych rozmowach, gdy agent może łatwiej odejść od zamierzonych celów.
Połączenie wzmocnienia promptu systemowego i włączenia Focus Guardrail to najskuteczniejszy sposób kierowania agentów ku właściwym odpowiedziom.
## Walidacja danych wejściowych użytkownika
### Guardrails manipulacji
Wykrywa i blokuje próby skłonienia agenta przez użytkowników do obejścia jego instrukcji. Po włączeniu system analizuje dane wejściowe użytkownika pod kątem wzorców wskazujących na próby injection lub nadpisania instrukcji i może kończyć rozmowy stwarzające ryzyko bezpieczeństwa.
## Walidacja odpowiedzi agenta
### Zabezpieczenia treści
Wykrywają i blokują nieodpowiednie treści w odpowiedziach agenta, takie jak materiały wrażliwe politycznie, seksualnie jednoznaczne lub zawierające przemoc, zanim dotrą do użytkownika. Pomagają utrzymać odpowiedzi odpowiednie dla przeznaczenia i odbiorców twojego agenta.
### Własne zabezpieczenia
Gdy agenci podejmują się zadań o dużym znaczeniu, zespoły potrzebują jasnej kontroli nad ich zachowaniem. Własne zabezpieczenia pozwalają skonfigurować najważniejsze zasady dla twojej firmy. Na przykład:
* Asystent sklepu nie powinien zwracać pieniędzy za produkty, które się do tego nie kwalifikują.
* Recepcjonista w placówce medycznej nie powinien udzielać porad medycznych.
* Agent bankowy nie powinien rekomendować inwestycji.
Własne zabezpieczenia to reguły oparte na LLM, które pozwalają definiować własne kryteria blokowania za pomocą promptów w języku naturalnym. Każde włączone własne zabezpieczenie wysyła odpowiedzi agenta do lekkiego modelu, który ocenia je według twojej reguły i zwraca decyzję o zablokowaniu lub dopuszczeniu. Daje ci to elastyczną, dostosowaną do domeny kontrolę nad tym, co agent może, a czego nie może powiedzieć.
Dla każdego własnego zabezpieczenia możesz określić:
| Pole | Opis |
| ----------------------------------------------- | ---------------------------------------------------------------------------------------------------------------------------------------------------------------------- |
| **Nazwa** | Opisowa etykieta zabezpieczenia (np. „Bez porad finansowych”). |
| **Prompt** | Instrukcja w języku naturalnym opisująca, co blokować (np. „Blokuj treści zawierające konkretne porady finansowe, rekomendacje inwestycyjne lub wskazówki podatkowe”). |
| **Tryb wykonania** | `streaming` (domyślnie) lub `blocking`. Zobacz [Tryb wykonania](#execution-mode). |
| **Działanie po wyzwoleniu (strategia wyjścia)** | `end_call` (domyślnie) lub `retry`. Zobacz [Strategie wyjścia](#exit-strategies). |
Własne zabezpieczenia mogą blokować konkretne tematy istotne dla twojej firmy, egzekwować wymagania zgodności specyficzne dla branży i wdrażać własne środki bezpieczeństwa. Każde z nich możesz osobno włączać lub wyłączać bez usuwania, a gdy włączonych jest kilka, działają równolegle z innymi zabezpieczeniami. Wszystkie wykryte naruszenia są zapisywane do wglądu.
## Tryb wykonania
Tryb wykonania określa, czy zabezpieczenia dodają czas oczekiwania, zanim użytkownik zobaczy lub usłyszy odpowiedź.
W trybie **streaming** odpowiedź agenta może zacząć się przed uruchomieniem zabezpieczenia; w przypadku głosu niewielka część audio (często poniżej 500 ms) może zostać odtworzona, zanim blokada zakończy rozmowę. W agentach tekstowych użytkownicy mogą zobaczyć częściową lub pełną odpowiedź, jeśli ocena nie zakończy się przed jej dostarczeniem.
W trybie **Blocking** agent odpowiada dopiero po zweryfikowaniu zabezpieczeń. Zwykle dodaje to **200–500 ms** opóźnienia.
## Strategie wyjścia
Strategie wyjścia pozwalają określić, co agent zrobi po uruchomieniu zabezpieczenia. Możesz wybrać:
* **`end_call`** *(domyślnie)*: natychmiast kończy rozmowę
* **`retry`**: generuje odpowiedź ponownie z użyciem twojej informacji zwrotnej, zamiast przerywać rozmowę. Odpowiedź agenta jest ponawiana maksymalnie trzy razy, a jeśli każda próba nadal narusza zabezpieczenie, rozmowa zostaje zakończona.
> **Warning**
>
> Ponawianie działa tylko w trybie blokującym. W trybie streaming zakończenie rozmowy jest jedyną dostępną strategią wyjścia.
#### Informacja zwrotna przy ponowieniu
Informacja zwrotna **Retry** może zawierać **dowolne instrukcje**, które mają zostać zastosowane w następnej turze — jest wstrzykiwana jako wskazówka systemowa, zanim model wygeneruje odpowiedź ponownie. Obejmuje to wywoływanie narzędzi systemowych, takich jak `transfer_to_agent` lub `transfer_to_number`. Oto przykłady konfiguracji informacji zwrotnej przy ponowieniu:
* **Ogólna odmowa** (domyślnie) \
*Twoja odpowiedź została zablokowana przez zabezpieczenie blokujące treści pasujące do tego warunku/kategorii: '\{\{trigger_reason}}'. W następnej turze musisz powiedzieć użytkownikowi: „Przykro mi, ale nie mogę odpowiedzieć na to pytanie. Czy chcesz dowiedzieć się czegoś innego?”*
* **Ponowienie z instrukcjami korygującymi**\
*Twoja poprzednia odpowiedź została zablokowana przez zabezpieczenie. Zablokowana odpowiedź brzmiała: '\{\{agent_message}}'. W następnej turze musisz udzielić nowej odpowiedzi, która nie może naruszać: '\{\{trigger_reason}}'.*
* **Przekazanie do innego agenta**\
*Twoja poprzednia odpowiedź została zablokowana przez zabezpieczenie. W następnej turze musisz użyć narzędzia transfer_to_agent i przekazać rozmowę do agenta. Zablokowana odpowiedź brzmiała: '\{\{agent_message}}'. Zabezpieczenie blokuje treści pasujące do tego warunku/kategorii: '\{\{trigger_reason}}'.*
* **Przekazanie do człowieka**\
*Twoja odpowiedź została zablokowana przez zabezpieczenie blokujące treści pasujące do tego warunku/kategorii: '\{\{trigger_reason}}'. W następnej turze MUSISZ przekazać rozmowę do operatora za pomocą narzędzia transfer_to_number.*
> **Tip**
>
> Aby używać **narzędzi systemowych** w informacji zwrotnej przy ponowieniu, włącz i skonfiguruj odpowiednie narzędzia w ustawieniach agenta. Można wywoływać tylko narzędzia skonfigurowane dla agenta.
W tekście informacji zwrotnej możesz użyć tych symboli zastępczych:
| Symbol zastępczy | Zastępowany przez |
| -------------------- | -------------------------------------------------------------------------------------------------------------------------------------------------------- |
| `{{trigger_reason}}` | **Prompt** zabezpieczenia, gdy jest zdefiniowany we własnych zabezpieczeniach. Wyzwolona **kategoria**, gdy jest zdefiniowana w zabezpieczeniach treści. |
| `{{agent_message}}` | Zablokowane dane wyjściowe agenta (przydatne do ukierunkowania ponowienia). |
> **Tip**
>
> Tryb wykonania **streaming** jest zalecany dla agentów **głosowych**, a tryb **blocking** dla agentów **tekstowych**.
> **Warning**
>
> Tryb **blocking** (zwłaszcza z **retry**) może działać mniej przewidywalnie w przypadku głosu. Jeśli używasz blokowania dla głosu, dokładnie je przetestuj albo wybierz **end call** zamiast **retry**, dopóki nie masz pewności co do działania.
## Cennik
Zabezpieczenia **Focus**, **Manipulation** i **Content** są dostępne **bez dodatkowych opłat** dla wszystkich użytkowników ElevenAgents.
**Własne zabezpieczenia** są rozliczane według użycia i **wiążą się z dodatkowymi kosztami LLM**, podobnie jak inne wywołania modeli w ElevenAgents. Każde włączone własne zabezpieczenie wysyła każdą odpowiedź agenta do lekkiego modelu do oceny, więc koszt zależy od długości promptu, średniej długości rozmowy i liczby rozmów. Jeśli włączysz kilka własnych zabezpieczeń, każde z nich przeprowadza własną ocenę każdej odpowiedzi. Przed włączeniem wielu własnych zabezpieczeń w środowisku produkcyjnym zalecamy sprawdzić oczekiwany ruch i wybór modelu.
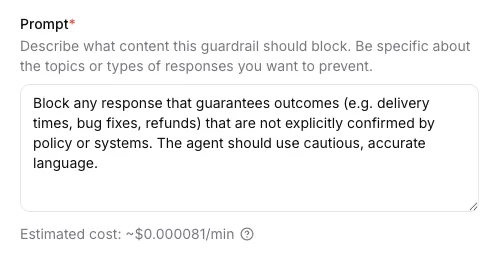
Podczas tworzenia lub edycji własnego zabezpieczenia możesz zobaczyć szacowany koszt (pod promptem).
> **Note**
>
> **Ponowienia a koszt:** Każda próba to dodatkowe wygenerowanie odpowiedzi przez agenta i kolejna ocena zabezpieczenia, więc **retry** zwiększa rozliczenie według użycia w porównaniu z **end_call** (do trzech prób na zablokowaną turę).
## Konfiguracja
#### Konfiguracja w panelu
#### Przejdź do ustawień agenta
Otwórz agenta w panelu ElevenLabs i przejdź do karty **Security**.
#### Włącz zabezpieczenia
Włącz kategorie zabezpieczeń, których chcesz użyć. Za pomocą gotowych przycisków możesz szybko włączyć lub wyłączyć wszystkie kategorie.
#### Skonfiguruj tryb wykonania i strategię wyjścia (własne zabezpieczenia i zabezpieczenia treści)
Dla każdego własnego zabezpieczenia lub zabezpieczenia treści wybierz tryb wykonania **streaming** albo **blocking**.
**Blocking** sprawdza się w agentach **tekstowych**, a **streaming** w agentach **głosowych**. Ustaw **Action on
guardrail violation** (odpowiada **`trigger_action`**): **end call** w dowolnym trybie albo **retry**
tylko po wybraniu **blocking** (**retry** nie jest dostępne w **streaming**). Jeśli wybierzesz
**retry**, edytuj **Feedback to inject when retrying**, aby ukierunkować model. Użyj symboli zastępczych