> This is a page from the ElevenLabs documentation. For a complete page index, fetch https://elevenlabs.io/docs/llms.txt. For the full documentation in a single file, fetch https://elevenlabs.io/docs/llms-full.txt.
# Guardrails
## Overzicht
Guardrails bieden teams een krachtige manier om te bepalen hoe agents zich in productie gedragen, zodat ze bij het onderwerp en het merk blijven en op ondernemingsschaal bestand zijn tegen manipulatie.
Met Guardrails 2.0 hebben we de veiligheidslaag opnieuw ontworpen, zodat teams eenvoudiger aangepaste beleidsregels in gewone taal kunnen definiëren, ingebouwde beschermingen kunnen inschakelen, kunnen bepalen wat er gebeurt wanneer een guardrail wordt geactiveerd en agents met vertrouwen kunnen uitrollen in workflows met grote impact.
Guardrails sturen agents naar de juiste reacties en houden verkeerde reacties tegen voordat ze de gebruiker bereiken. Ze beschermen gesprekken op meerdere lagen: ze bepalen hoe de agent reageert, valideren gebruikersinvoer en beoordelen elke reactie onafhankelijk zonder latentie toe te voegen. Samen verkleint dit het merk- en compliancerisico in elk gesprek.
## Hoe guardrails werken
Guardrails beschermen gesprekken op drie niveaus:
**Versterking van de systeemprompt:** De belangrijkste manier om het gedrag van een agent te sturen. Je voegt expliciete richtlijnen toe aan de systeemprompt over toegestaan en niet-toegestaan gedrag, en schakelt de Focus Guardrail in om deze instructies gedurende het gesprek te versterken. Hierdoor blijft je agent in de overgrote meerderheid van de interacties op koers.
**Validatie van gebruikersinvoer:** Een vangnet dat vijandige pogingen onderschept voordat de agent reageert. Guardrails analyseren wat de gebruiker zegt, detecteren pogingen tot prompt injection en manipulatie, en kunnen gesprekken beëindigen die een beveiligingsrisico vormen.
**Validatie van agentreacties:** Een laatste controle die elke reactie van de agent realtime onafhankelijk beoordeelt aan de hand van je geconfigureerde beleidsregels. Als de agent ondanks de systeemprompt iets dreigt te zeggen dat je regels schendt, blokkeren responsvalidators dit vóór verzending.
Versterking van de systeemprompt is de basis. Validatie van invoer en reacties corrigeert alles wat door de mazen van het net glipt. Neem je belangrijkste regels zowel op in je systeemprompt als in een onafhankelijke aangepaste Guardrail. Zo creëer je gelaagde bescherming: zelfs als het LLM afwijkt van zijn instructies, onderschept de responsvalidator dit vóór verzending.
| Guardrail | Wat deze doet | Bescherming | Invloed op latentie | Kosten | Exitstrategie |
| ------------ | -------------------------------------------------------------- | ------------------------------ | --------------------------------------------------- | -------------------- | ----------------- |
| Focus | Houdt agents bij het onderwerp en in lijn met je systeemprompt | Versterking van systeemprompt | Minimaal | Inbegrepen | N.v.t. |
| Manipulation | Detecteert en blokkeert prompt injection | Validatie van gebruikersinvoer | Geen effect | Inbegrepen | Beëindigt gesprek |
| Content | Markeert en voorkomt ongepaste content | Validatie van agentreacties | [Afhankelijk van uitvoeringsmodus](#execution-mode) | Inbegrepen | Configureerbaar |
| Custom | Handhaaft je bedrijfsspecifieke beleidsregels | Validatie van agentreacties | [Afhankelijk van uitvoeringsmodus](#execution-mode) | Op gebruik gebaseerd | Configureerbaar |
## Versterking van de systeemprompt
De effectiefste manier om je agent zich zoals bedoeld te laten gedragen, is een goede systeemprompt schrijven en de Focus Guardrail inschakelen. Samen sturen ze agents vanaf het begin naar de juiste reacties.
Je kunt de systeemprompt gebruiken om expliciete instructies te geven over wat je agent wel en niet moet doen. Modellen zijn afgestemd om extra aandacht te besteden aan de kop `# Guardrails`. Gebruik deze kop voor je belangrijkste gedragsregels.
**`Voorbeeld: versterking van de systeemprompt`**
```mdx title="Voorbeeld: versterking van de systeemprompt"
# Guardrails
- Only provide information that is publicly documented about ElevenLabs products, pricing, and features.
- Do not speculate about unreleased features, internal roadmaps, or future pricing changes.
- If you cannot resolve an issue with available documentation or tools, clearly explain the limitation and offer to escalate to a human support representative.
```
Voor uitgebreide richtlijnen voor het schrijven van effectieve systeemprompts, bekijk onze [gids voor prompting](/docs/nl/eleven-agents/best-practices/prompting-guide). Je ElevenLabs-accountteam kan je ook ondersteunen bij het opstellen van hoogwaardige systeemprompts.
**Focus Guardrail:** De Focus Guardrail versterkt de systeemprompt van je agent en helpt reacties gericht, relevant en consistent met je vastgestelde doelen en instructies te houden. Dit is vooral nuttig bij lange of complexe gesprekken, waarin de kans groter is dat de agent afwijkt van de beoogde doelen.
De combinatie van versterking van de systeemprompt en het inschakelen van de Focus Guardrail is de effectiefste manier om agents naar de juiste reacties te sturen.
## Validatie van gebruikersinvoer
### Manipulation Guardrails
Detecteert en blokkeert pogingen van gebruikers om de agent te manipuleren zodat deze zijn instructies omzeilt. Wanneer deze is ingeschakeld, analyseert het systeem gebruikersinvoer op patronen die duiden op pogingen tot injectie of het overschrijven van instructies, en kan het gesprekken beëindigen die een beveiligingsrisico vormen.
## Validatie van agentreacties
### Content guardrails
Markeert en voorkomt ongepaste content in agentreacties, zoals politiek gevoelige, seksueel expliciete of gewelddadige inhoud, voordat deze de gebruiker bereikt. Dit helpt reacties passend te houden voor het beoogde gebruiksscenario en publiek van je agent.
### Aangepaste guardrails
Naarmate agents werk met grote impact oppakken, hebben teams duidelijke controle nodig over hoe ze zich gedragen. Met aangepaste Guardrails kun je de belangrijkste beleidsregels voor je bedrijf configureren. Bijvoorbeeld:
* Een retailassistent mag geen terugbetalingen uitvoeren voor artikelen die hiervoor niet in aanmerking komen.
* Een receptioniste in de zorg mag geen medisch advies geven.
* Een bankagent mag geen beleggingen aanbevelen.
Aangepaste Guardrails zijn regels op basis van LLM's waarmee je je eigen blokkeercriteria definieert met prompts in natuurlijke taal. Elke ingeschakelde aangepaste Guardrail stuurt agentreacties naar een lichtgewicht model, dat deze aan je regel toetst en een beslissing om te blokkeren of toe te staan terugstuurt. Zo krijg je flexibele, domeinspecifieke controle over wat je agent wel en niet mag zeggen.
Voor elke aangepaste guardrail kun je het volgende definiëren:
| Veld | Beschrijving |
| ---------------------------------------- | ------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------ |
| **Naam** | Een beschrijvend label voor de guardrail (bijv. "Geen financieel advies"). |
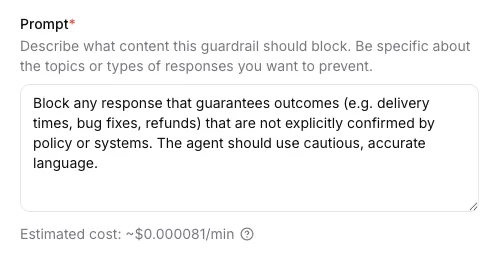
| **Prompt** | Een instructie in natuurlijke taal die beschrijft wat moet worden geblokkeerd (bijv. "Blokkeer alle content met specifiek financieel advies, beleggingsaanbevelingen of belastingadvies"). |
| **Uitvoeringsmodus** | `streaming` (standaard) of `blocking`. Zie [Uitvoeringsmodus](#execution-mode). |
| **Actie bij activering (exitstrategie)** | `end_call` (standaard) of `retry`. Zie [Exitstrategieën](#exit-strategies). |
Aangepaste Guardrails kunnen worden gebruikt om specifieke onderwerpen te blokkeren die relevant zijn voor je bedrijf, branchespecifieke compliancevereisten af te dwingen en bedrijfseigen veiligheidsmaatregelen te implementeren. Je kunt elke guardrail afzonderlijk in- of uitschakelen zonder deze te verwijderen. Wanneer er meerdere zijn ingeschakeld, worden ze parallel naast andere Guardrails uitgevoerd. Alle geactiveerde overtredingen worden gelogd voor beoordeling.
## Uitvoeringsmodus
De uitvoeringsmodus bepaalt of guardrails wachttijd toevoegen voordat de gebruiker een reactie ziet of hoort.
In de modus **streaming** kan de agentreactie beginnen voordat de guardrail wordt geactiveerd. Bij spraak kan een klein deel van de audio (vaak minder dan 500 ms) worden afgespeeld voordat een blokkering het gesprek beëindigt. Bij tekstagents kunnen gebruikers gedeeltelijke of volledige reacties zien als de beoordeling niet vóór verzending klaar is.
In de modus **Blocking** reageert de agent pas nadat de guardrails zijn gevalideerd. Dit voegt doorgaans **200–500 ms** extra latentie toe.
## Exitstrategieën
Met exitstrategieën bepaal je wat je agent doet wanneer een guardrail wordt geactiveerd. Je kunt kiezen uit:
* **`end_call`** *(standaard)*: beëindigt het gesprek onmiddellijk
* **`retry`**: genereert de reactie opnieuw met je feedback in plaats van het gesprek te beëindigen. De agentreactie wordt maximaal drie keer opnieuw geprobeerd. Als elke poging nog steeds de guardrail schendt, eindigt het gesprek.
> **Warning**
>
> Opnieuw proberen werkt alleen in de blocking-modus. In de streaming-modus is het beëindigen van het gesprek de enige beschikbare exitstrategie.
#### Feedback voor opnieuw proberen
Feedback voor **retry** kan **alle instructies** bevatten die je in de volgende beurt wilt toepassen. Deze wordt als systeemrichtlijn ingevoegd voordat het model opnieuw genereert. Dit omvat het aanroepen van systeemtools zoals `transfer_to_agent` of `transfer_to_number`. Hier zijn enkele voorbeelden van hoe je feedback voor opnieuw proberen kunt configureren:
* **Algemene weigering** (standaard) \
*Je reactie is geblokkeerd door een guardrail die content blokkeert die overeenkomt met deze voorwaarde/categorie: '\{\{trigger\_reason}}'. Tijdens je volgende beurt moet je de gebruiker vertellen: "Het spijt me, maar ik kan die vraag niet beantwoorden. Wil je iets anders weten?"*
* **Opnieuw proberen met corrigerende instructies**\
*Je vorige reactie is geblokkeerd door een guardrail. Je geblokkeerde reactie was: '\{\{agent\_message}}'. Tijdens je volgende beurt moet je een nieuw antwoord geven en dit mag niet in strijd zijn met: '\{\{trigger\_reason}}'*
* **Overdragen aan een andere agent**\
*Je vorige reactie is geblokkeerd door de guardrail. Tijdens je volgende beurt moet je de tool transfer\_to\_agent gebruiken en overdragen aan een agent. Je geblokkeerde reactie was: '\{\{agent\_message}}'. De guardrail blokkeert content die overeenkomt met deze voorwaarde/categorie: '\{\{trigger\_reason}}'.*
* **Overdragen aan een persoon**\
*Je reactie is geblokkeerd door een guardrail die content blokkeert die overeenkomt met deze voorwaarde/categorie: '\{\{trigger\_reason}}'. Tijdens je volgende beurt MOET je het gesprek overdragen aan een menselijke medewerker met de tool transfer\_to\_number.*
> **Tip**
>
> Schakel de bijbehorende tools in en configureer ze in de instellingen van de agent om **systeemtools** te gebruiken in feedback voor opnieuw proberen. Alleen tools die voor de agent zijn ingesteld, kunnen worden aangeroepen.
Je kunt deze placeholders in de feedbacktekst gebruiken:
| Placeholder | Vervangen door |
| -------------------- | ----------------------------------------------------------------------------------------------------------------------------------------------------------------------------- |
| `{{trigger_reason}}` | De **prompt** van de guardrail wanneer deze is gedefinieerd in aangepaste guardrails. De **categorie** die is geactiveerd wanneer deze is gedefinieerd in content guardrails. |
| `{{agent_message}}` | De geblokkeerde uitvoer van de agent (nuttig om het opnieuw proberen te sturen). |
> **Tip**
>
> De uitvoeringsmodus **streaming** wordt aanbevolen voor **spraak**agents; de uitvoeringsmodus **blocking** wordt aanbevolen voor **tekst**agents.
> **Warning**
>
> **Blocking** (vooral met **retry**) kan zich bij spraak minder voorspelbaar gedragen. Als je blocking bij spraak gebruikt, test dan grondig of kies **end call** in plaats van **retry** totdat je vertrouwen hebt in het gedrag.
## Prijzen
De guardrails **Focus**, **Manipulation** en **Content** zijn **zonder extra kosten** inbegrepen voor alle gebruikers van ElevenAgents.
**Custom Guardrails** zijn op gebruik gebaseerd en **brengen extra LLM-kosten met zich mee**, vergelijkbaar met andere modelaanroepen in ElevenAgents. Elke ingeschakelde Custom Guardrail stuurt elke agentreactie naar een lichtgewicht model voor beoordeling. De kosten zijn dus afhankelijk van de lengte van de prompt, de gemiddelde gespreksduur en het aantal gesprekken. Als je meerdere Custom Guardrails inschakelt, voert elke guardrail per reactie een eigen beoordeling uit. We raden aan je verwachte verkeer en modelkeuze te bekijken voordat je meerdere Custom Guardrails in productie inschakelt.
Bij het maken of bewerken van een aangepaste guardrail zie je onder de prompt een geschatte kostprijs.
> **Note**
>
> **Opnieuw proberen en kosten:** Elke poging is een extra agentgeneratie plus nog een guardrailbeoordeling. Daarom verhoogt **retry** de facturering op basis van gebruik vergeleken met **end\_call** (maximaal drie pogingen per geblokkeerde beurt).
## Configuratie
#### Configureren via het dashboard
#### Ga naar de agentinstellingen
Open je agent in het ElevenLabs-dashboard en ga naar het tabblad **Beveiliging**.
#### Schakel guardrails in
Schakel de guardrailcategorieën in die je wilt gebruiken. Je kunt de vooraf ingestelde knoppen gebruiken om snel
alle categorieën in of uit te schakelen.
#### Configureer de uitvoeringsmodus en exitstrategie (aangepaste guardrails en contentguardrails)
Kies voor elke aangepaste guardrail of contentguardrail de uitvoeringsmodus **streaming** of **blocking**.
**Blocking** is geschikt voor **tekst**agents; **streaming** is geschikt voor **spraak**agents. Stel **Actie bij
guardrailovertreding** in (komt overeen met **`trigger_action`**): **gesprek beëindigen** in elke modus, of **opnieuw proberen**
alleen wanneer **blocking** is geselecteerd (**opnieuw proberen** is niet beschikbaar in **streaming**). Als je **opnieuw proberen** kiest,
bewerk je **Feedback die bij opnieuw proberen wordt ingevoegd** om het model te sturen. Gebruik de placeholders