

ボイスチェンジャー
ボイスチェンジャー
感情や話し方を保ちながら、声を変換する方法を解説します。
概要
ボイスチェンジャー(旧スピーチtoスピーチ)では、元の声のトーンや話し方を維持したまま、一つの声(元の声)を別の声(クローンされた声)に変換できます。
ボイスチェンジャーは、発音エラーを修正したり、表現したかった特別なパフォーマンスを加えたりすることで、テキスト読み上げ(TTS)を補完できます。ボイスチェンジャーは、より感情豊かで人間らしい印象を与える、声の微妙で個性的な特徴を再現する際に特に役立ちます。主な機能は次のとおりです。
- ささやき声をより高精度に再現
- 聞き取れるため息、笑い声、泣き声を作成可能
- トーンと感情の検出を大幅に改善
- 入力された話し方のリズムを正確に維持
- 言語/アクセントの維持
ボイスチェンジャーの動作を見る
ガイド
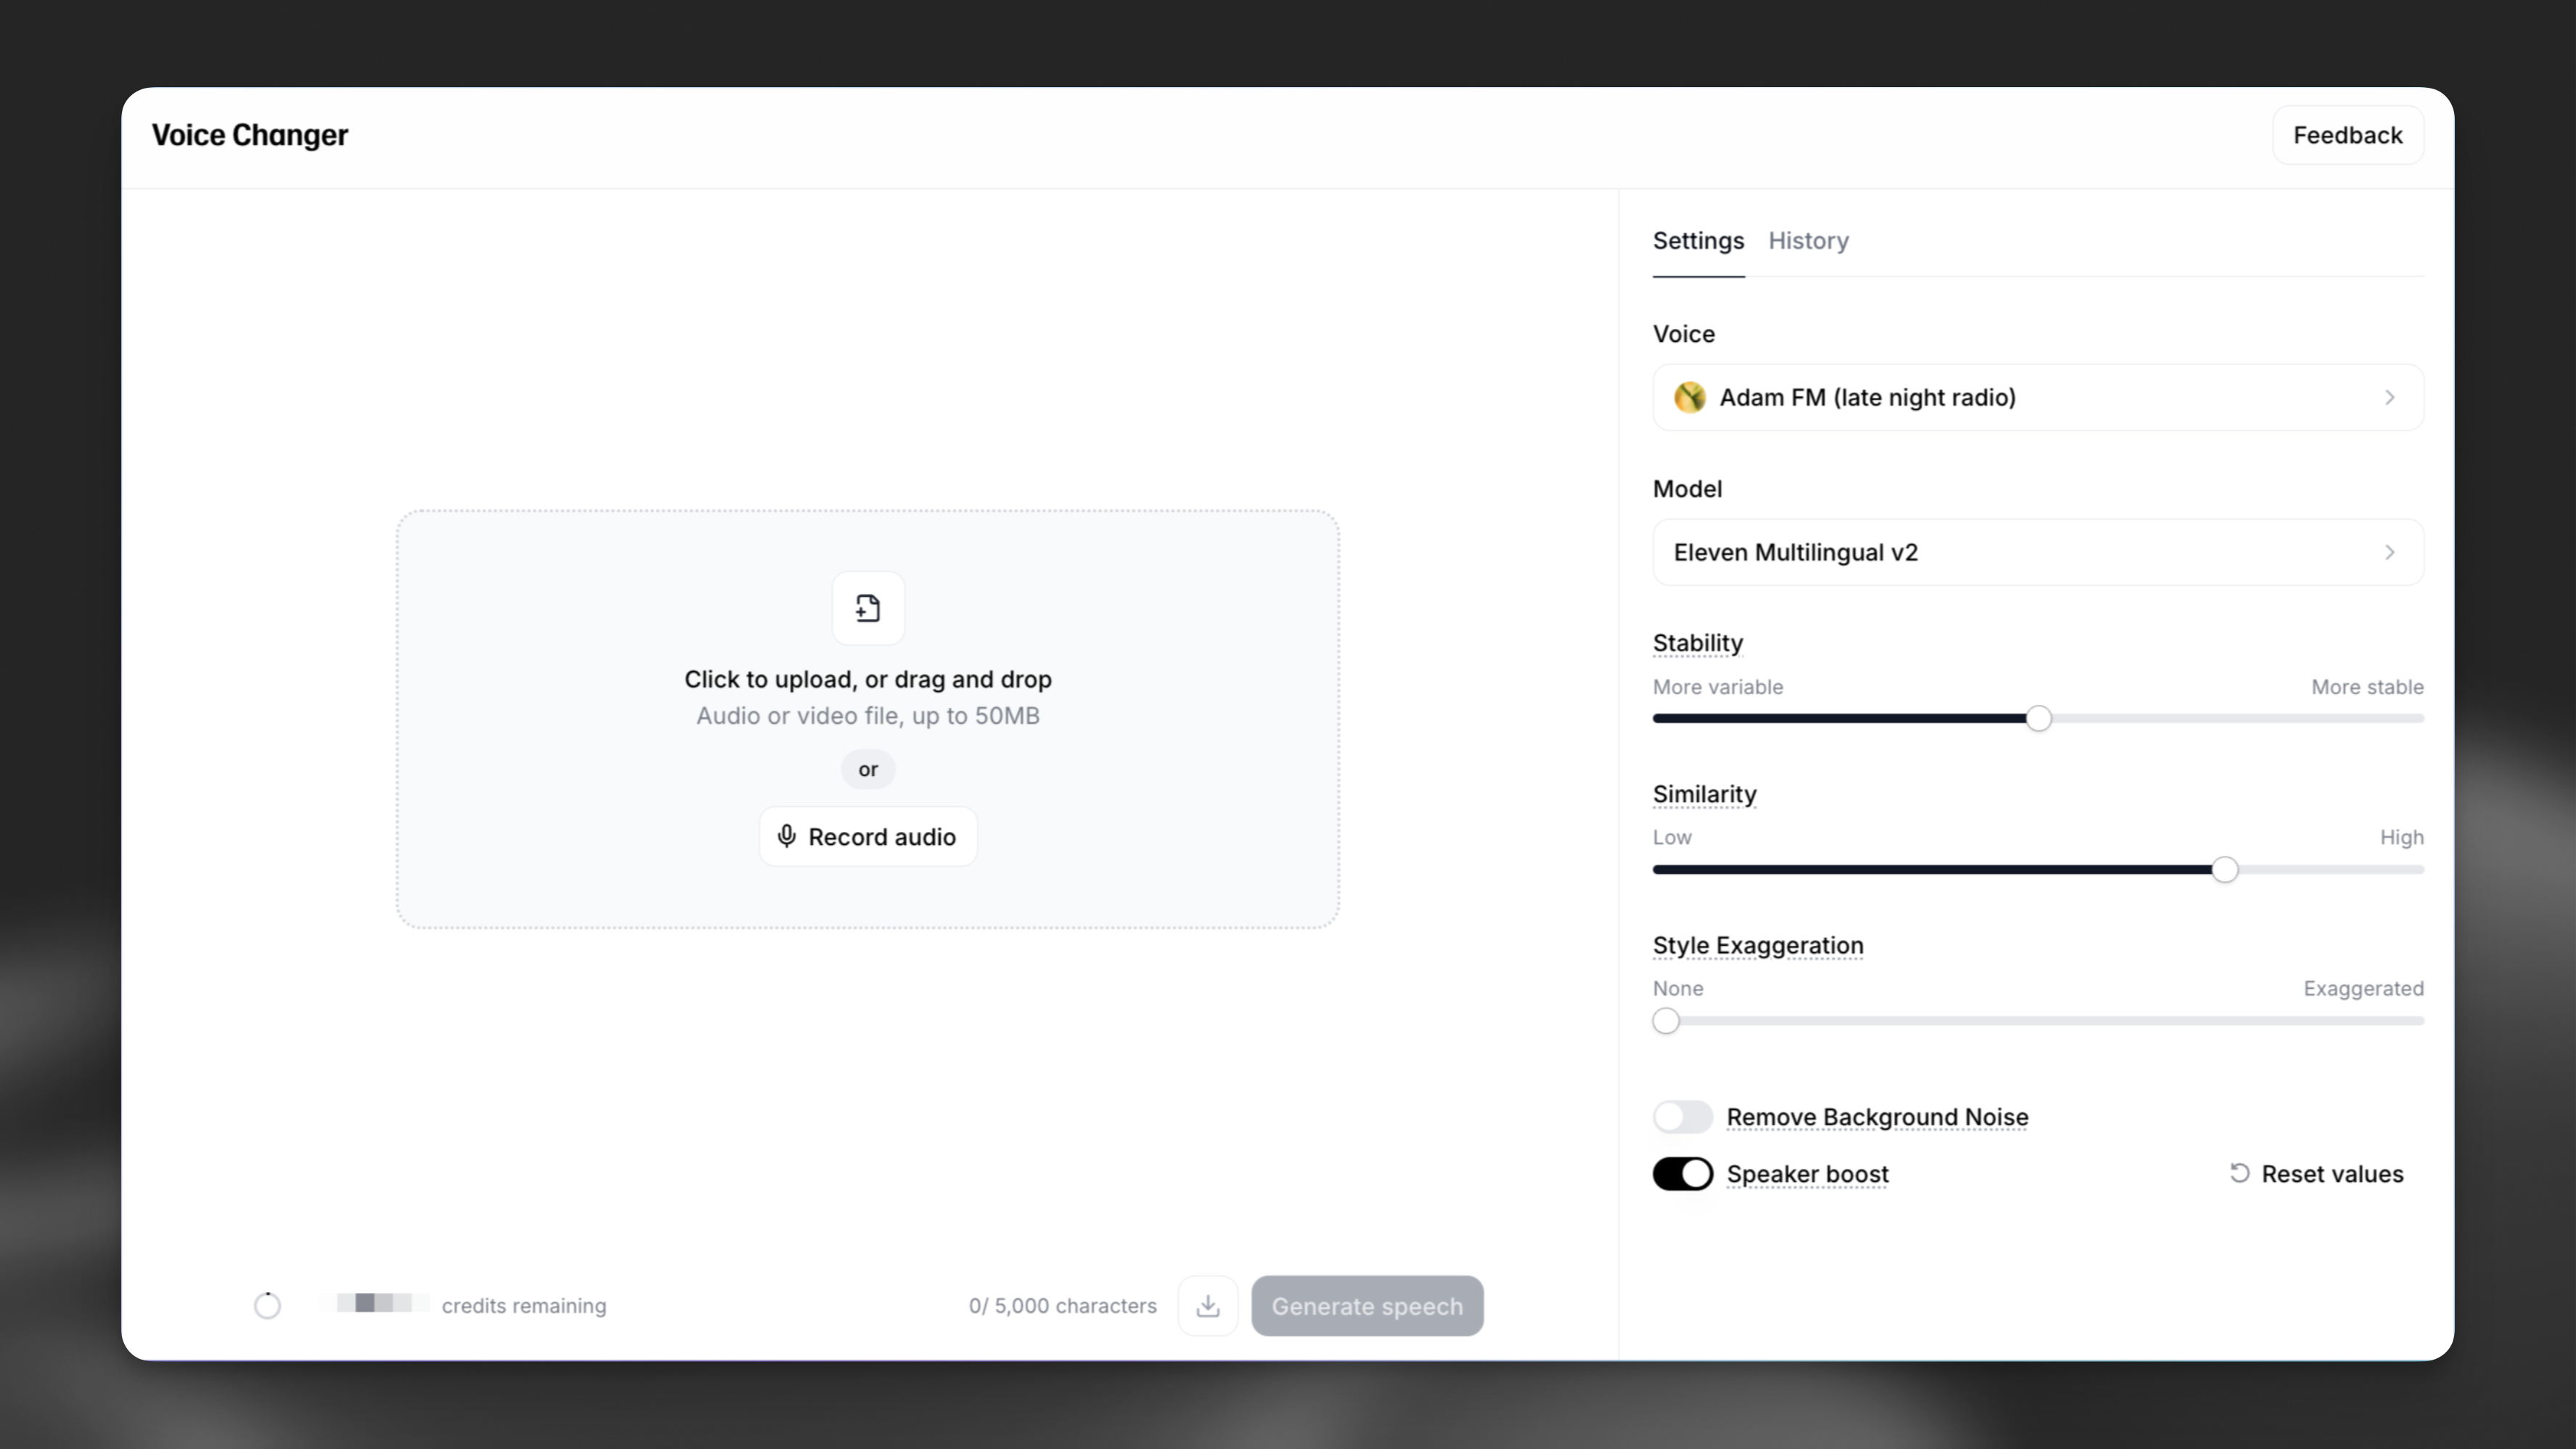
オーディオは、オーディオファイルを直接アップロードするか、マイクを通じてライブで録音できます。オーディオファイルのサイズは50MB未満である必要があり、オーディオファイルまたはライブ録音の長さは5分以内である必要があります。
5分を超える素材がある場合は、小さなセクションに分割して個別に生成することをおすすめします。また、ファイルサイズが大きすぎる場合は、mp3に圧縮または変換する必要があることがあります。
既存のオーディオファイル
既存のオーディオファイルをアップロードするには、オーディオボックスをクリックするか、オーディオファイルを直接ドラッグ&ドロップします。
ライブ録音
オーディオボックスのRecord Audioボタンを押し、録音の準備ができたらMicrophoneボタンを押して開始します。録音が終わったら、Stopボタンを押します。
録音したオーディオファイルが表示され、再生して確認できます。パフォーマンスや録音に満足しているかを判断するのに役立ちます。文字数コストは左下隅に表示され、録音そのものにクォータは消費されません。クォータが消費されるのは「Generate」を押したときだけです。
ボイスチェンジャー生成の料金は、1分あたり1000文字で、長さのみに基づいて計算されます。
設定
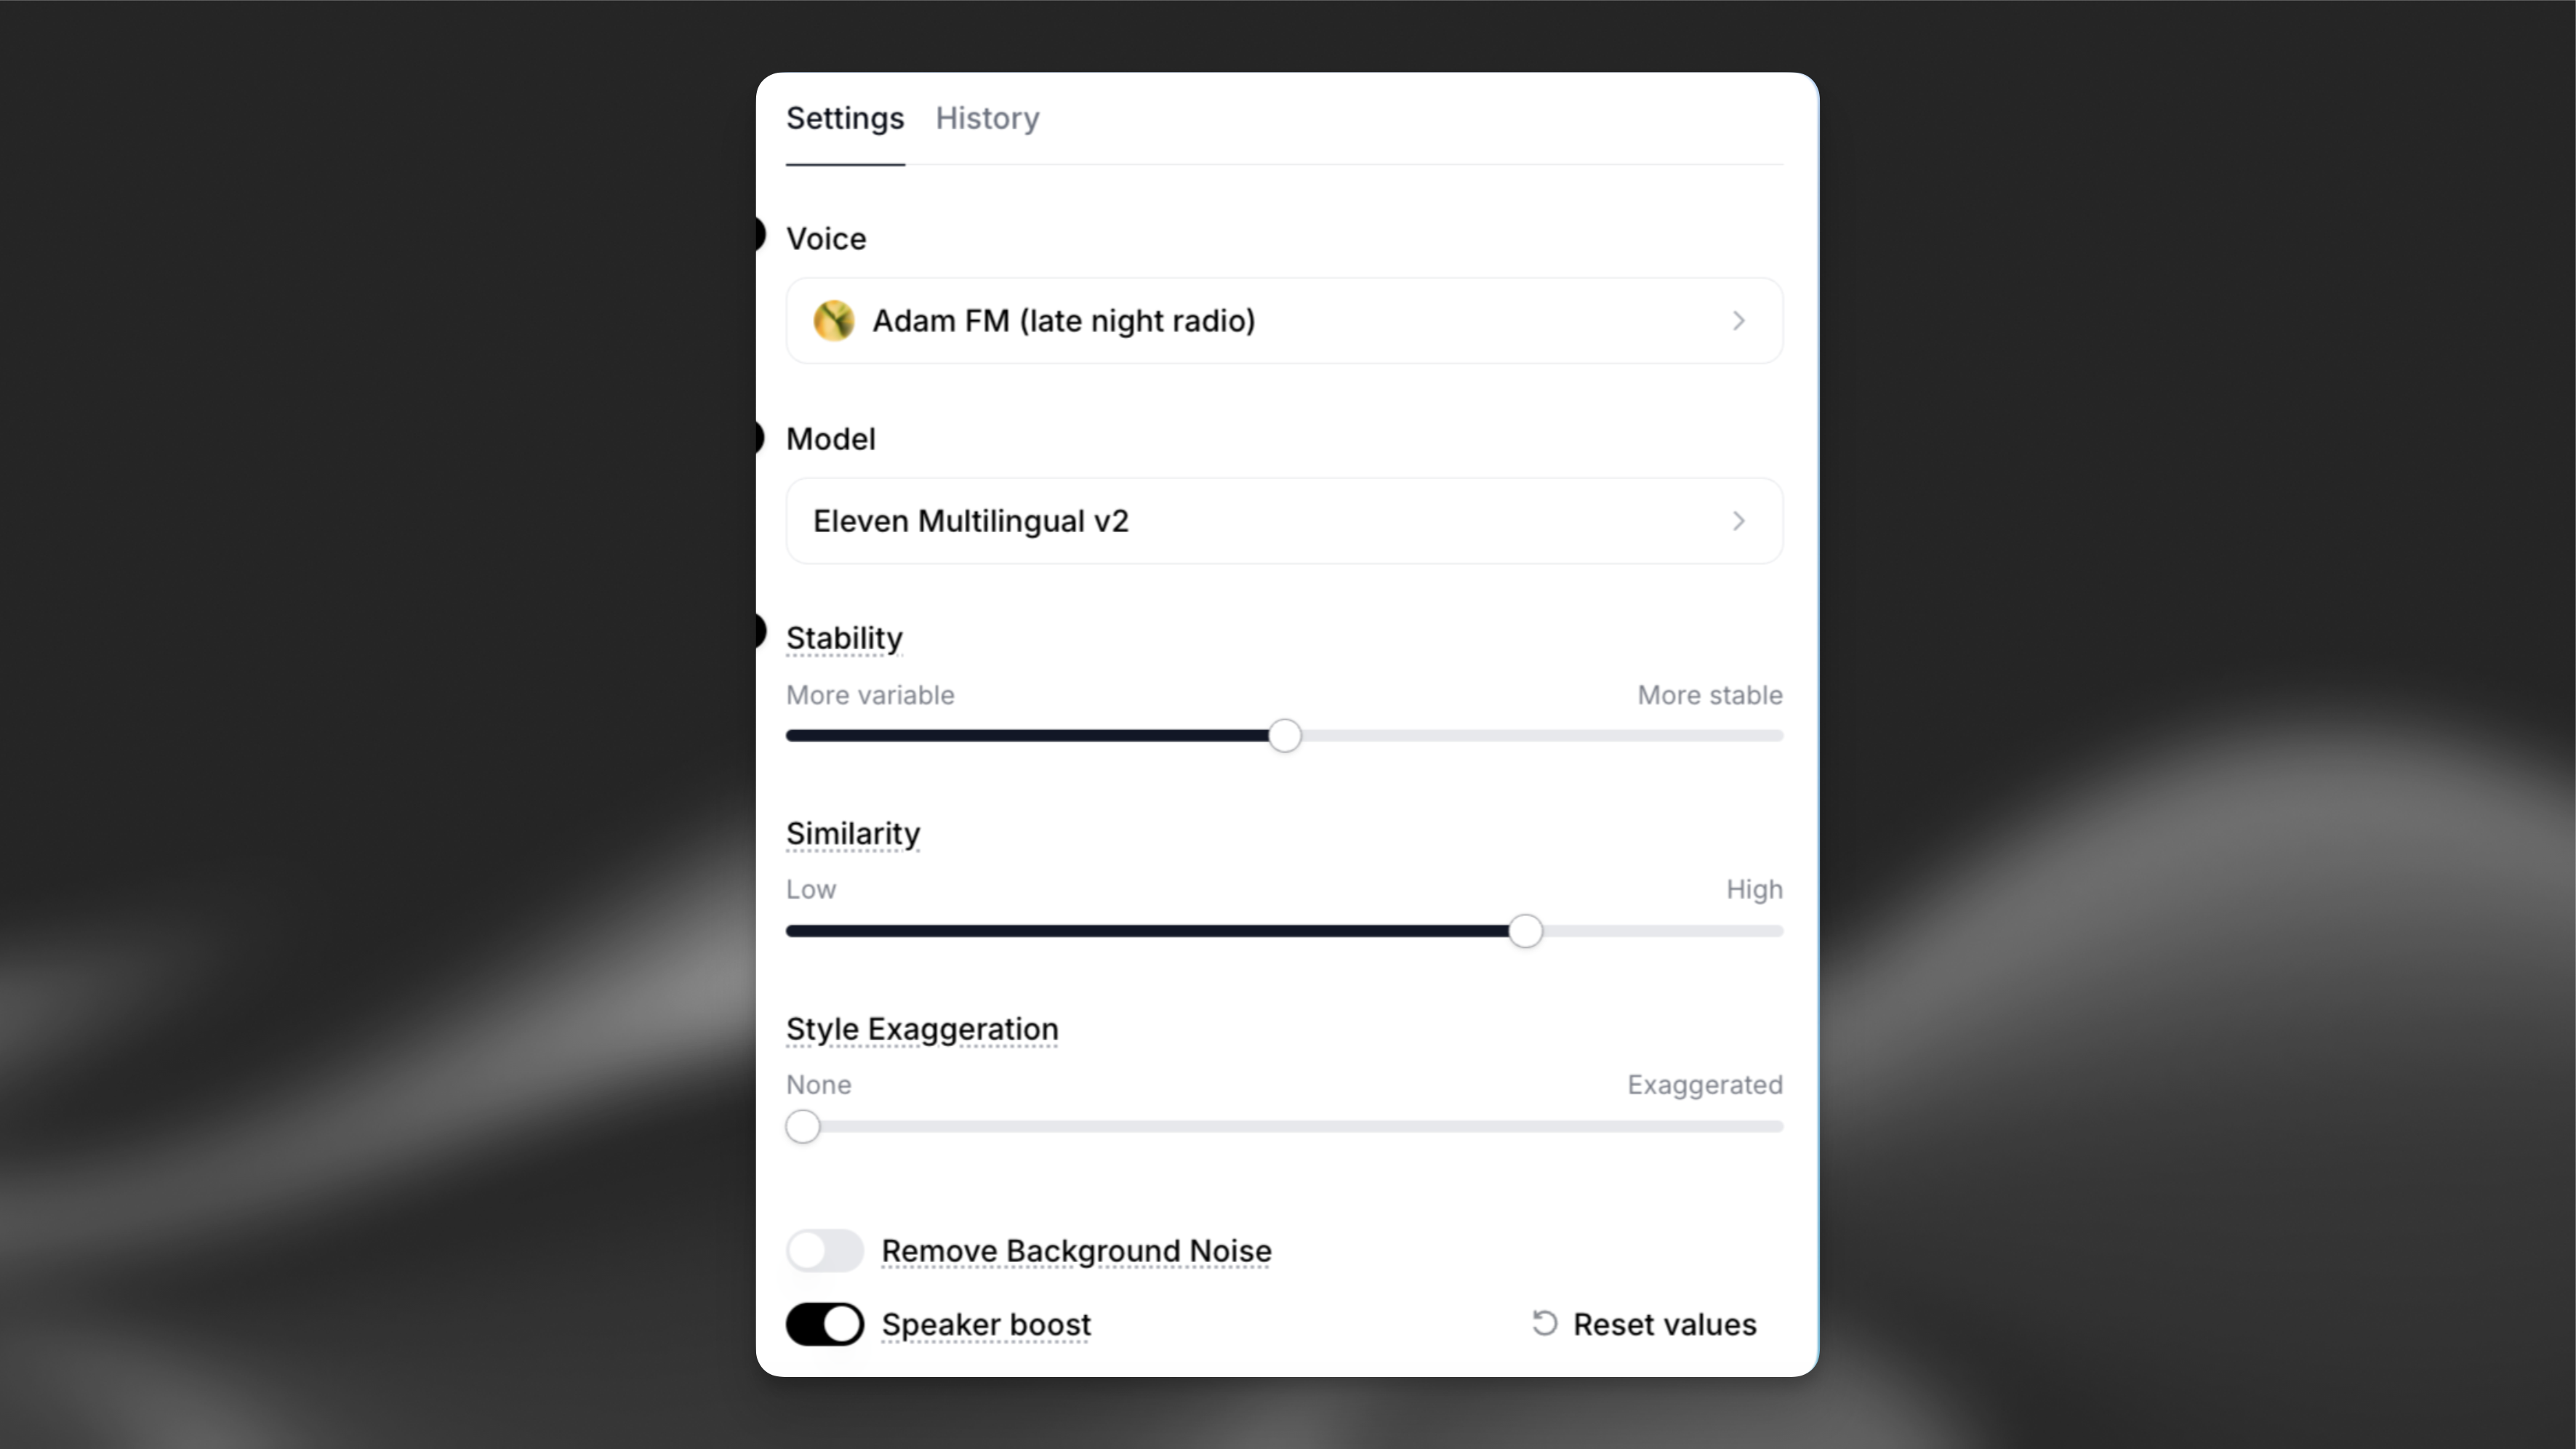
さまざまな音声設定については、こちらをご覧ください。
ボイスチェンジャーには、録音からバックグラウンドノイズを自動的に除去する追加設定があります。
対応言語
eleven_english_sts_v2
Multilingual v2モデルは、29言語に対応しています。
英語(米国、英国、オーストラリア、カナダ)、日本語、中国語、ドイツ語、ヒンディー語、フランス語(フランス、カナダ)、韓国語、ポルトガル語(ブラジル、ポルトガル)、イタリア語、スペイン語(スペイン、メキシコ)、インドネシア語、オランダ語、トルコ語、フィリピン語、ポーランド語、スウェーデン語、ブルガリア語、ルーマニア語、アラビア語(サウジアラビア、アラブ首長国連邦)、チェコ語、ギリシャ語、フィンランド語、クロアチア語、マレー語、スロバキア語、デンマーク語、タミル語、ウクライナ語、ロシア語。
eleven_english_sts_v2モデルは英語のみに対応しています。
ベストプラクティス
ボイスチェンジャーは、さまざまな出力音声でアクセントと自然な発話のリズムを維持することに優れています。たとえば、ポルトガル語アクセントのオーディオサンプルをアップロードすると、出力でもその言語とアクセントが維持されます。入力サンプルは出力の特性を決定するため、非常に重要です。「George」のようなイギリス英語の声を選択しても、アメリカ英語アクセントで録音した場合、結果はアメリカ英語アクセントのGeorgeの声になります。
- 表現:録音では表現豊かに話してください。叫び声、泣き声、笑い声なども、ボイスチェンジャーはパフォーマンスを正確に再現します。このツールはAIのリアリティを高め、創造的な表現を可能にするよう設計されています。
- マイクゲイン:入力ゲインが適切であることを確認してください。録音が小さすぎるとAIの認識が妨げられる可能性があり、大きすぎるとオーディオクリッピングが発生する可能性があります。
- バックグラウンドノイズ:Remove Background Noiseオプションをオンにすると、録音からバックグラウンドノイズを自動的に除去できます。