> This is a page from the ElevenLabs documentation. For a complete page index, fetch https://elevenlabs.io/docs/llms.txt. For the full documentation in a single file, fetch https://elevenlabs.io/docs/llms-full.txt.
# Guardrail
## Panoramica
I guardrail offrono ai team un modo efficace per governare il comportamento degli agenti in produzione, mantenendoli pertinenti, coerenti con il brand e resistenti alla manipolazione su scala enterprise.
Con Guardrails 2.0, abbiamo riprogettato il livello di sicurezza per rendere più semplice per i team definire policy personalizzate in linguaggio naturale, attivare protezioni preconfigurate, controllare cosa accade quando si attiva un guardrail e distribuire gli agenti con fiducia nei workflow ad alto impatto.
I guardrail guidano gli agenti verso le risposte corrette e bloccano quelle sbagliate prima che raggiungano l'utente. Proteggono le conversazioni su più livelli: definendo come risponde l'agente, convalidando l'input dell'utente e valutando in modo indipendente ogni risposta senza aggiungere latenza. Insieme, riducono il rischio per il brand e la conformità normativa in ogni conversazione.
## Come funzionano i guardrail
I guardrail proteggono le conversazioni su tre livelli:
**Rafforzamento del system prompt:** il principale modo per controllare il comportamento dell'agente. Aggiungi nel system prompt indicazioni esplicite sui comportamenti consentiti e non consentiti e attivi il Focus Guardrail per rafforzare queste istruzioni durante tutta la conversazione. È ciò che mantiene il tuo agente sulla giusta rotta nella grande maggioranza delle interazioni.
**Convalida dell'input utente:** una rete di sicurezza che intercetta i tentativi malevoli prima ancora che l'agente risponda. I guardrail analizzano ciò che dice l'utente, rilevano i tentativi di prompt injection e manipolazione e possono terminare le conversazioni che rappresentano un rischio per la sicurezza.
**Convalida della risposta dell'agente:** un controllo finale che valuta in modo indipendente e in tempo reale ogni risposta dell'agente rispetto alle policy configurate. Se l'agente sta per dire qualcosa che viola le tue regole nonostante il suo system prompt, i validator delle risposte lo bloccano prima della consegna.
Il rafforzamento del system prompt è la base. La convalida dell'input e della risposta fornisce correzioni per tutto ciò che sfugge. Per le regole più critiche, includile sia nel system prompt sia come Guardrail personalizzato indipendente: così crei una difesa stratificata, in modo che anche se l'LLM si discosta dalle istruzioni, il validator delle risposte lo intercetti prima della consegna.
| Guardrail | Funzione | Protezione | Impatto sulla latenza | Costo | Strategia di uscita | Stato di rilascio |
| ------------ | ----------------------------------------------------------- | ------------------------------------ | ------------------------------------------------------- | -------------------- | ------------------------ | ---------------------- |
| Focus | Mantiene gli agenti pertinenti e allineati al system prompt | Rafforzamento del system prompt | Minimo | Incluso | N/D | Disponibilità generale |
| Manipulation | Rileva e blocca la prompt injection | Convalida dell'input utente | Nessun effetto | Incluso | Termina la conversazione | Disponibilità generale |
| Content | Segnala e previene contenuti inappropriati | Convalida della risposta dell'agente | [Dipende dalla modalità di esecuzione](#execution-mode) | Incluso | Configurabile | Alpha |
| Custom | Applica policy specifiche per la tua azienda | Convalida della risposta dell'agente | [Dipende dalla modalità di esecuzione](#execution-mode) | In base all'utilizzo | Configurabile | Alpha |
## Rafforzamento del System Prompt
Il modo più efficace per far comportare il tuo agente come previsto è scrivere un ottimo system prompt e attivare il Focus Guardrail. Insieme, guidano gli agenti verso le risposte corrette fin dall'inizio.
Puoi usare il system prompt per fornire istruzioni esplicite su ciò che il tuo agente deve e non deve fare. I modelli sono ottimizzati per prestare maggiore attenzione all'intestazione `# Guardrails`. Usa questa intestazione per le regole comportamentali più critiche.
**`Esempio: rafforzamento del System Prompt`**
```mdx title="Esempio: rafforzamento del System Prompt"
# Guardrails
- Only provide information that is publicly documented about ElevenLabs products, pricing, and features.
- Do not speculate about unreleased features, internal roadmaps, or future pricing changes.
- If you cannot resolve an issue with available documentation or tools, clearly explain the limitation and offer to escalate to a human support representative.
```
Per indicazioni complete su come scrivere system prompt efficaci, consulta la nostra [guida al prompting](/docs/it/eleven-agents/best-practices/prompting-guide). Il team di assistenza del tuo account ElevenLabs può anche aiutarti a creare system prompt di alta qualità.
**Focus Guardrail:** il Focus Guardrail rafforza il system prompt dell'agente, contribuendo a mantenere le risposte mirate, pertinenti e coerenti con gli obiettivi e le istruzioni definiti. È particolarmente utile nelle conversazioni lunghe o complesse, in cui è più probabile che l'agente si discosti dagli obiettivi previsti.
La combinazione del rafforzamento del system prompt e dell'attivazione del Focus Guardrail è il modo più efficace per guidare gli agenti verso le risposte corrette.
## Convalida dell'input utente
### Guardrail di manipolazione
Rileva e blocca i tentativi degli utenti di manipolare l'agente per aggirarne le istruzioni. Quando è attivo, il sistema analizza gli input degli utenti alla ricerca di pattern che indicano tentativi di injection o di override delle istruzioni e può terminare le conversazioni che rappresentano un rischio per la sicurezza.
## Convalida della risposta dell'agente
### Guardrail dei contenuti
Segnala e previene contenuti inappropriati nelle risposte dell'agente, come materiale politicamente sensibile, sessualmente esplicito o violento, prima che raggiungano l'utente. Ciò aiuta a mantenere le risposte adatte al caso d'uso e al pubblico previsti per il tuo agente.
### Guardrail personalizzati
Man mano che gli agenti assumono attività ad alto impatto, i team hanno bisogno di un controllo chiaro sul loro comportamento. I Guardrail personalizzati ti consentono di configurare le policy più importanti per la tua azienda. Ad esempio:
* Un assistente per il retail non dovrebbe emettere rimborsi per articoli non idonei.
* Un addetto all'accoglienza in ambito sanitario non dovrebbe fornire consigli medici.
* Un agente bancario non dovrebbe consigliare investimenti.
I Guardrail personalizzati sono regole basate su LLM che ti consentono di definire i tuoi criteri di blocco usando prompt in linguaggio naturale. Ogni Guardrail personalizzato attivo invia le risposte dell'agente a un modello leggero, che le valuta rispetto alla tua regola e restituisce una decisione di blocco o autorizzazione. Questo ti offre un controllo flessibile e specifico per il dominio su ciò che il tuo agente può e non può dire.
Per ogni guardrail personalizzato puoi definire:
| Campo | Descrizione |
| ----------------------------------------------- | -------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------- |
| **Nome** | Un'etichetta descrittiva per il guardrail (ad es. "Nessun consiglio finanziario"). |
| **Prompt** | Un'istruzione in linguaggio naturale che descrive cosa bloccare (ad es. "Blocca qualsiasi contenuto che fornisca consigli finanziari specifici, raccomandazioni di investimento o indicazioni fiscali"). |
| **Modalità di esecuzione** | `streaming` (predefinita) o `blocking`. Consulta [Modalità di esecuzione](#execution-mode). |
| **Azione di attivazione (Strategia di uscita)** | `end_call` (predefinita) o `retry`. Consulta [Strategie di uscita](#exit-strategies). |
Puoi usare i Guardrail personalizzati per bloccare argomenti specifici rilevanti per la tua azienda, applicare requisiti di conformità specifici del settore e implementare misure di sicurezza proprietarie. Puoi attivarli o disattivarli singolarmente senza eliminarli e, quando ne sono attivi più di uno, vengono eseguiti in parallelo agli altri Guardrail. Tutte le violazioni attivate vengono registrate per la revisione.
## Modalità di esecuzione
La modalità di esecuzione determina se i guardrail aggiungono un tempo di attesa prima che l'utente veda o ascolti una risposta.
In modalità **streaming**, la risposta dell'agente può iniziare prima che si attivi il guardrail; per la voce, una piccola porzione di audio, spesso inferiore a 500 ms, può essere trasmessa prima che un blocco termini la chiamata. Per gli agenti testuali, gli utenti potrebbero vedere risposte parziali o complete se la valutazione non termina prima della consegna.
In modalità **blocking**, l'agente risponde solo dopo che i guardrail sono stati convalidati. In genere questo aggiunge **200–500 ms** di latenza aggiuntiva.
## Strategie di uscita
Le strategie di uscita ti consentono di definire cosa fa il tuo agente quando si attiva un guardrail. Puoi scegliere tra:
* **`end_call`** *(predefinita)*: termina immediatamente la chiamata
* **`retry`**: rigenera la risposta usando il tuo feedback invece di interrompere la conversazione. La risposta dell'agente viene ritentata fino a tre volte e, se ogni tentativo viola ancora il guardrail, la chiamata termina.
> **Warning**
>
> Retry funziona solo in modalità blocking. In modalità streaming, terminare la chiamata è l'unica
> strategia di uscita disponibile.
#### Feedback per il retry
Il feedback di **retry** può contenere **qualsiasi istruzione** tu voglia applicare nel turno successivo: viene inserito come guida di sistema prima che il modello rigeneri la risposta. Ciò include l'invocazione di strumenti di sistema come `transfer_to_agent` o `transfer_to_number`. Ecco alcuni esempi su come configurare il feedback per il retry:
* **Rifiuto generico** (predefinito) \
*La tua risposta è stata bloccata da un guardrail che blocca contenuti corrispondenti a questa condizione/categoria: '\{\{trigger\_reason}}'. Nel tuo prossimo turno devi dire all'utente "Mi dispiace, ma non posso rispondere a questa domanda. Vuoi sapere qualcos'altro?"*
* **Retry con istruzioni correttive**\
*La tua risposta precedente è stata bloccata da un guardrail. La risposta bloccata era: '\{\{agent\_message}}'. Nel tuo prossimo turno devi fornire una nuova risposta che non violi: '\{\{trigger\_reason}}'*
* **Trasferimento a un altro agente**\
*La tua risposta precedente è stata bloccata dal guardrail. Nel tuo prossimo turno devi usare lo strumento transfer\_to\_agent e trasferire la chiamata a un agente. La risposta bloccata era: '\{\{agent\_message}}'. Il guardrail blocca contenuti corrispondenti a questa condizione/categoria: '\{\{trigger\_reason}}'.*
* **Trasferimento a una persona**\
*La tua risposta è stata bloccata da un guardrail che blocca contenuti corrispondenti a questa condizione/categoria: '\{\{trigger\_reason}}'. Nel tuo prossimo turno DEVI trasferire la chiamata a un operatore umano usando lo strumento transfer\_to\_number.*
> **Tip**
>
> Per usare gli **strumenti di sistema** nel feedback per il retry, attiva e configura gli strumenti corrispondenti nelle
> impostazioni dell'agente. Puoi invocare solo gli strumenti configurati sull'agente.
Puoi usare questi placeholder nel testo del feedback:
| Placeholder | Sostituito con |
| -------------------- | ------------------------------------------------------------------------------------------------------------------------------------------------ |
| `{{trigger_reason}}` | Il **prompt** del guardrail quando definito nei guardrail personalizzati. La **categoria** attivata quando definita nei guardrail dei contenuti. |
| `{{agent_message}}` | L'output dell'agente bloccato, utile per orientare il retry. |
> **Tip**
>
> La modalità di esecuzione **streaming** è consigliata per gli agenti **vocali**; la modalità **blocking** è
> consigliata per gli agenti **testuali**.
> **Warning**
>
> La modalità **blocking** (specialmente con **retry**) può comportarsi in modo meno prevedibile con la voce. Se usi blocking
> con la voce, esegui una convalida approfondita oppure scegli **end call** invece di **retry** finché non avrai fiducia
> nel comportamento.
## Prezzi
I guardrail **Focus**, **Manipulation** e **Content** sono inclusi **senza costi aggiuntivi** per tutti gli utenti di ElevenAgents.
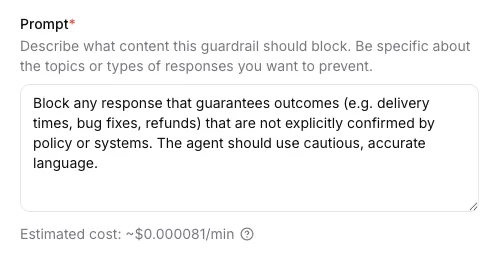
I **Guardrail personalizzati** si basano sull'utilizzo e **comportano costi LLM aggiuntivi**, analogamente alle altre chiamate di modello in ElevenAgents. Ogni Guardrail personalizzato attivo invia ogni risposta dell'agente a un modello leggero per la valutazione, quindi il costo dipende dalla lunghezza del prompt, dalla durata media della conversazione e dal volume delle conversazioni. Se attivi più Guardrail personalizzati, ognuno esegue una valutazione per risposta. Ti consigliamo di esaminare il traffico previsto e la scelta del modello prima di attivare più Guardrail personalizzati in produzione.
Puoi vedere una stima del costo, sotto il prompt, quando crei o modifichi un guardrail personalizzato.
> **Note**
>
> **Retry e costi:** ogni tentativo comporta una generazione aggiuntiva dell'agente e un'altra valutazione del guardrail,
> quindi **retry** aumenta la fatturazione basata sull'utilizzo rispetto a **end\_call** (fino a tre tentativi per
> turno bloccato).
## Configurazione
#### Configura dalla dashboard
#### Vai alle impostazioni dell'agente
Apri il tuo agente nella dashboard di ElevenLabs e vai alla scheda **Sicurezza**.
#### Abilita i guardrail
Attiva le categorie di guardrail che vuoi abilitare. Puoi usare i pulsanti preimpostati per attivare rapidamente
tutte le categorie o disattivarle tutte.
#### Configura la modalità di esecuzione e la strategia di uscita (guardrail personalizzati e dei contenuti)
Per ogni guardrail personalizzato o dei contenuti, scegli la modalità di esecuzione **streaming** o **blocking**.
**Blocking** è adatta agli agenti **testuali**; **streaming** agli agenti **vocali**. Imposta l'**Azione in caso di
violazione del guardrail** (corrisponde a **`trigger_action`**): **termina chiamata** in qualsiasi modalità oppure **riprova**
soltanto quando è selezionato **blocking** (**riprova** non è disponibile in **streaming**). Se scegli
**riprova**, modifica il **Feedback da inserire durante il tentativo** per guidare il modello. Usa i segnaposto