Image & Vidéo
Image & Vidéo
Guide complet pour créer et modifier des images et des vidéos dans ElevenLabs.
Présentation
Image & Vidéo vous permet de créer du contenu visuel de haute qualité à partir de simples descriptions textuelles ou d’images de référence. Générez des images statiques ou des vidéos dynamiques dans tous les styles, puis affinez-les de manière itérative avec des prompts supplémentaires, augmentez leur résolution pour un rendu haute définition et ajoutez même une synchronisation labiale avec l’audio. Exportez les éléments finalisés sous forme de fichiers indépendants ou importez-les directement dans des projets ElevenCreative Studio.
Certains modèles Image & Vidéo et fonctionnalités d’importation sont limités aux États-Unis en raison d’exigences réglementaires ou imposées par les fournisseurs. Consultez les descriptions de chaque modèle pour connaître leur disponibilité.
Les utilisateurs du forfait Gratuit peuvent uniquement générer des images et sont limités à trois demandes d’images par jour. La génération de vidéos nécessite un forfait payant.
Guide
Suivez ces étapes pour créer votre premier élément visuel :
Sélectionnez votre mode
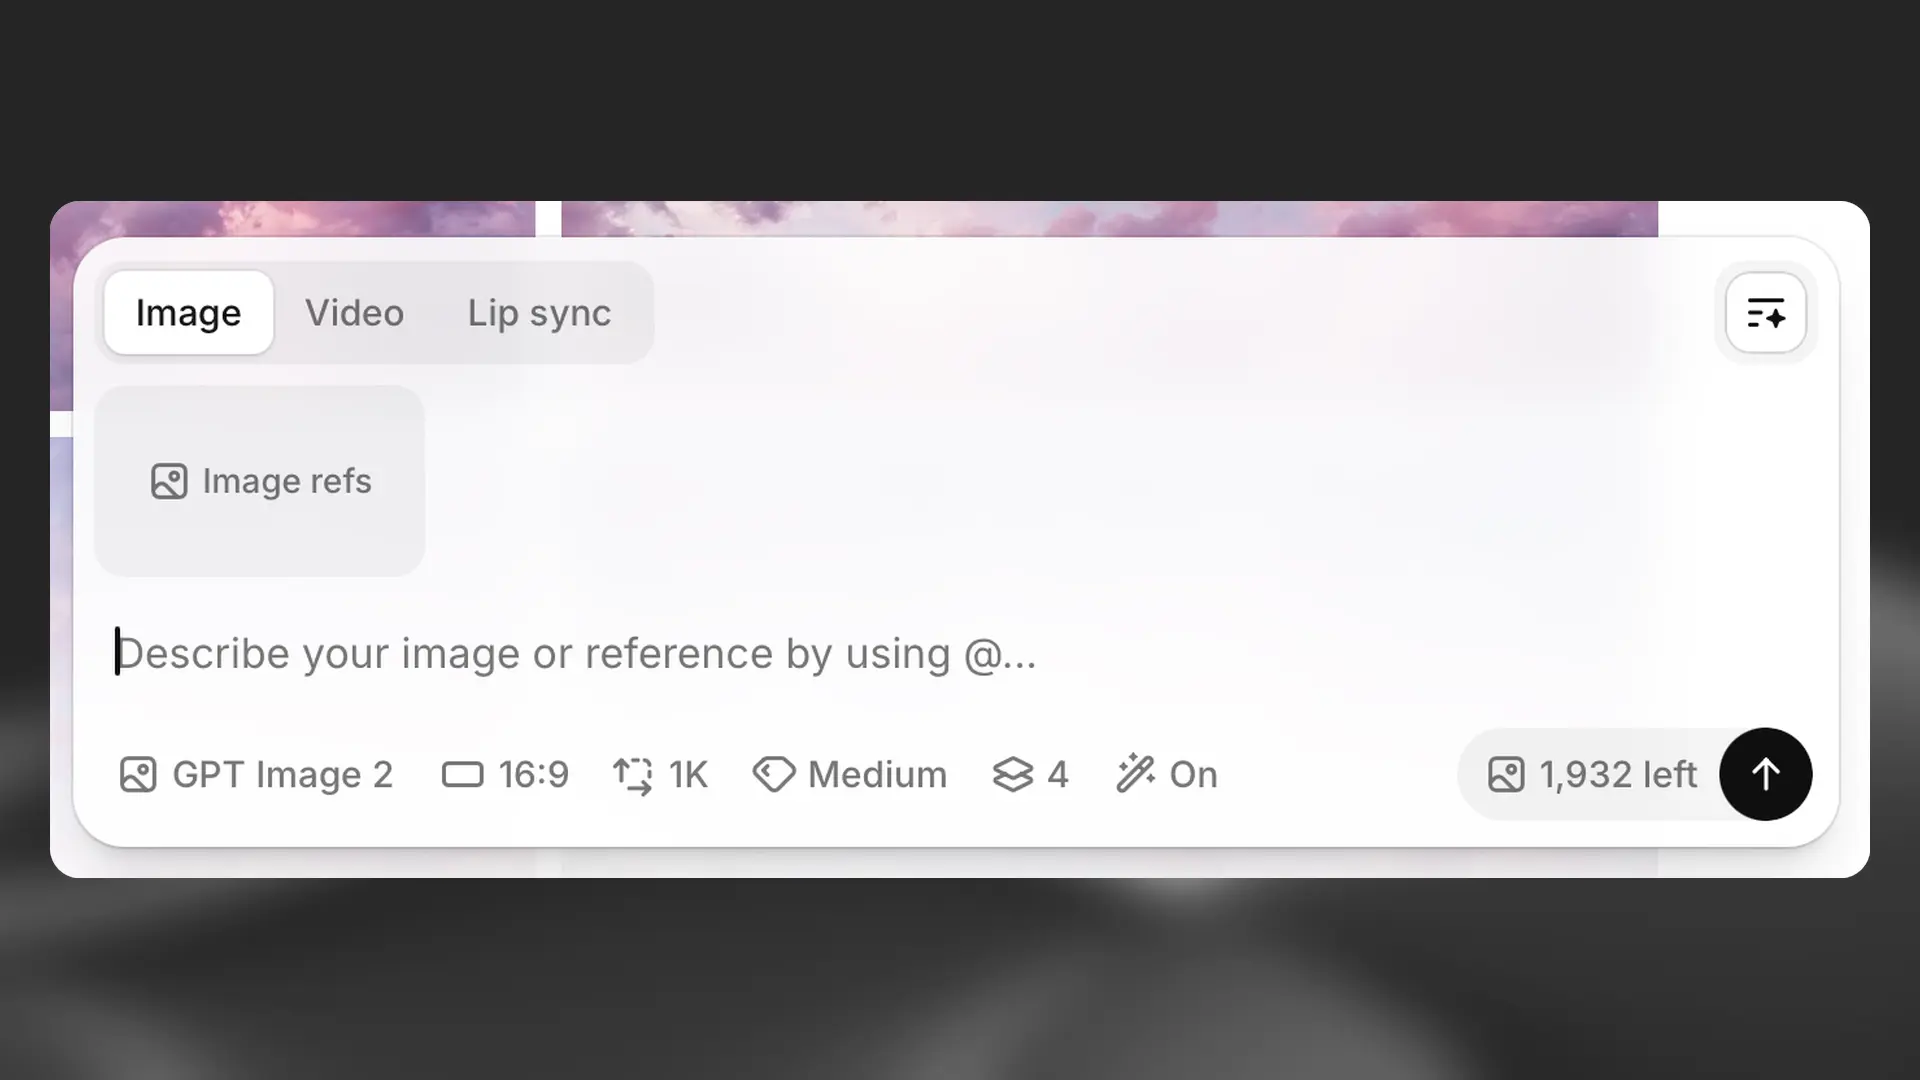
Utilisez le bouton bascule dans l’angle supérieur droit de la zone de prompt pour choisir la génération d’images ou de vidéos.
Saisissez un prompt ou ajoutez une référence
Décrivez le résultat souhaité en langage naturel dans la zone de prompt. Pour davantage de contrôle, faites glisser des images ou vidéos existantes depuis les onglets Explorer ou Historique vers les emplacements de référence, ou importez vos propres images de référence dans de nombreux formats, notamment JPG, PNG, WEBP et plus encore.
Choisissez un modèle et des paramètres
Sélectionnez le modèle génératif adapté à votre objectif, par exemple Google Veo 3.1, Kling 2.5 ou Flux 1 Kontext Pro. Consultez la section Modèles pour obtenir des informations détaillées sur chaque modèle. Ajustez les paramètres tels que le format d’image, la résolution, la durée pour les vidéos et le nombre de variations à générer.
Générez votre élément
Cliquez sur le bouton Générer. Vos éléments seront créés et affichés dans l’onglet Historique pour examen.
Améliorez et affinez
Utilisez les outils d’amélioration pour perfectionner vos médias. Augmentez la résolution, appliquez une synchronisation labiale réaliste avec de l’audio, ou cliquez sur Recréer pour générer une nouvelle variation avec les mêmes paramètres.
Workflow
Le processus de création vous fait passer de l’inspiration à l’élément finalisé en quatre étapes :
Explorer
Découvrez les créations de la communauté pour trouver l’inspiration, étudier des prompts efficaces ou intégrer directement des références à votre travail.
Générer
Utilisez la zone de prompt pour décrire ce que vous souhaitez créer, sélectionnez un modèle, affinez vos paramètres et donnez vie à votre idée.
Historique
Examinez vos générations dans l’onglet Historique pour les itérer et les améliorer. Recréez des variations, réutilisez des prompts et appliquez des améliorations comme l’augmentation de résolution et la synchronisation labiale.
Exporter
Téléchargez les éléments finalisés dans différents formats ou envoyez-les directement à ElevenCreative Studio pour les utiliser dans vos projets.
Explorer
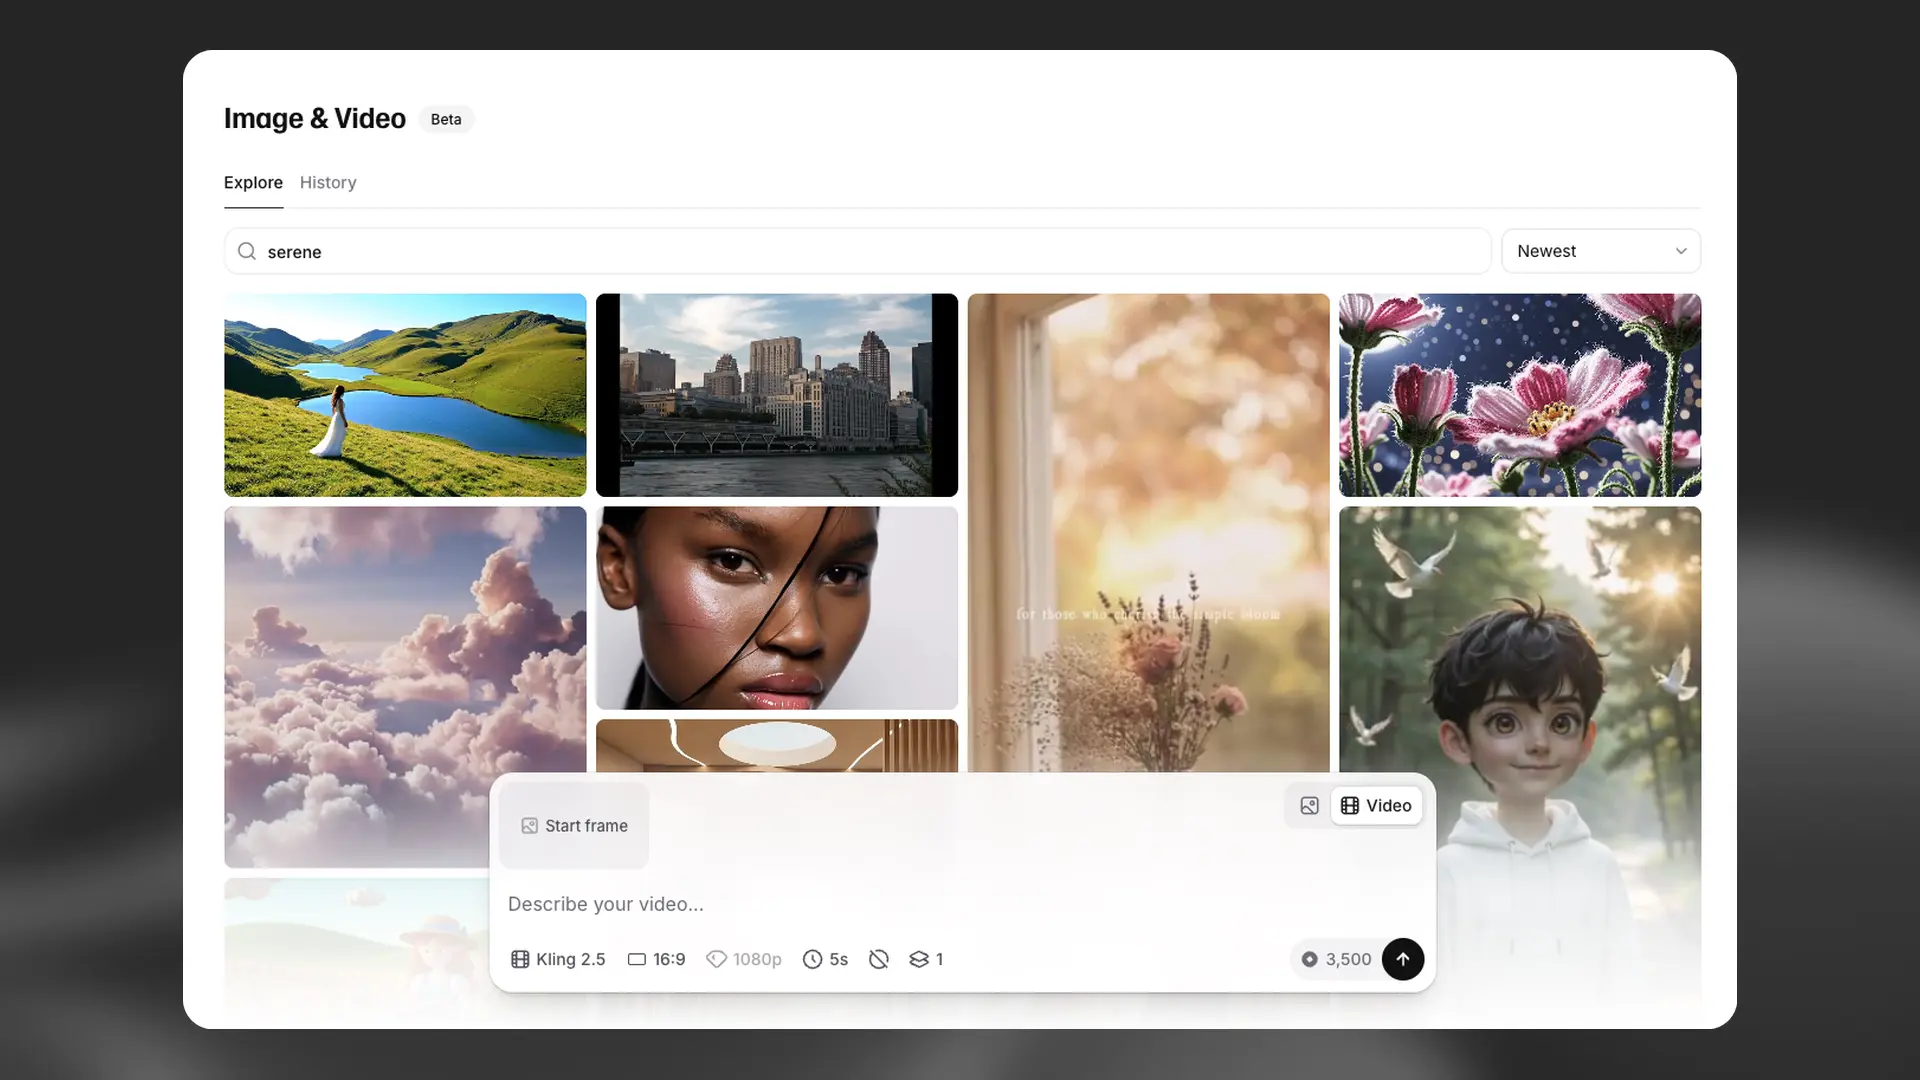
L’onglet Explorer affiche une galerie de créations de la communauté pour trouver l’inspiration et repérer des visuels à utiliser comme références.
Rechercher : Utilisez la barre de recherche pour trouver des images et des vidéos à partir de mots-clés.
Trier : Basculez entre Tendances et Plus récent pour afficher les contenus populaires ou récemment ajoutés.
Glisser-déposer : Faites glisser n’importe quel résultat de la grille directement dans la zone de prompt pour l’utiliser comme image de début, image de fin ou référence de style.
Aperçu des détails : Cliquez sur une vignette pour voir le prompt complet et les paramètres utilisés pour la créer.
Générer
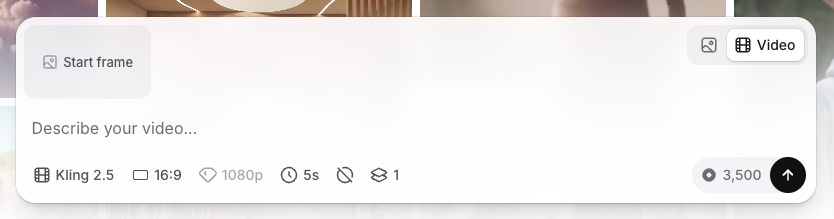
La zone de prompt est ancrée en bas de la page et fournit tous les contrôles nécessaires à la création de contenu visuel.
Définissez le mode et le prompt
Sélectionnez le mode : Utilisez le bouton bascule dans l’angle supérieur droit pour passer de la génération d’images à celle de vidéos.
Rédigez votre prompt : Dans le champ principal, décrivez en langage naturel ce que vous souhaitez générer. Soyez clair et descriptif pour obtenir les meilleurs résultats.
Choisissez les modèles et les paramètres
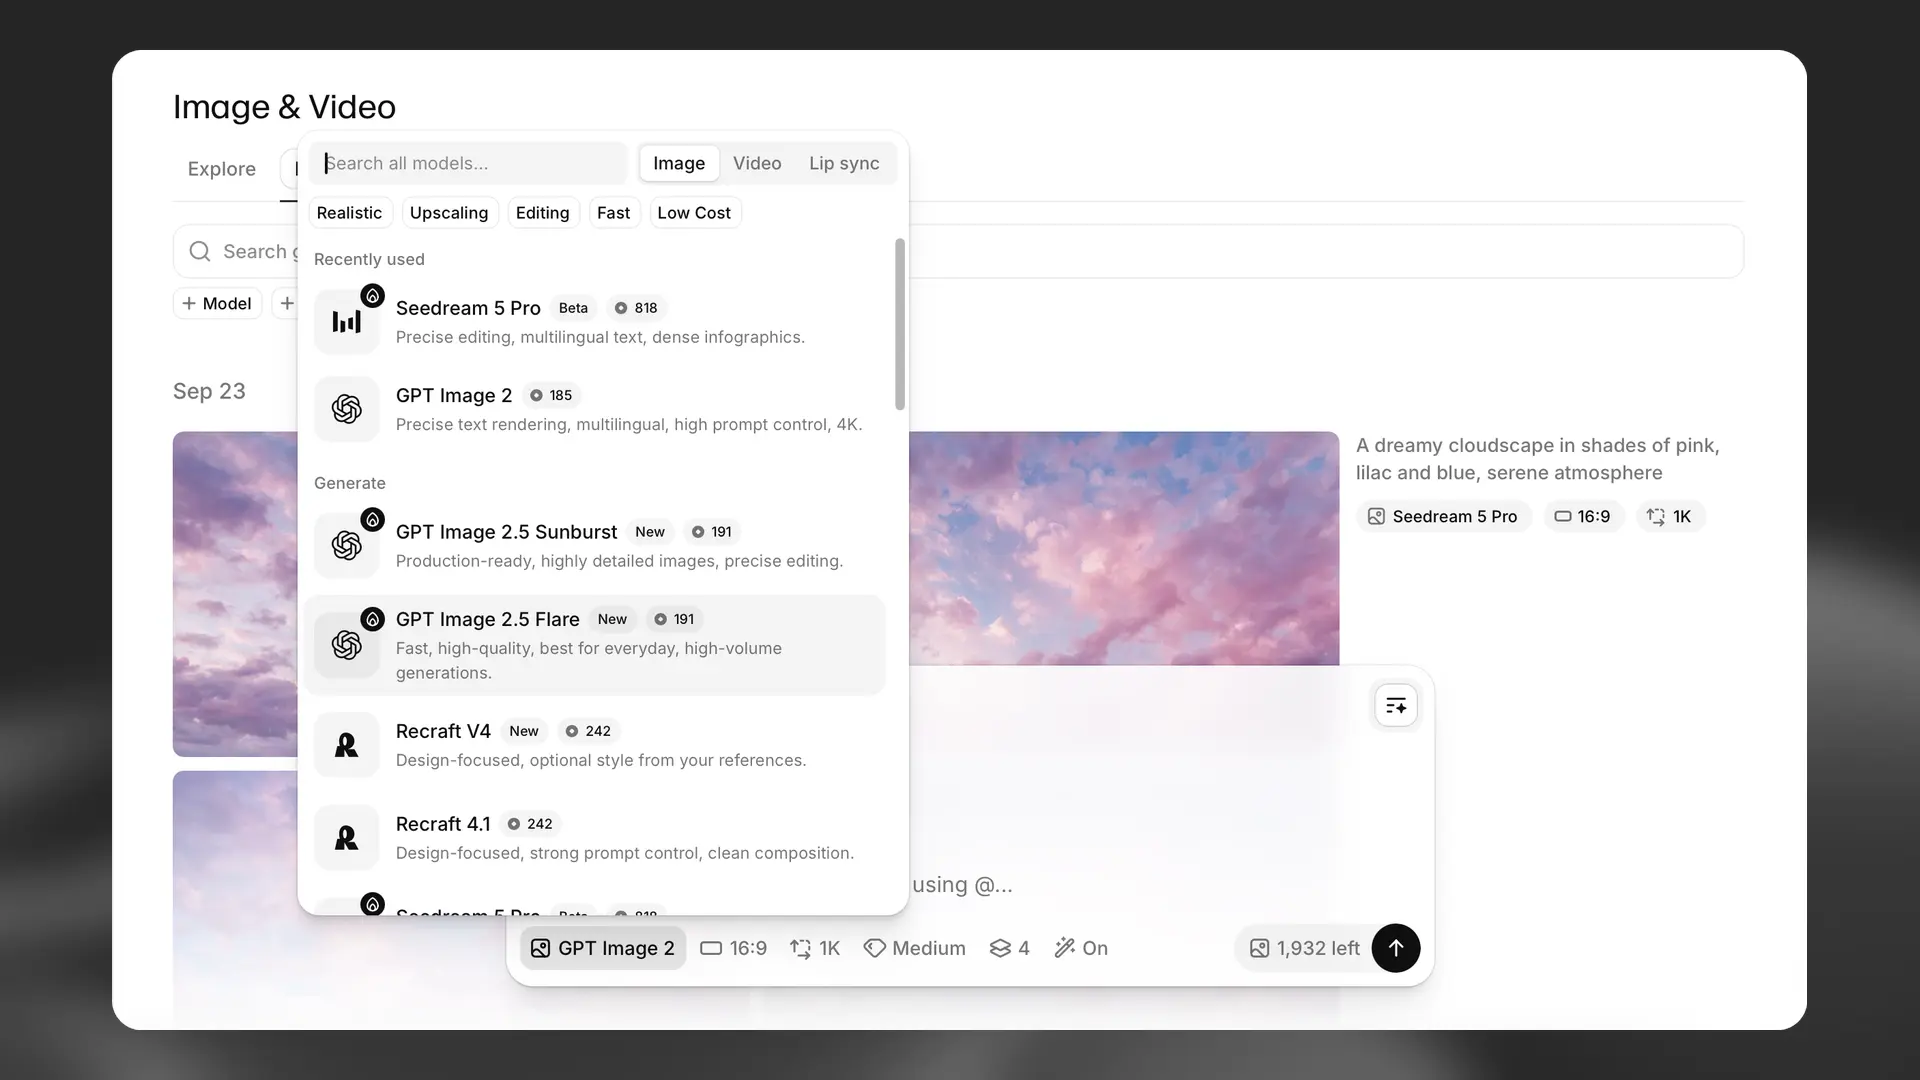
Sélectionnez un modèle : Ouvrez le menu des modèles pour parcourir les options disponibles, telles que Google Veo 3.1, Kling 2.5 ou Flux 1 Kontext Pro. Les atouts et capacités propres à chaque modèle sont indiqués pour faciliter la comparaison. Consultez la section Modèles pour obtenir des informations détaillées.
Ajustez les paramètres : Affinez votre génération à l’aide des paramètres affichés sous le prompt. Ils varient selon le modèle, mais comprennent souvent :
- Format d’image : contrôlez les dimensions de votre résultat
- Résolution : définissez le niveau de qualité
- Durée : spécifiez la durée de la vidéo, en mode vidéo
- Nombre de générations : créez jusqu’à 4 variations à la fois
Utilisez les contrôles : Sur les modèles compatibles, activez l’audio, ajoutez un prompt négatif pour exclure les éléments indésirables ou ajustez le contrôle du son.
Ajoutez des références
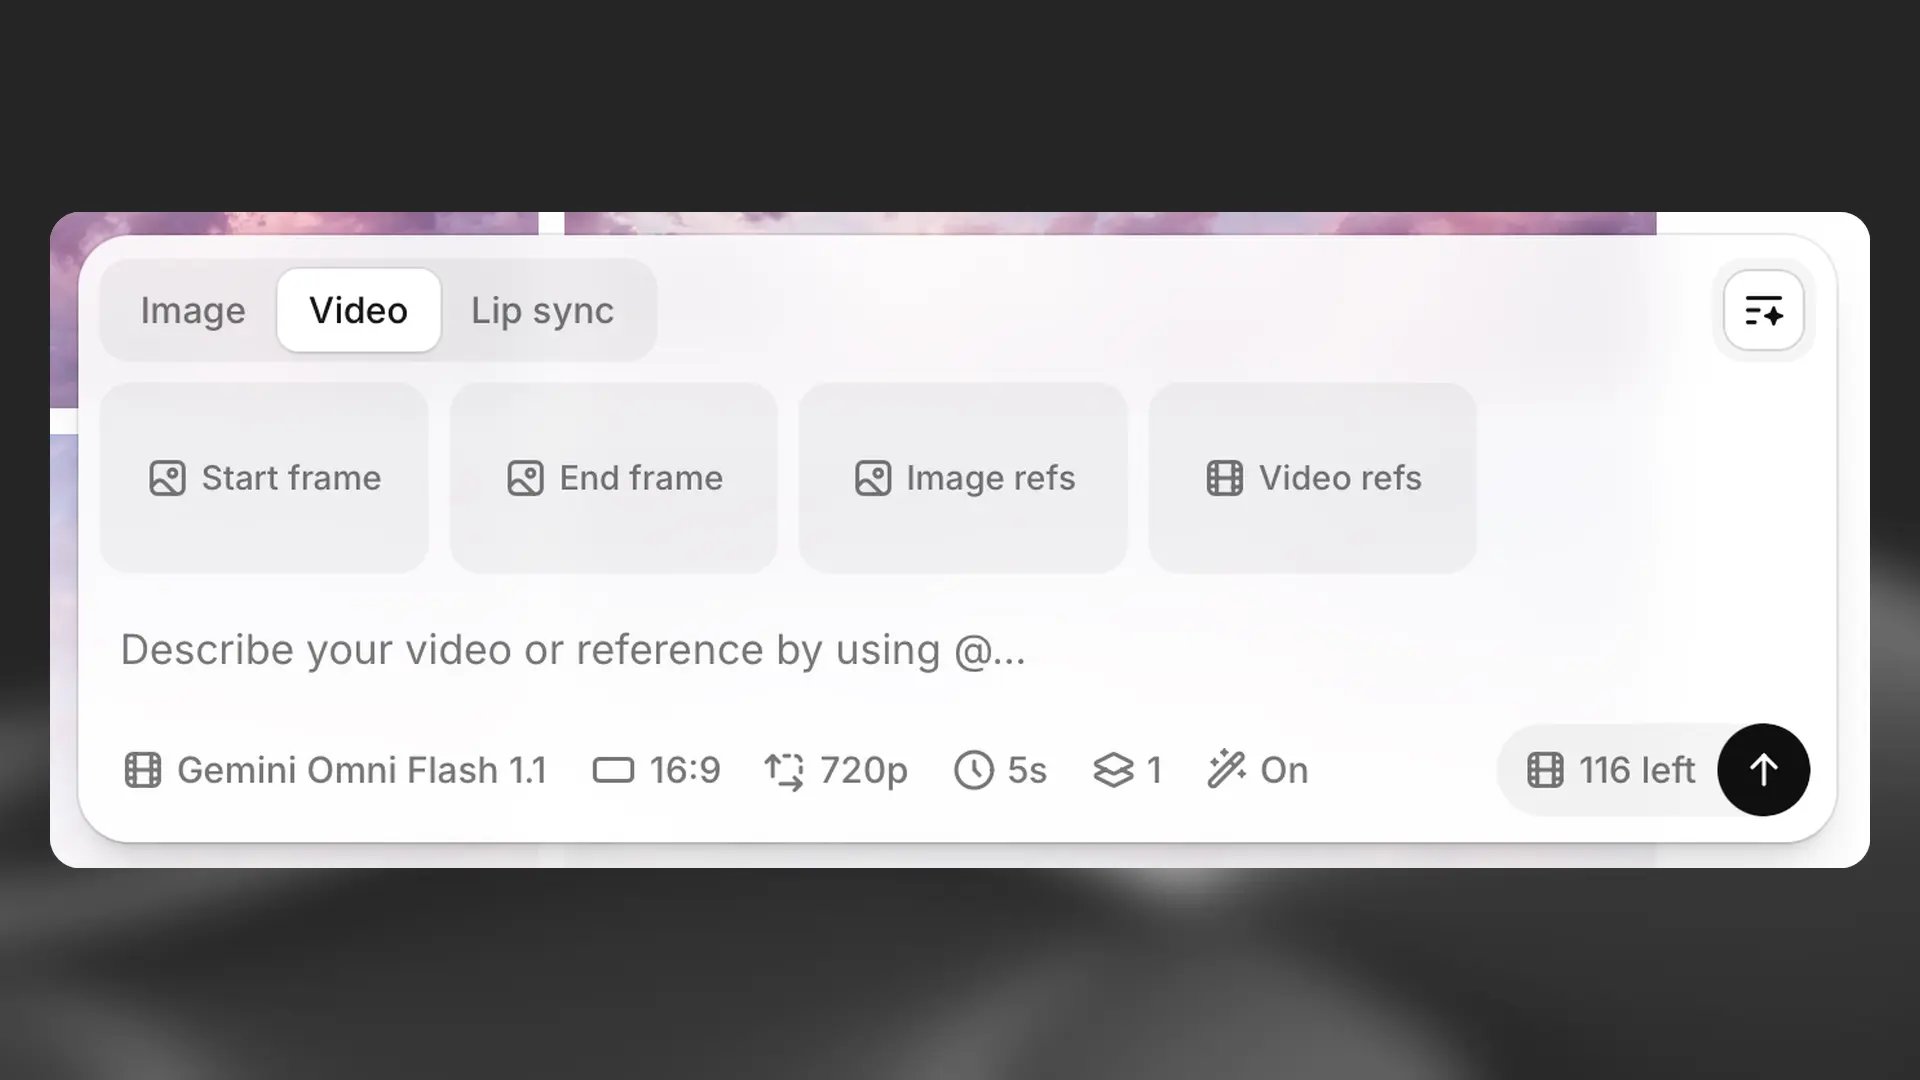
Pour mieux contrôler le résultat, ajoutez des références visuelles pour guider la génération. Leur disponibilité dépend du modèle sélectionné. Nous prenons en charge de nombreux formats d’image, notamment JPG, PNG, WEBP et plus encore.
Image de début, vidéo : Définit l’image d’ouverture de votre vidéo.
Image de fin, vidéo : Définit l’image finale et influence la transition.
Références d’image, image ou vidéo : Ajoutez une ou plusieurs images pour guider le style et l’apparence générale.
Faites glisser des éléments directement depuis les onglets Explorer ou Historique vers les emplacements de référence pour un workflow plus rapide.
Générer
Avant la génération, un indicateur de coût affiche le coût total correspondant au nombre d’éléments que vous avez choisi de créer. Lorsque vous êtes prêt, cliquez sur Générer. Vos nouvelles créations apparaîtront dans l’onglet Historique.
Historique
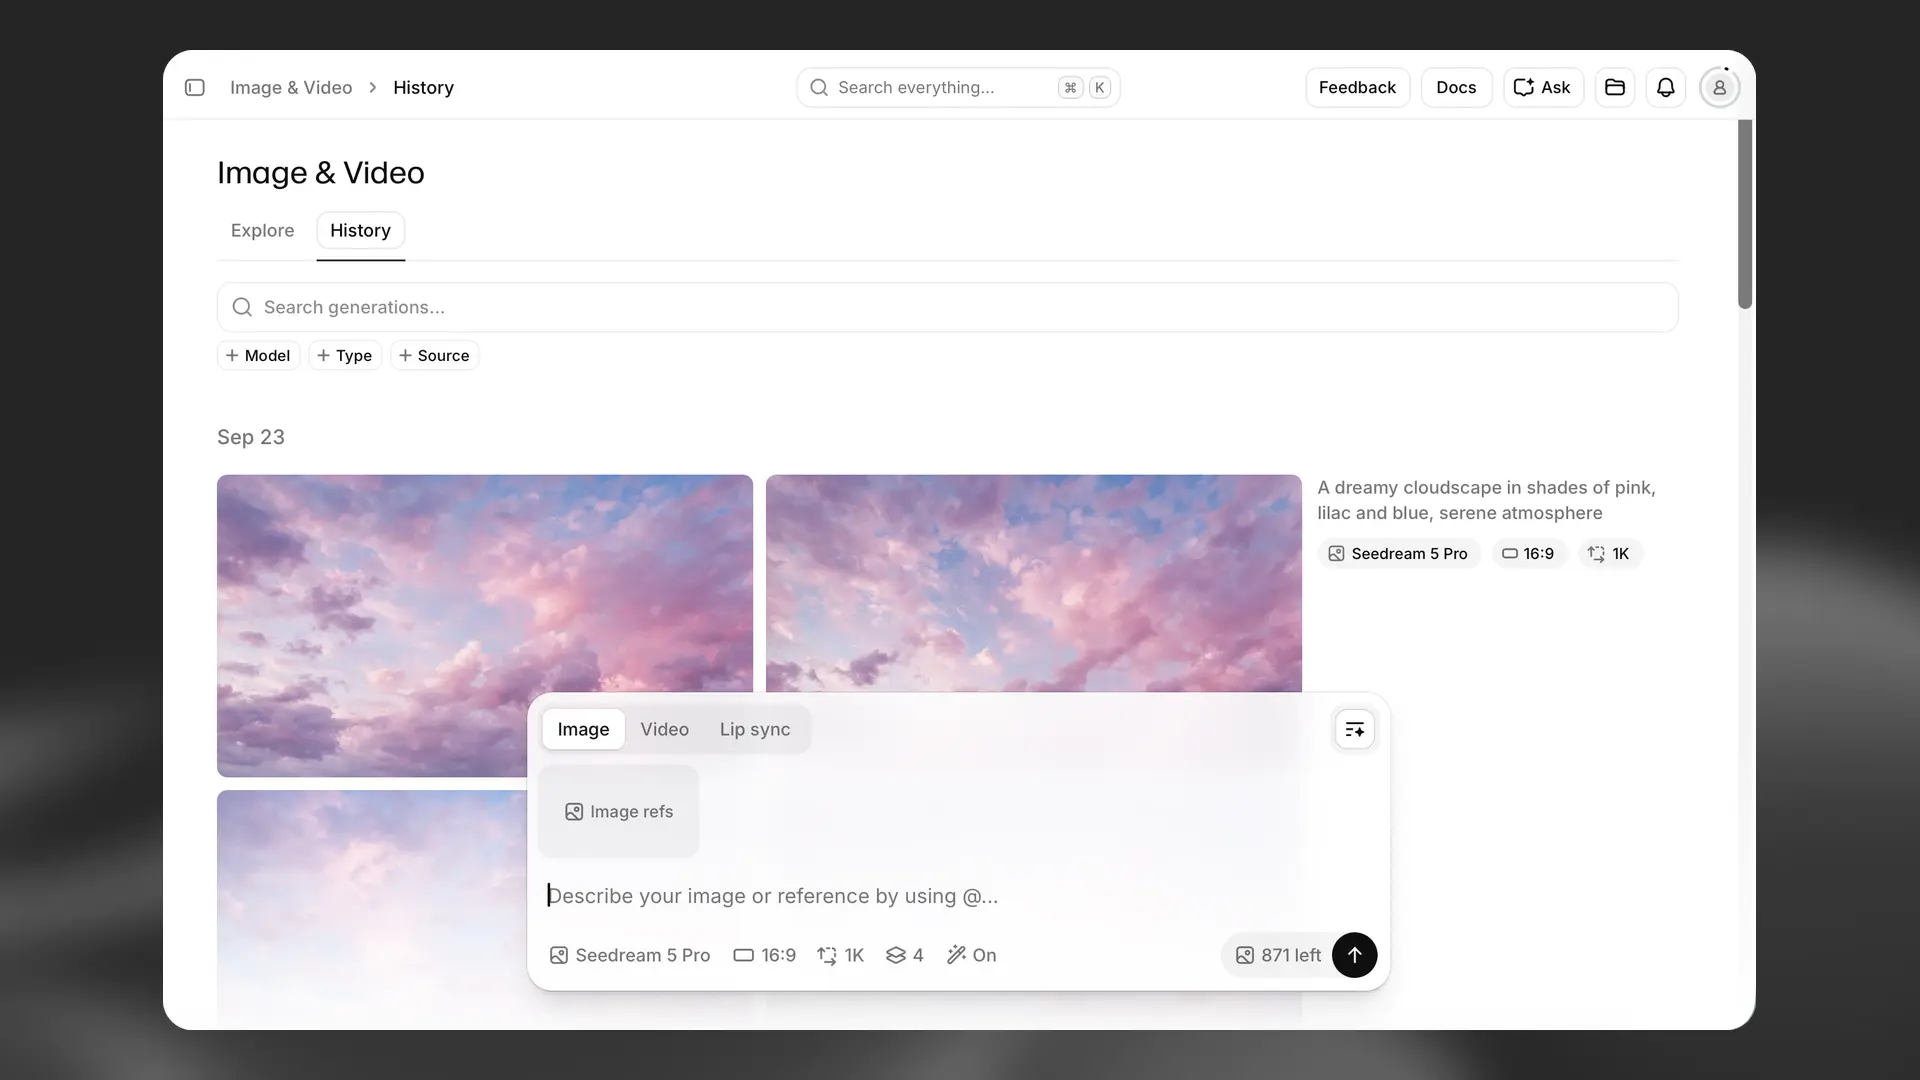
L’onglet Historique fournit un journal chronologique de tout ce que vous avez généré et sert d’espace de travail pour affiner vos créations précédentes.
Parcourir : Affichez toutes les images et vidéos précédentes.
Examiner : Cliquez sur un élément pour voir le prompt, le modèle et les paramètres d’origine utilisés pour le créer.
Réutiliser : Faites glisser des éléments de l’Historique vers la zone de prompt pour les utiliser comme références dans de nouvelles générations.
Itérer : Cliquez sur Recréer pour relancer le même prompt avec les mêmes paramètres afin d’obtenir une nouvelle variation, ou ajustez les paramètres pour orienter la génération dans une nouvelle direction.
Partager : Cliquez sur Partager pour générer un lien unique vers votre élément. Envoyez-le à vos collègues et collaborateurs pour obtenir leurs commentaires.
Exporter : Téléchargez votre élément sous forme de fichier indépendant ou cliquez sur Modifier dans Studio pour l’importer directement dans ElevenCreative Studio.
Exporter
Une fois que vous êtes satisfait d’une génération, utilisez les outils d’amélioration intégrés avant de l’exporter.
Améliorer vos créations
Augmenter la résolution : Utilisez Topaz Upscale pour augmenter la résolution jusqu’à 4 fois tout en préservant les détails nets.
Synchronisation labiale : Appliquez une synchronisation labiale réaliste à vos visuels :
- Omnihuman 1.5 : animez une image statique à l’aide d’une piste audio
- Veed LipSync : doublez une vidéo existante avec un nouvel audio
Exporter vos éléments
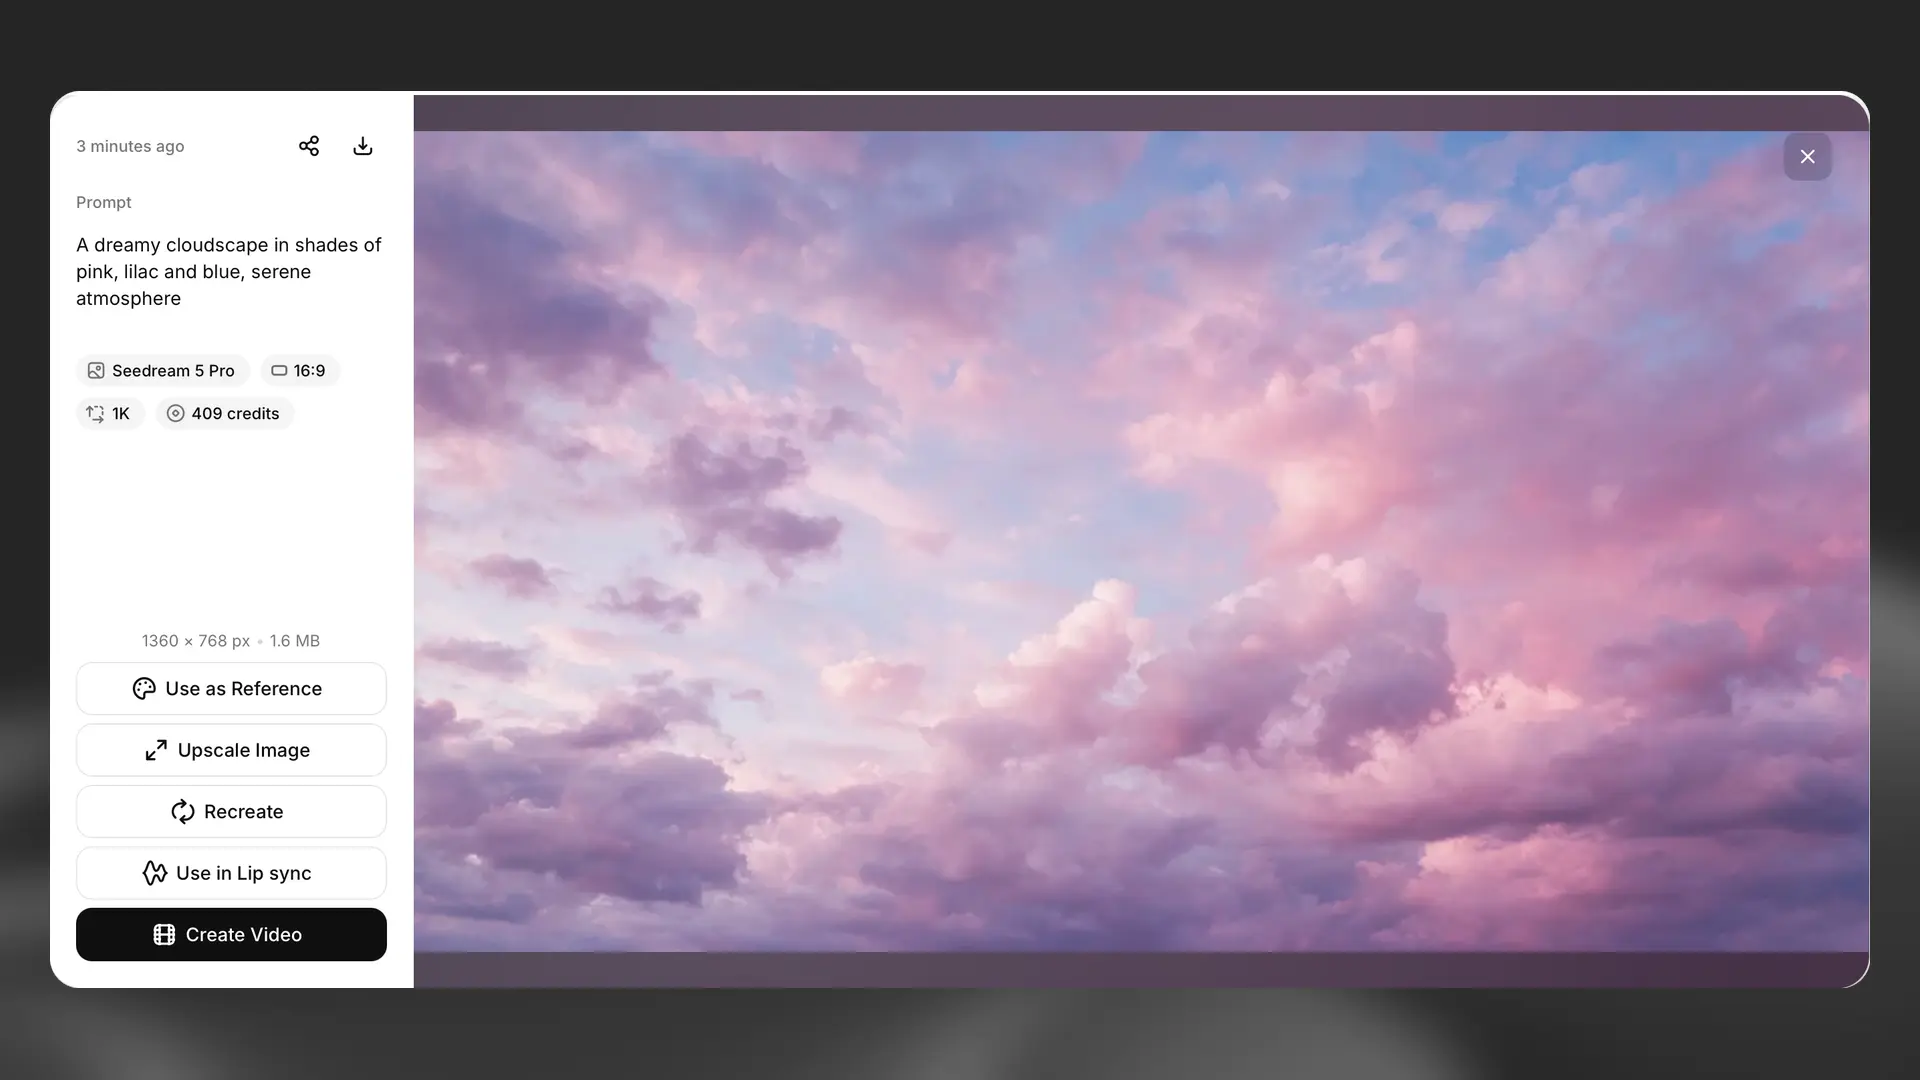
Exportez les éléments finalisés en les téléchargeant localement ou en les envoyant directement à ElevenCreative Studio.
Modifier dans Studio : Importez l’élément directement dans un projet ElevenCreative Studio.
Télécharger : Enregistrez l’élément sur votre ordinateur.
Formats de téléchargement pris en charge
Vidéo :
- MP4 : codecs H.264, H.265. Qualité jusqu’à 4K, avec mise à l’échelle
Image :
- PNG : rendu haute résolution sans perte
Modèles
Image & Vidéo donne accès à des modèles spécialisés, optimisés pour différents cas d’usage. Chaque modèle offre des capacités distinctes, de l’itération rapide à une qualité prête pour la production.
Les modèles de post-traitement nécessitent un résultat déjà généré, mais vous pouvez également importer votre propre fichier image ou vidéo.
Les administrateurs des Workspaces Enterprise peuvent contrôler les modèles de génération d’images et de vidéos accessibles aux membres du Workspace. Par défaut, tous les modèles sont désactivés pour les Workspaces Enterprise et doivent être explicitement activés par les administrateurs. En savoir plus sur les approbations de modèles.
Pour les requêtes API, les modèles ByteDance sont désactivés par défaut et nécessitent une approbation explicite avant utilisation. Les clients Enterprise peuvent contacter le support pour demander l’accès.
Tous les modèles ci-dessous sont disponibles dans l’application Image & Vidéo. Les modèles également accessibles depuis
l’API Image & Vidéo indiquent leur model_id sous
API ; les autres sont disponibles uniquement dans l’application.
Modèles génératifs vidéo
Seedance 2.0
Un modèle vidéo multimodal unifié avec génération conjointe audio-vidéo, offrant un contrôle de niveau réalisateur sur l’interprétation, l’éclairage, les ombres et les mouvements de caméra pour des résultats ultra-réalistes et cinématographiques.
Entrées de génération :
- Texte vers vidéo
- Image de début
- Image de fin
- Références d’images
- Références vidéo
- Références audio
Fonctionnalités :
- Architecture multimodale unifiée qui génère conjointement un audio et une vidéo synchronisés en une seule passe
- Capacités de référence et d’édition multimodales de premier plan, acceptant simultanément des entrées textuelles, d’image, audio et vidéo
- Stabilité de mouvement exceptionnelle avec un réalisme de niveau cinématographique conforme aux standards du secteur
- Contrôle créatif de niveau réalisateur sur l’interprétation, l’éclairage, les ombres et les mouvements de caméra
- Durées de génération flexibles de 4 s à 15 s
- Contrôle natif du son, activé ou désactivé pour chaque génération
- Création par lots, avec jusqu’à 4 générations simultanées
Options de sortie :
- Résolutions : 480p, 720p, 1080p
- Formats d’image : 21:9, 16:9, 4:3, 1:1, 3:4, 9:16
Idéal pour :
- La narration cinématographique nécessitant un audio et des visuels synchronisés
- Le contenu piloté par références, avec une fidélité stricte aux images, vidéos ou fichiers audio sources
- Les productions professionnelles nécessitant un contrôle précis de l’éclairage et du travail de caméra
Coût : varie selon les paramètres sélectionnés et la durée
API : bytedance-seedance-v2
Les paramètres peuvent être modifiés pour ajuster la consommation de crédits.
Seedance 2.0 n’est pas disponible aux États-Unis.
Seedance 2.0 Fast
Une variante plus rapide et moins coûteuse de Seedance 2.0, avec les mêmes entrées de référence multimodales, limitée à une sortie en 720p.
Entrées de génération :
- Texte vers vidéo
- Image de début
- Image de fin
- Références d’images (jusqu’à 9)
- Références vidéo (jusqu’à 3, 15 s au total)
- Références audio (jusqu’à 3, 15 s au total)
Fonctionnalités :
- Même gestion des références que Seedance 2.0, avec une limite cumulée de 12 références par génération
- Les images et les références s’excluent mutuellement : utilisez une image de début ou de fin, ou des références, mais pas les deux
- Durées de génération flexibles de 4 s à 15 s
- Contrôle natif du son, activé ou désactivé pour chaque génération
- Création par lots, avec jusqu’à 4 générations simultanées
Options de sortie :
- Résolutions : 480p, 720p
- Formats d’image : 21:9, 16:9, 4:3, 1:1, 3:4, 9:16
Idéal pour :
- Itérer sur des prompts Seedance 2.0 avant un rendu en pleine résolution
- Les clips pilotés par références pour lesquels une sortie en 720p suffit
Coût : varie selon les paramètres sélectionnés et la durée
API : bytedance-seedance-v2-fast
Seedance 2.0 Fast n’est pas disponible aux États-Unis.
Seedance 2.0 Mini
La plus petite variante de Seedance 2.0 : environ deux fois plus rapide que Seedance 2.0 pour environ la moitié du coût, avec les mêmes entrées et une sortie en 720p.
Entrées de génération :
- Texte vers vidéo
- Image de début
- Image de fin
- Références d’images (jusqu’à 9)
- Références vidéo (jusqu’à 3, 15 s au total)
- Références audio (jusqu’à 3, 15 s au total)
Fonctionnalités :
- Même gestion des références que Seedance 2.0, avec une limite cumulée de 12 références par génération
- Les images et les références s’excluent mutuellement : utilisez une image de début ou de fin, ou des références, mais pas les deux
- Durées de génération flexibles de 4 s à 15 s
- Contrôle natif du son, activé ou désactivé pour chaque génération
- Création par lots, avec jusqu’à 4 générations simultanées
Options de sortie :
- Résolutions : 480p, 720p
- Formats d’image : 21:9, 16:9, 4:3, 1:1, 3:4, 9:16
Idéal pour :
- Les brouillons et aperçus à grand volume
- Les flux de travail sensibles aux coûts nécessitant tout de même des entrées audio et de référence
Coût : varie selon les paramètres sélectionnés et la durée
API : bytedance-seedance-v2-mini
Seedance 2.0 Mini n’est pas disponible aux États-Unis.
Seedance 2.5
Le successeur de Seedance 2.0, avec un réalisme plus précis, jusqu’à 50 références combinées d’images, de vidéos et d’audio, et des générations allant jusqu’à 30 secondes.
Entrées de génération :
- Texte vers vidéo
- Image de début
- Image de fin
- Références d’images (jusqu’à 30)
- Références vidéo (jusqu’à 10, 30 s au total)
- Références audio (jusqu’à 10, 30 s au total)
Fonctionnalités :
- Aucune limite cumulée entre les types de références ; les références audio seules sont acceptées sans image ni vidéo
- Les images et les références s’excluent mutuellement
- Durées de génération flexibles de 4 s à 30 s
- Le format d’image est défini par l’image de début ou la vidéo de référence lorsqu’elle est fournie
- Contrôle natif du son, activé ou désactivé pour chaque génération
- Création par lots, avec jusqu’à 4 générations simultanées
Options de sortie :
- Résolutions : 480p, 720p
- Formats d’image : 21:9, 16:9, 4:3, 1:1, 3:4, 9:16
Idéal pour :
- Les clips longs qui doivent rester cohérents avec de nombreuses références
- Les scènes de dialogue et d’interprétation guidées par un audio de référence
Coût : varie selon les paramètres sélectionnés et la durée
API : bytedance-seedance-v2.5
Seedance 2.5 ne propose pas de contrôle de seed.
Seedance 2.5 n’est pas disponible aux États-Unis.
Seedance 2.5 Video Edit
Modifie une vidéo existante en décrivant les changements. La durée de sortie et le format d’image suivent la vidéo d’entrée.
Entrées de génération :
- Vidéo à modifier (obligatoire, jusqu’à 30 s)
- Prompt textuel décrivant les modifications
- Références d’images (jusqu’à 30)
- Références vidéo supplémentaires (jusqu’à 10, 30 s au total)
- Références audio (jusqu’à 10, 30 s au total)
Fonctionnalités :
- Aucun contrôle de durée : la sortie correspond à la durée de la vidéo d’entrée
- Le format d’image est défini par la vidéo d’entrée
- Contrôle natif du son, activé ou désactivé pour chaque génération
- Création par lots, avec jusqu’à 4 générations simultanées
Options de sortie :
- Résolutions : 480p, 720p
Idéal pour :
- Modifier les costumes, accessoires, l’éclairage ou le décor de séquences existantes
- Le transfert de style tout en préservant le mouvement d’origine
Coût : varie selon les paramètres sélectionnés et la durée
Seedance 2.5 Video Edit n’est pas disponible aux États-Unis.
Seedance 2.5 Video Extend
Prolonge une vidéo existante à partir de sa fin, guidé par un prompt et des références facultatives.
Entrées de génération :
- Vidéo à prolonger (obligatoire, jusqu’à 30 s)
- Prompt textuel décrivant la suite
- Références d’images (jusqu’à 30)
- Références vidéo supplémentaires (jusqu’à 10, 30 s au total)
- Références audio (jusqu’à 10, 30 s au total)
Fonctionnalités :
- Durée d’extension de 4 s à 30 s
- Le format d’image est défini par la vidéo d’entrée
- Contrôle natif du son, activé ou désactivé pour chaque génération
- Création par lots, avec jusqu’à 4 générations simultanées
Options de sortie :
- Résolutions : 480p, 720p
Idéal pour :
- Allonger un plan qui se termine trop tôt
- Enchaîner plusieurs générations dans une séquence plus longue
Coût : varie selon les paramètres sélectionnés et la durée
Seedance 2.5 Video Extend n’est pas disponible aux États-Unis.
Kling 3.0
Un modèle vidéo avancé qui fonctionne comme un réalisateur IA et préserve une grande cohérence des personnages, objets et scènes lors de mouvements de caméra complexes.
Entrées de génération :
- Texte vers vidéo
- Image de début
- Image de fin
Fonctionnalités :
- Préservation haute fidélité des personnages et des scènes à l’aide de références d’images ou de vidéos sous plusieurs angles
- Co-génération audio-visuelle native avec synchronisation labiale multilingue et sons d’ambiance
- Durées de génération flexibles de 3 s à 15 s
- Générez jusqu’à 4 variations simultanément
- Gestion améliorée du texte, de la dynamique des fluides et des interactions physiques complexes
Options de sortie :
- Résolutions : 1080p uniquement
- Formats d’image : 16:9, 1:1, 9:16
Idéal pour :
- La narration centrée sur les personnages nécessitant une continuité visuelle
- Les publicités et ressources avec des besoins spécifiques de rendu de texte
Coût : varie selon les paramètres sélectionnés et la durée
Prend en charge les prompts négatifs pour un contrôle précis. Le son peut être activé ou désactivé pour chaque génération.
Kling 3.0 n’est pas disponible aux États-Unis.
Kling O3
Un modèle vidéo à forte cohérence qui fonctionne comme un réalisateur IA et préserve l’identité des personnages, objets et scènes lors de mouvements de caméra complexes.
Entrées de génération :
- Texte vers vidéo
- Image de début
- Image de fin
- Référence vidéo
- Référence d’image
Fonctionnalités :
- Préserve une identité visuelle précise des personnages et objets principaux à l’aide de références sous plusieurs angles
- Prend en charge des durées de génération fluides de 3 s à 15 s
- Générez jusqu’à 4 variations simultanément
- Modélisation précise des interactions entre éléments et cohérence des mouvements
- Prise en charge native de l’audio activé ou désactivé pour chaque génération
Options de sortie :
- Résolutions : 1080p uniquement
- Formats d’image : 16:9, 1:1, 9:16
Idéal pour :
- La narration centrée sur les personnages nécessitant une continuité visuelle stricte
- Les ressources professionnelles de marketing et de marque avec un rendu cohérent des objets
Coût : varie selon les paramètres sélectionnés et la durée
Les paramètres peuvent être modifiés pour ajuster la consommation de crédits.
Kling O3 n’est pas disponible aux États-Unis.
Kling O3 Edit
Un modèle de montage vidéo à vidéo piloté en langage naturel, basé sur l’architecture O3, qui permet des transformations visuelles complexes, telles que le remplacement de personnages et le changement d’environnement, sans masquage manuel ni ajustements image par image.
Entrées de génération :
- Vidéo source
- Références d’images (jusqu’à 4 éléments ou angles distincts)
- Description textuelle (instructions en langage naturel)
Fonctionnalités :
- Interprète les prompts conversationnels pour remplacer des sujets ou décors tout en respectant la structure de mouvement d’origine
- Préserve les angles de caméra, schémas de mouvement et relations spatiales d’origine tout au long de la modification
- Combine jusqu’à 4 éléments au total, y compris des images de face et sous plusieurs angles, afin d’assurer une forte cohérence des personnages
- Possibilité de conserver l’audio source d’origine ou de générer une sortie silencieuse pour chaque génération
- Générez jusqu’à 4 variations modifiées simultanément
Options de sortie :
- Résolutions : dépendent de la vidéo source
- Formats d’image : identiques à la vidéo source
Idéal pour :
- Le remplacement haute fidélité de personnages dans des séquences existantes, tout en conservant les mouvements d’origine
- Les transformations complètes d’environnements de scène, par exemple passer d’une ville de jour à un paysage nocturne futuriste
- L’application de transferts de style nécessitant le strict respect de la dynamique de caméra existante
Coût : varie selon la durée de la vidéo et les paramètres sélectionnés
Kling O3 Edit n’est pas disponible aux États-Unis.
Google Veo 3.1
Un modèle de niveau professionnel pour la génération de vidéos cinématographiques de haute qualité.
Entrées de génération :
- Texte vers vidéo
- Image de début
- Image de fin
- Références d’images
Fonctionnalités :
- Excellente qualité et contrôle créatif grâce aux prompts négatifs
- Audio entièrement intégré et synchronisé
- Dialogues, synchronisation labiale et effets sonores réalistes
- Durées fixes : 4 s, 6 s et 8 s
- Création par lots, avec jusqu’à 4 générations simultanées
- Contrôle dédié du son
Options de sortie :
- Résolutions : 720p, 1080p
- Formats d’image : 16:9, 9:16
Idéal pour :
- La génération de vidéos cinématographiques de haute qualité avec un contrôle créatif complet
Coût : varie selon les paramètres sélectionnés et la durée
API : veo-3.1-generate-001
L’activation ou la désactivation du son modifie les crédits de génération.
Google Veo 3.1 Fast
Un modèle haute vitesse optimisé pour les aperçus et générations rapides, offrant des visuels plus précis avec une latence réduite.
Entrées de génération :
- Texte vers vidéo
- Image de début
- Image de fin
Fonctionnalités :
- Contrôle créatif avancé avec prompts négatifs et contrôle dédié du son
- Durées fixes : 4 s, 6 s et 8 s
- Création par lots, avec jusqu’à 4 générations simultanées
- Modélise avec précision la physique du monde réel pour des mouvements et interactions réalistes
Options de sortie :
- Résolutions : 720p, 1080p
- Formats d’image : 16:9, 9:16
Idéal pour :
- L’itération rapide et les visuels de tests A/B
- La création rapide de contenu pour les réseaux sociaux
Coût : varie selon les paramètres sélectionnés et la durée
Google Veo 3.1 Lite
Une variante de Veo 3.1 rapide et économique, optimisée pour une génération rapide avec une puissance de calcul réduite.
Entrées de génération :
- Texte vers vidéo
- Image de début
Fonctionnalités :
- Contrôle créatif précis avec prompts négatifs et contrôle dédié du son
- Durées fixes : 4 s, 6 s et 8 s
- Création par lots, avec jusqu’à 4 générations simultanées
Options de sortie :
- Résolutions : 720p
- Formats d’image : 16:9, 9:16
Idéal pour :
- La création de contenu à grand volume, lorsque la rapidité et l’efficacité des coûts sont prioritaires
- L’exploration rapide de concepts et les aperçus
Coût : varie selon les paramètres sélectionnés et la durée
Gemini Omni Flash 1.1
Le modèle vidéo de Google prenant en compte la physique, avec audio natif, sortie jusqu’en 4K, interpolation d’images et génération guidée par références.
Entrées de génération :
- Texte vers vidéo
- Image de début
- Image de fin
- Références d’images (jusqu’à 10)
- Références vidéo (jusqu’à 3, jusqu’à 10 s chacune)
Fonctionnalités :
- Les images et les références s’excluent mutuellement : interpolez entre les images ou guidez la génération avec des références
- Durées fixes de 3 s à 10 s ; la durée suit la vidéo de référence lorsqu’elle est jointe
- Rendu performant des textes et libellés courts à l’écran
- Création par lots, avec jusqu’à 4 générations simultanées
Options de sortie :
- Résolutions : 360p, 720p, 1080p, 4K
- Formats d’image : 16:9, 9:16
Idéal pour :
- Les vidéos explicatives et la typographie cinétique avec du texte lisible
- Des mouvements physiquement réalistes avec des sujets cohérents entre les références
Coût : varie selon les paramètres sélectionnés et la durée
Gemini Omni Flash 1.1 Extend
Prolonge une vidéo existante à partir de sa fin avec Gemini Omni Flash 1.1, jusqu’à une durée totale de 40 secondes.
Entrées de génération :
- Vidéo à prolonger (obligatoire, jusqu’à 30 s)
- Prompt textuel décrivant la suite
Fonctionnalités :
- Durée d’extension de 3 s à 10 s
- Le format d’image suit la vidéo d’entrée
- Création par lots, avec jusqu’à 4 générations simultanées
Options de sortie :
- Résolutions : 360p, 720p, 1080p, 4K
Idéal pour :
- Allonger les générations Gemini Omni Flash sans coupe visible
- Créer des séquences plus longues que ne le permet une seule génération
Coût : varie selon les paramètres sélectionnés et la durée
Gemini Omni Flash
Le premier modèle vidéo Gemini Omni : mouvements prenant en compte la physique, audio natif et meilleur rendu de texte à l’écran parmi les modèles vidéo disponibles, en 720p.
Entrées de génération :
- Texte vers vidéo
- Références d’images (jusqu’à 8)
- Référence vidéo (1, jusqu’à 10 s)
Fonctionnalités :
- Durées fixes de 3 s à 10 s ; la durée suit la vidéo de référence lorsqu’elle est jointe
- Aucune image de début ou de fin ; utilisez plutôt des références d’images pour ancrer un sujet
- Création par lots, avec jusqu’à 4 générations simultanées
Options de sortie :
- Résolutions : 720p
- Formats d’image : 16:9, 9:16
Idéal pour :
- Les légendes courtes, titres et vidéos explicatives avec libellés
- La cohérence entre plusieurs images en 720p
Coût : varie selon les paramètres sélectionnés et la durée
Seedance 1.5 Pro
Un modèle spécialisé amélioré pour créer des séquences dynamiques haute fidélité, avec une stabilité temporelle accrue et un contrôle précis des transitions entre les images clés.
Entrées de génération :
- Texte vers vidéo
- Image de début
- Image de fin
Fonctionnalités :
- Relie harmonieusement les images de début et de fin pour des séquences cohérentes à plusieurs plans
- Modélisation haute fidélité d’actions complexes et cohérence de l’environnement
- Prend en charge des durées de génération fixes de 4 s à 12 s
- Générez jusqu’à 4 variantes à la fois
- Prise en charge native de l’activation ou de la désactivation de l’audio pour chaque génération
Options de sortie :
- Résolutions : 420p, 720p
- Formats d’image : 21:9, 16:9, 4:3, 1:1, 3:4, 9:16
Idéal pour :
- Les récits et scènes d’action nécessitant une physique stable entre des repères visuels précis
- Les transitions cinématographiques et ressources vidéo professionnelles avec des exigences strictes de début et de fin
Coût : Varie selon les paramètres sélectionnés et la durée
Seedance 1.5 Pro est obsolète. ByteDance retirera ce modèle le 11 novembre 2026, et il n’est plus proposé pour les nouvelles générations. Utilisez plutôt un modèle Seedance 2.0. Seedance 1.5 Pro n’est pas disponible aux États-Unis.
FLUX 3
Le modèle vidéo de Black Forest Labs, avec mouvements naturels, scènes à plusieurs plans, audio généré et extension vidéo.
Entrées de génération :
- Texte vers vidéo
- Image de début
- Image de fin
- Vidéo à prolonger (1, jusqu’à 15 s)
Fonctionnalités :
- L’extension vidéo est incompatible avec les images de début et de fin
- Durées de génération flexibles de 5 s à 20 s
- Contrôle natif du son avec audio activé ou désactivé pour chaque génération
- Création par lot avec jusqu’à 4 générations à la fois
Options de sortie :
- Résolutions : 720p, 1080p
- Formats d’image : 21:9, 2:1, 16:9, 4:3, 1:1, 3:4, 9:16
Idéal pour :
- Les scènes à plusieurs plans à partir d’un seul prompt
- Prolonger un clip existant avec des mouvements et un audio cohérents
Coût : Varie selon les paramètres sélectionnés et la durée
MiniMax H3
Le modèle vidéo phare de MiniMax, avec références multimodales, audio généré et sortie jusqu’en 4K.
Entrées de génération :
- Texte vers vidéo
- Image de début
- Image de fin
- Références d’images (jusqu’à 9)
- Références vidéo (jusqu’à 3, de 2 s à 15 s chacune, 15 s au total)
- Références audio (jusqu’à 3, de 2 s à 15 s chacune, 15 s au total)
Fonctionnalités :
- Limite cumulée de 12 références par génération ; les références audio nécessitent au moins une référence d’image ou de vidéo
- Les images et les références sont incompatibles
- Durées de génération flexibles de 5 s à 15 s
- Génère un audio synchronisé
- Création par lot avec jusqu’à 4 générations à la fois
Options de sortie :
- Résolutions : 480p, 768p, 2K, 4K (les résolutions 2K et 4K sont mises à l’échelle depuis 768p)
- Formats d’image : 21:9, 16:9, 4:3, 1:1, 3:4, 9:16
Idéal pour :
- Les scènes basées sur des références qui nécessitent une livraison en haute résolution
- Les clips de dialogue guidés par un audio de référence
Coût : Varie selon les paramètres sélectionnés et la durée
MiniMax H3 n’est pas disponible aux États-Unis.
MiniMax H3 Max
Une variante quasi instantanée de MiniMax H3, avec les mêmes entrées et une esthétique soignée, rendue nativement jusqu’en 768p.
Entrées de génération :
- Texte vers vidéo
- Image de début
- Image de fin
- Références d’images (jusqu’à 9)
- Références vidéo (jusqu’à 3, de 2 s à 15 s chacune, 15 s au total)
- Références audio (jusqu’à 3, de 2 s à 15 s chacune, 15 s au total)
Fonctionnalités :
- Limite cumulée de 12 références par génération ; les références audio nécessitent au moins une référence d’image ou de vidéo
- Les images et les références sont incompatibles
- Durées de génération flexibles de 5 s à 15 s
- Génère un audio synchronisé
- Création par lot avec jusqu’à 4 générations à la fois
Options de sortie :
- Résolutions : 480p, 768p
- Formats d’image : 21:9, 16:9, 4:3, 1:1, 3:4, 9:16
Idéal pour :
- Itérer rapidement sur les prompts et les références
- Les aperçus avant le rendu avec MiniMax H3
Coût : Varie selon les paramètres sélectionnés et la durée
MiniMax H3 Max n’est pas disponible aux États-Unis.
Kling O1
Un modèle vidéo de raisonnement de pointe conçu pour une excellente fidélité aux prompts et une simulation complexe du monde physique, utilisant un traitement logique avancé pour interpréter et exécuter des instructions détaillées.
Entrées de génération :
- Texte vers vidéo (description)
- Image de début et image de fin
- Référence vidéo
- Référence d’image
Fonctionnalités :
- Capacité exceptionnelle à interpréter des prompts à plusieurs niveaux et à exécuter des actions chronologiques complexes
- Utilise à la fois des images et des vidéos comme repères visuels pour maintenir une grande cohérence des personnages et des scènes
- Modélisation avancée des interactions physiques, des liens de cause à effet et de la dynamique des fluides
- Prend en charge la génération haute qualité de clips de 5 s et 10 s
- Générez jusqu’à 4 variantes à la fois
Options de sortie :
- Résolutions : selon l’entrée
- Formats d’image : 16:9, 1:1, 9:16
Idéal pour :
- Les concepts créatifs très spécifiques nécessitant de respecter précisément des descriptions longues et détaillées
- Les récits professionnels où le réalisme physique et la cohérence entre plusieurs références sont essentiels
Coût : Varie selon les paramètres sélectionnés et la durée
Kling O1 n’est pas disponible aux États-Unis.
Kling O1 Edit
Un modèle de montage vidéo à vidéo piloté par le langage naturel, qui permet des transformations visuelles complexes, comme le remplacement de personnages ou de décors, sans masquage manuel ni ajustement image par image.
Entrées de génération :
- Vidéo source
- Références d’images (jusqu’à 4 éléments ou angles distincts)
- Description textuelle (instructions en langage naturel)
Fonctionnalités :
- Interprète les prompts conversationnels pour remplacer les sujets ou les décors tout en respectant la structure de mouvement d’origine
- Conserve les angles de caméra, les schémas de mouvement et les relations spatiales d’origine tout au long du montage
- Combine jusqu’à 4 éléments au total, y compris des images de face et sous plusieurs angles, pour assurer une grande cohérence des personnages
- Option permettant de conserver l’audio source d’origine ou de générer une sortie silencieuse pour chaque génération
- Générez jusqu’à 4 variantes modifiées à la fois
Options de sortie :
- Résolutions : selon la vidéo source
- Formats d’image : identiques à la vidéo source
Idéal pour :
- Le remplacement haute fidélité de personnages dans des séquences existantes, tout en conservant les mouvements d’origine
- Les transformations complètes de l’environnement d’une scène, par exemple en transformant une ville de jour en paysage nocturne futuriste
- L’application de transferts de style nécessitant de respecter strictement la dynamique de caméra existante
Coût : Varie selon la durée de la vidéo et les paramètres sélectionnés
Kling O1 Edit n’est pas disponible aux États-Unis.
Kling 2.6 Motion Control
Un modèle spécialisé pour un transfert précis des mouvements, qui vous permet d’animer l’image d’un personnage à l’aide d’une vidéo de référence afin de reproduire des mouvements, gestes et angles de caméra spécifiques.
Entrées de génération :
- Image du personnage (source)
- Vidéo de mouvement (référence)
- Description textuelle (facultatif)
Fonctionnalités :
- Choisissez « Correspondre à la vidéo » pour une reproduction exacte des mouvements ou « Correspondre à l’image » pour ajouter de nouveaux mouvements créatifs à un personnage
- Prend en charge jusqu’à 30 s en mode Correspondre à la vidéo et 10 s en mode Correspondre à l’image
- Transposition haute fidélité des mouvements humains d’une séquence de référence vers un personnage fixe
- Prise en charge native de l’activation ou de la désactivation de l’audio pour chaque génération
- Générez jusqu’à 4 variantes à la fois
Options de sortie :
- Résolutions : selon la source
- Formats d’image : selon la source
Idéal pour :
- Reproduire une chorégraphie complexe ou des mouvements spécifiques sur un personnage personnalisé
- L’animation de personnages longue durée nécessitant une grande fidélité des mouvements
- Les contenus pour les réseaux sociaux inspirés de mouvements vidéo populaires
Coût : Varie selon les paramètres sélectionnés et la durée
Kling 2.6 Motion Control n’est pas disponible aux États-Unis.
Kling 3.0 Motion Control
Un modèle spécialisé pour un transfert précis des mouvements, fondé sur l’architecture Kling 3.0, qui vous permet d’animer l’image d’un personnage à l’aide d’une vidéo de référence afin de reproduire avec davantage de fidélité des mouvements, gestes et angles de caméra spécifiques.
Entrées de génération :
- Image du personnage (source)
- Vidéo de mouvement (référence)
- Description textuelle (facultatif)
Fonctionnalités :
- Choisissez « Correspondre à la vidéo » pour une reproduction exacte des mouvements ou « Correspondre à l’image » pour ajouter de nouveaux mouvements créatifs à un personnage
- Prend en charge jusqu’à 30 s en mode Correspondre à la vidéo et 10 s en mode Correspondre à l’image
- Transposition haute fidélité des mouvements humains d’une séquence de référence vers un personnage fixe
- Prise en charge native de l’activation ou de la désactivation de l’audio pour chaque génération
- Générez jusqu’à 4 variantes à la fois
Options de sortie :
- Résolutions : selon la source
- Formats d’image : selon la source
Idéal pour :
- Reproduire une chorégraphie complexe ou des mouvements spécifiques sur un personnage personnalisé
- L’animation de personnages longue durée nécessitant une grande fidélité des mouvements
- Les contenus pour les réseaux sociaux inspirés de mouvements vidéo populaires
Coût : Varie selon les paramètres sélectionnés et la durée
Kling 3.0 Motion Control n’est pas disponible aux États-Unis.
Kling 2.6
Un modèle génératif optimisé conçu pour améliorer la fidélité des mouvements et fluidifier les transitions, offrant un équilibre entre itération rapide et rendu visuel de qualité production.
Entrées de génération :
- Texte vers vidéo
- Image de début (image vers vidéo)
Fonctionnalités :
- Dynamique des mouvements améliorée : progrès significatifs dans la fluidité des mouvements et le réalisme des interactions physiques
- Contrôle du son flexible : prise en charge native de l’activation ou de la désactivation de l’audio pour chaque génération
- Création par lot : générez jusqu’à 4 variantes simultanément
- Affinage détaillé : contrôle créatif avancé grâce à la prise en charge des prompts négatifs
- Durées fixes : prend en charge des générations de 5 s et 10 s
Options de sortie :
- Résolutions : selon l’entrée
- Formats d’image : 16:9, 1:1, 9:16
Idéal pour :
- Les clips très dynamiques nécessitant des mouvements fluides des personnages
- Les contenus professionnels pour les réseaux sociaux avec une grande fidélité aux prompts
Coût : Varie selon les paramètres sélectionnés et la durée
Kling 2.6 n’est pas disponible aux États-Unis.
Kling 2.5
Un modèle équilibré et polyvalent pour générer des vidéos Full HD de haute qualité.
Entrées de génération :
- Texte vers vidéo
- Image de début
Fonctionnalités :
- Excelle dans la simulation de mouvements complexes et d’une physique réaliste
- Modélise avec précision la dynamique des fluides et les expressions
- Durées fixes : 5 s et 10 s
- Création par lot avec jusqu’à 4 générations à la fois
Options de sortie :
- Résolutions : 1080p
- Formats d’image : 16:9, 1:1, 9:16
Idéal pour :
- Les simulations physiques réalistes et les mouvements complexes
Coût : Varie selon les paramètres sélectionnés et la durée
L’image de fin n’est actuellement pas prise en charge. Il n’est pas possible de fournir des références d’images. Le contrôle du son n’est pas disponible.
Kling 2.5 n’est pas disponible aux États-Unis.
Runway Gen-4.5
Une qualité de mouvement, une fidélité aux prompts et une fidélité visuelle de pointe pour des vidéos cinématographiques très réalistes.
Entrées de génération :
- Texte vers vidéo
- Image de début (image vers vidéo)
Fonctionnalités :
- Qualité de mouvement exceptionnelle, avec un réalisme et une simulation physique de premier plan
- Fidélité supérieure aux prompts pour un contrôle créatif précis des scènes complexes
- Grande fidélité visuelle pour un rendu de qualité cinématographique
- Générez jusqu’à 4 variantes simultanément
Options de sortie :
- Résolutions : 720p
- Formats d’image : 16:9, 9:16
Idéal pour :
- Les contenus cinématographiques nécessitant une qualité de mouvement et un réalisme élevés
- Les productions professionnelles exigeant une fidélité précise aux prompts
- Les récits visuels haute fidélité
Coût : Varie selon les paramètres sélectionnés et la durée
Runway Gen-4 Turbo
Un modèle vidéo avancé conçu pour l’itération rapide et une création rentable, capable de produire des vidéos de haute qualité.
Entrées de génération :
- Texte vers vidéo
- Image de début (image vers vidéo)
Fonctionnalités :
- Optimisé pour une génération ultrarapide, avec des résultats jusqu’à quatre fois plus rapides que les itérations précédentes
- Permet de diriger précisément les mouvements des personnages, les angles de caméra et les compositions de scène
- Excelle à préserver la cohérence et la stabilité visuelles dans les scènes dynamiques
- Prend en charge des durées de génération de 2 s à 10 s
- Générez jusqu’à 4 variantes simultanément
Options de sortie :
- Résolutions : 720p
- Formats d’image : 21:9, 16:9, 4:3, 1:1, 3:4, 9:16
Idéal pour :
- Le prototypage rapide et l’expérimentation créative nécessitant un retour quasi instantané
- Les projets professionnels nécessitant des délais courts pour des ressources marketing haute résolution
- Les contenus cinématographiques avec des exigences spécifiques en matière de mouvements de caméra
Coût : Varie selon les paramètres sélectionnés et la durée
Runway Gen-4 Aleph
Un modèle vidéo contextuel de pointe conçu pour la génération visuelle multitâche, capable d’effectuer des montages complexes tout en conservant la structure sous-jacente des séquences source.
Entrées de génération :
- Vidéo source
- Image de référence
- Description textuelle
Fonctionnalités :
- Ajoutez, supprimez ou transformez harmonieusement des objets et des sujets dans une scène, avec un éclairage, des ombres et une perspective naturels
- Modifiez les lieux, les saisons et le moment de la journée, par exemple en transformant une séquence nuageuse en coucher de soleil spectaculaire, avec des ajustements réalistes de la température des couleurs
- Modifiez l’âge et l’apparence des acteurs ou la texture des vêtements et des sujets à l’aide de simples prompts en langage naturel
- Appliquez le mouvement précis et la trajectoire de caméra d’une vidéo de référence à une image fixe pour un contrôle précis de l’animation
- Générez des angles de caméra entièrement nouveaux, comme des champs-contrechamps ou des contre-plongées, à partir d’une seule séquence vidéo existante
- Inclut un détourage précis sur fond vert, avec isolation et détection des contours, la génération du plan suivant pour poursuivre le récit et le transfert de style esthétique
- Générez jusqu’à 4 variantes simultanément
Options de sortie :
- Résolutions : 720p
- Formats d’image : automatique
Idéal pour :
- Les tâches d’effets visuels professionnels comme le rajeunissement numérique, le rééclairage et la suppression d’objets
- Le prototypage cinématographique rapide et la génération de couvertures caméra alternatives à partir d’un seul plan
- Les contenus marketing créatifs nécessitant des transformations radicales de l’environnement ou du style
Coût : Varie selon les paramètres sélectionnés et la durée
Runway Aleph 2.0
Le modèle de montage vidéo de Runway : transforme une vidéo existante vers une esthétique cible tout en préservant les mouvements et la cohérence.
Entrées :
- Vidéo source (requise, de 2 s à 30 s)
- Image d’esthétique cible (requise)
- Prompt textuel décrivant les modifications
Fonctionnalités :
- La durée et le cadrage de sortie suivent la vidéo source
- Transfert de style guidé par l’image d’esthétique cible
- Création par lot avec jusqu’à 4 générations à la fois
Idéal pour :
- Rééclairer, modifier le style ou changer le décor de séquences existantes
- Appliquer l’esthétique d’une image de référence à un clip entier
Coût : Varie selon les paramètres sélectionnés et la durée
Runway Act-Two
Un modèle spécialisé de transfert de performance qui anime des personnages en transposant les mouvements, la parole et les expressions faciales d’une vidéo de performance sur une image ou une vidéo de référence du personnage.
Entrées de génération :
- Performance source (vidéo)
- Entrée du personnage (image ou vidéo)
Fonctionnalités :
- Transfère directement les expressions faciales nuancées, la synchronisation labiale et l’audio synchronisé d’un acteur source vers n’importe quel personnage
- Ajoute automatiquement des mouvements secondaires et de légers tremblements de caméra aux images de personnages statiques pour un rendu plus naturel
- Option précise pour activer ou désactiver les mouvements du corps et des mains lors de l’utilisation d’une image de personnage
- Paramètres ajustables pour équilibrer une performance émotionnelle intense et la cohérence visuelle du personnage
- Possibilité de modifier la voix du personnage après la génération tout en conservant un alignement parfait avec la performance source
Options de sortie :
- Résolutions : 720p
- Formats d’image : automatique
Idéal pour :
- Donner vie à des portraits de personnages statiques avec des mouvements et une parole humains réalistes
- Animer des personnages non humains ou des avatars stylisés avec des expressions haute fidélité
- Produire rapidement des contenus face caméra avec des gestes corporels intégrés
Coût : Varie selon les paramètres sélectionnés et la durée
Seedance 1 Pro
Un modèle spécialisé pour créer des séquences dynamiques à plusieurs plans, avec de grands mouvements et de l’action.
Entrées de génération :
- Texte vers vidéo
- Image de début
- Image de fin
Fonctionnalités :
- Physique très stable et transitions fluides entre les plans
- Durées fixes : 3 s, 4 s, 5 s, 6 s, 7 s, 8 s, 9 s, 10 s, 11 s et 12 s
- Création par lot avec jusqu’à 4 générations à la fois
- Flexibilité créative maximale grâce à de nombreuses options de formats d’image
Options de sortie :
- Résolutions : 480p, 720p, 1080p
- Formats d’image : 21:9, 16:9, 4:3, 1:1, 3:4, 9:16
Idéal pour :
- Les récits et scènes d’action nécessitant une physique stable
Coût : Varie selon les paramètres sélectionnés et la durée
Le format d’image et la résolution n’affectent pas les crédits de génération, contrairement à la durée.
Seedance 1 Pro n’est pas disponible aux États-Unis.
LTX Audio-to-Video
Un modèle de fondation basé sur DiT, conçu pour générer simultanément des vidéos et de l’audio synchronisés, afin de garantir des dialogues cohérents et des mouvements réalistes.
Entrées de génération :
- Texte vers vidéo
- Image vers vidéo
- Audio vers vidéo
- Profondeur vers vidéo
Fonctionnalités :
- Génère simultanément les dialogues, les mouvements des lèvres et l’audio ambiant pour un alignement parfait, sans outils externes
- Scènes dynamiques avec des mouvements stables, une identité cohérente et une forte cohérence d’une image à l’autre
- Prend en charge la génération synchronisée haute fidélité pendant jusqu’à 20 secondes
- Direction créative avancée grâce à la prise en charge détaillée des prompts négatifs
- Générez jusqu’à 4 variations à la fois
Options de sortie :
- Résolutions : 720p, 1080p
- Formats d’image : 16:9, 4:3, 1:1, 3:4, 9:16
Idéal pour :
- Des dialogues cohérents et des performances expressives de personnages
- Du contenu narratif nécessitant un audio ambiant intégré et une temporalité cohérente
- Des scènes dynamiques avec une logique de mouvement complexe tenant compte de la caméra
Coût : Varie selon les paramètres sélectionnés et la durée
LTX 2 Pro
Un modèle génératif haute fidélité optimisé pour un niveau de détail visuel maximal et une grande stabilité structurelle, capable de produire des contenus 4K de qualité production avec des mouvements fluides.
Entrées de génération :
- Texte vers vidéo
- Image de départ (image vers vidéo)
Fonctionnalités :
- Privilégie la qualité visuelle et la cohérence à la vitesse, pour des résultats stables sur des séquences étendues
- Prend en charge 25 FPS et 50 FPS pour des mouvements exceptionnellement fluides et professionnels
- Génération audiovisuelle intégrée avec activation ou désactivation du son
- Conçu pour gérer des sorties natives en 1080p, 2k et 4k sans perte de détail
- Générez jusqu’à 4 variations à la fois
Options de sortie :
- Résolutions : 1080p, 2k, 4k
- Fréquences d’images : 25 FPS, 50 FPS
- Format d’image : 16:9 (par défaut)
- Durées : 6 s, 8 s, 10 s
Idéal pour :
- Des productions cinématographiques haute résolution nécessitant la netteté de la 4K
- Du contenu professionnel nécessitant des mouvements fluides à 50 FPS
- Des séquences détaillées où la stabilité visuelle et l’intégrité structurelle sont essentielles
Coût : Varie selon les paramètres sélectionnés et la durée
LTX 2 Retake
Un outil de réalisation IA de précision qui permet de modifier de manière ciblée les dialogues, les émotions et les actions dans des plans existants, sans rompre la continuité ni régénérer toute la séquence.
Entrées de génération :
- Vidéo source
- Description textuelle
Fonctionnalités :
- Modifiez des segments spécifiques tout en préservant fortement le contexte des images environnantes
- Reformulez les répliques tout en conservant la voix, l’interprétation et l’environnement du personnage
- Plusieurs modes d’édition : sélectionnez « Audio et vidéo », « Audio uniquement » ou « Vidéo uniquement » pour isoler et régénérer des éléments précis du plan
- Le nouveau contenu reprend naturellement les mouvements, l’éclairage et le ton d’origine pour des transitions fluides
- Testez instantanément d’autres réactions de personnage, temps forts émotionnels ou mouvements de caméra au sein d’un même plan
- Générez simultanément jusqu’à 4 variations pour les comparer côte à côte
Options de sortie :
- Formats d’image : 16:9 uniquement
Idéal pour :
- Ajuster des scripts et affiner des dialogues sans nouveau tournage ni nouvel enregistrement
- Corriger des temps forts émotionnels ou des problèmes de rythme en postproduction
- Tester plusieurs messages de marque et appels à l’action dans un même support marketing
Coût : Varie selon les paramètres sélectionnés et la durée
LTX 2 Fast
Un modèle génératif optimisé pour la vitesse, conçu pour des boucles de retours rapides et une création de contenu à cadence élevée, offrant des visuels haute résolution avec des temps de rendu considérablement réduits.
Entrées de génération :
- Texte vers vidéo
- Image de départ (image vers vidéo)
Fonctionnalités :
- Conçu pour la vitesse et l’itération rapide, il permet une expérimentation visuelle rapide et des aperçus quasi instantanés
- Prend en charge des sorties natives en 1080p, 2k et 4k avec une charge de calcul inférieure à celle du modèle Pro
- Prend en charge 25 FPS et 50 FPS pour des mouvements fluides à haute vitesse
- Permet de générer rapidement du contenu audiovisuel synchronisé pendant jusqu’à 20 secondes
- Prise en charge native de l’activation ou de la désactivation de l’audio pour chaque génération
- Générez simultanément jusqu’à 4 variations
Options de sortie :
- Résolutions : 1080p, 2k, 4k
- Fréquences d’images : 25 FPS, 50 FPS
- Format d’image : 16:9 (par défaut)
- Durées : 6 s, 8 s, 10 s, 12 s, 14 s, 16 s, 18 s, 20 s
Idéal pour :
- Le prototypage rapide et l’exploration créative lorsque la vitesse prime sur le niveau de détail maximal
- Du contenu pour les réseaux sociaux en grand volume nécessitant des délais de production courts
- Les tests A/B de différents concepts visuels et styles de mouvement
Coût : Varie selon les paramètres sélectionnés et la durée
Wan 3.0
Un modèle vidéo cinématographique avec des références d’images, de vidéos et d’audio, de l’audio généré et des générations pouvant atteindre 30 secondes.
Entrées de génération :
- Texte vers vidéo
- Image de départ
- Image de fin
- Références d’images (jusqu’à 10)
- Références vidéo (jusqu’à 5, 15 s au total)
- Références audio (jusqu’à 5, 15 s au total)
Fonctionnalités :
- Les images et les références s’excluent mutuellement
- Durées fixes : 5 s, 10 s, 15 s, 20 s et 30 s
- Contrôle natif du son, avec audio activé ou désactivé pour chaque génération
- Amélioration facultative des prompts
- Création par lots avec jusqu’à 4 générations à la fois
Options de sortie :
- Résolutions : 480p, 720p, 1080p
- Formats d’image : Auto, 16:9, 4:3, 1:1, 3:4, 9:16
Idéal pour :
- Des plans cinématographiques plus longs avec un fort respect du prompt
- Des scènes basées sur des références avec audio
Coût : Varie selon les paramètres sélectionnés et la durée
Wan 3.0 n’est pas disponible aux États-Unis.
Wan 3.0 Prime
Une variante plus rapide de Wan 3.0 avec les mêmes entrées et options de sortie, adaptée à l’idéation.
Entrées de génération :
- Texte vers vidéo
- Image de départ
- Image de fin
- Références d’images (jusqu’à 10)
- Références vidéo (jusqu’à 5, 15 s au total)
- Références audio (jusqu’à 5, 15 s au total)
Fonctionnalités :
- Environ deux fois moins de temps de génération que Wan 3.0
- Durées fixes : 5 s, 10 s, 15 s, 20 s et 30 s
- Contrôle natif du son, avec audio activé ou désactivé pour chaque génération
- Création par lots avec jusqu’à 4 générations à la fois
Options de sortie :
- Résolutions : 480p, 720p, 1080p
- Formats d’image : Auto, 16:9, 4:3, 1:1, 3:4, 9:16
Idéal pour :
- Explorer des idées avant un rendu final avec Wan 3.0
- Les flux de travail sensibles aux délais
Coût : Varie selon les paramètres sélectionnés et la durée
Wan 3.0 Prime n’est pas disponible aux États-Unis.
Wan 2.6
Une plateforme vidéo cinématographique de nouvelle génération qui s’appuie sur une architecture multimodale unifiée pour produire du contenu 1080p prêt pour la production, avec synchronisation audio native et séquençage intelligent de plusieurs plans.
Entrées de génération :
- Texte vers vidéo
- Image de départ (image vers vidéo)
- Référence vidéo (vidéo vers vidéo)
- Référence audio (audio d’ambiance ou dialogue facultatif)
Fonctionnalités :
- Système multimodal unifié : traite le texte, les images, la vidéo et l’audio dans un cadre intégré unique afin de garantir une qualité de sortie cohérente
- Synchronisation audio native : génère et aligne automatiquement les dialogues, la narration et les effets sonores environnementaux avec les mouvements à l’écran
- Séquençage intelligent de plusieurs plans : organise automatiquement les séquences vidéo connectées en arcs narratifs cohérents tout en préservant la cohérence des personnages
- Durées étendues : prend en charge une génération stable et de haute qualité pour des durées fixes de 5 s, 10 s et 15 s
- Contrôle créatif avancé : prend en charge les prompts négatifs pour une gestion détaillée et la création par lots de jusqu’à 4 variations
Options de sortie :
- Résolutions : 720p, 1080p
- Formats d’image : 16:9, 4:3, 1:1, 3:4, 9:16
Idéal pour :
- La narration professionnelle et les séquences cinématographiques complexes à plusieurs plans
- Les publicités sur les réseaux sociaux et le contenu marketing nécessitant un audio intégré haute fidélité
- Du contenu centré sur les personnages nécessitant une cohérence stricte des visuels et des mouvements grâce à des références vidéo
Coût : Varie selon les paramètres sélectionnés et la durée
Wan 2.6 n’est pas disponible aux États-Unis.
Wan 2.5 Video
Un modèle polyvalent qui produit des mouvements cinématographiques et une grande fidélité aux prompts à partir de texte ou d’une image de départ.
Entrées de génération :
- Texte vers vidéo
- Image de départ (image vers vidéo)
Fonctionnalités :
- Contrôle créatif détaillé avec des prompts négatifs et un contrôle du son dédié
- Durées fixes : 5 s et 10 s
- Création par lots avec jusqu’à 4 générations à la fois
Options de sortie :
- Résolutions : 480p, 720p, 1080p
- Formats d’image : 16:9, 1:1, 9:16
Idéal pour :
- Du contenu cinématographique avec un fort respect du prompt
Coût : Varie selon les paramètres sélectionnés et la durée
Le coût de génération varie selon les paramètres sélectionnés.
Wan 2.5 Video n’est pas disponible aux États-Unis.
Modèles génératifs d’images
GPT Image 2.5 Sunburst
Le modèle d’image prêt pour la production d’OpenAI, pour des résultats très détaillés et une édition précise.
Entrées de génération :
- Texte vers image
- Références d’images (jusqu’à 10)
Fonctionnalités :
- Cinq niveaux de qualité, de Faible à Maximum
- Résolution personnalisée jusqu’à 3 840 px par côté, avec des formats d’image allant jusqu’à 3:1
- Création par lots avec jusqu’à 4 générations à la fois
Options de sortie :
- Résolutions : 1K, 2K, 4K ou personnalisée
- Formats d’image : 3:1, 21:9, 2:1, 16:9, 3:2, 4:3, 5:4, 1:1, 4:5, 3:4, 2:3, 9:16, 1:2, 1:3
Idéal pour :
- Les éléments finaux où le détail et la fidélité sont essentiels
- Les modifications précises d’images existantes
Coût : Varie selon les paramètres sélectionnés et le nombre de variations
API : gpt-image-2.5-sunburst
GPT Image 2.5 Flare
Une variante rapide de GPT Image 2.5 avec les mêmes contrôles que Sunburst, optimisée pour la génération quotidienne à grand volume.
Entrées de génération :
- Texte vers image
- Références d’images (jusqu’à 10)
Fonctionnalités :
- Cinq niveaux de qualité, de Faible à Maximum
- Résolution personnalisée jusqu’à 3 840 px par côté, avec des formats d’image allant jusqu’à 3:1
- Création par lots avec jusqu’à 4 générations à la fois
Options de sortie :
- Résolutions : 1K, 2K, 4K ou personnalisée
- Formats d’image : 3:1, 21:9, 2:1, 16:9, 3:2, 4:3, 5:4, 1:1, 4:5, 3:4, 2:3, 9:16, 1:2, 1:3
Idéal pour :
- La génération d’images à grand volume
- Des itérations rapides nécessitant tout de même la 4K et des tailles personnalisées
Coût : Varie selon les paramètres sélectionnés et le nombre de variations
API : gpt-image-2.5-flare
GPT Image 2
Un modèle IA avancé conçu pour la génération précise d’images, avec un rendu de texte amélioré et des capacités de sortie haute résolution.
Fonctionnalités :
- Contrôle précis du texte pour créer des images avec une typographie exacte et nette
- Sortie PNG haute résolution adaptée à un usage professionnel et commercial
- Prend en charge plusieurs références d’images pour guider le style et la composition
- Génère jusqu’à 4 images à la fois
Options de sortie :
- Formats d’image : 3:2, 1:1, 2:3
- Options de qualité : faible, moyenne, élevée
Idéal pour :
- Des visuels marketing et éléments de design nécessitant un placement précis du texte
- Du contenu professionnel soumis à des exigences de haute résolution
- Des projets créatifs nécessitant un contrôle précis des images basées sur du texte
Coût : Varie selon les paramètres sélectionnés et le nombre de variations
API : gpt-image-2
Nano Banana 2
Un modèle avancé de génération d’images par IA combinant une qualité prête pour la production et un traitement ultra-rapide, avec une meilleure connaissance du monde et une meilleure cohérence des sujets.
Fonctionnalités :
- Sortie native en résolution 4K sans mise à l’échelle, pour des détails d’une netteté exceptionnelle
- Génération d’images ultra-rapide en seulement 1 à 2 secondes
- Respect supérieur des prompts grâce à un raisonnement avancé et au suivi des instructions
- Rendu net et précis du texte dans plusieurs langues, pour les maquettes, la signalétique et les infographies
- Style cohérent pour plusieurs sujets, préservant l’identité de plusieurs personnages et objets
- Meilleure connaissance du monde pour une génération de scènes plus précise
- Prend en charge plusieurs références d’images pour guider la génération
- Génère jusqu’à 4 images à la fois
Options de sortie :
- Formats d’image : 21:9, 16:9, 5:4, 4:3, 3:2, 1:1, 2:3, 3:4, 4:5, 9:16
- Résolutions : jusqu’à 4K
Idéal pour :
- Des flux de travail créatifs rapides nécessitant une itération en temps réel
- Du contenu de marque et de la narration avec une identité cohérente des personnages
- Des visuels professionnels avec du texte et une typographie précis
Coût : Varie selon les paramètres sélectionnés et le nombre de variations
API : gemini-3.1-flash-image
Nano Banana 2 Lite
Une variante rapide et économique de Nano Banana 2 pour la génération et l’édition rapides en 1K.
Entrées de génération :
- Texte vers image
- Références d’images (jusqu’à 14)
Fonctionnalités :
- Sortie fixe en 1K pour une vitesse et un coût constants
- Même capacité de 14 images de référence que Nano Banana 2
- Création par lots avec jusqu’à 4 générations à la fois
Options de sortie :
- Résolutions : 1K
- Formats d’image : 21:9, 16:9, 5:4, 4:3, 3:2, 1:1, 2:3, 3:4, 4:5, 9:16
Idéal pour :
- Les itérations rapides et les brouillons
- Les modifications en masse lorsque le 1K suffit
Coût : Varie selon les paramètres sélectionnés et le nombre de variations
Krea 2 Medium
Un modèle polyvalent de génération d’images prêt pour la production de Krea AI, qui équilibre qualité et vitesse pour un large éventail de flux de travail créatifs.
Fonctionnalités :
- Génération d’images haute fidélité avec un fort respect des prompts
- Prend en charge plusieurs références d’images pour guider la génération
- Génère jusqu’à 4 images à la fois
Options de sortie :
- Formats d’image : 16:9, 4:3, 1:1, 3:4, 9:16
Idéal pour :
- La création de contenu professionnel nécessitant une qualité constante
- L’itération rapide sur divers concepts créatifs
Coût : Varie selon les paramètres sélectionnés et le nombre de variations
Krea 2 Large
Le modèle phare de génération d’images de Krea AI, offrant une fidélité visuelle maximale et un contrôle créatif avancé pour les flux de travail de production professionnelle.
Fonctionnalités :
- Niveau de détail et réalisme exceptionnels pour des résultats de qualité professionnelle
- Contrôle avancé du style avec prise en charge de plusieurs références d’images
- Génère jusqu’à 4 images à la fois
Options de sortie :
- Formats d’image : 16:9, 4:3, 1:1, 3:4, 9:16
Idéal pour :
- La production d’images commerciales et éditoriales haut de gamme
- Des compositions créatives complexes nécessitant une fidélité maximale
Coût : Varie selon les paramètres sélectionnés et le nombre de variations
Recraft V4.1
Un modèle texte vers image axé sur le design, avec un contrôle précis des prompts et des compositions épurées.
Entrées de génération :
- Texte vers image
Fonctionnalités :
- La sortie en 2K utilise la variante de modèle Pro
- Création par lots avec jusqu’à 4 générations à la fois
Options de sortie :
- Résolutions : 1K, 2K
- Formats d’image : 2:1, 16:9, 3:2, 14:10, 4:3, 5:4, 1:1, 4:5, 3:4, 10:14, 2:3, 6:10, 9:16, 1:2
Idéal pour :
- Des graphiques, icônes et affiches axés sur la mise en page
- Des compositions épurées à partir du texte seul
Coût : Varie selon les paramètres sélectionnés et le nombre de variations
Recraft V4
Un modèle d’image axé sur le design, capable de reproduire le style d’images de référence.
Entrées de génération :
- Texte vers image
- Références de style (jusqu’à 10)
Fonctionnalités :
- Contrôle de correspondance du style : Précis suit fidèlement le style de référence, Flexible reproduit l’apparence générale
- La sortie en 2K utilise la variante de modèle Pro
- Création par lots avec jusqu’à 4 générations à la fois
Options de sortie :
- Résolutions : 1K, 2K
- Formats d’image : 2:1, 16:9, 3:2, 14:10, 4:3, 5:4, 1:1, 4:5, 3:4, 10:14, 2:3, 6:10, 9:16, 1:2
Idéal pour :
- Des graphiques cohérents avec la marque à partir d’un ensemble de références de style
- L’illustration et le design
Coût : Varie selon les paramètres sélectionnés et le nombre de variations
Seedream 5 Lite
Un modèle d’image léger à génération rapide de ByteDance, offrant des résultats de haute qualité avec des besoins de calcul réduits.
Fonctionnalités :
- Génération rapide pour une itération créative accélérée
- Prend en charge plusieurs références d’images pour guider la génération
- Génère jusqu’à 4 images à la fois
Options de sortie :
- Formats d’image : 16:9, 4:3, 1:1, 3:4, 9:16
Idéal pour :
- Les flux de travail de création d’images à grand volume nécessitant de la rapidité
- L’exploration rapide de concepts et les aperçus
Coût : Varie selon les paramètres sélectionnés et le nombre de variations
API : bytedance-seedream-5-lite
Seedream 5 Lite n’est pas disponible aux États-Unis.
Seedream 5 Pro
La variante Seedream 5 haute fidélité pour une édition précise, du texte multilingue et des infographies denses.
Entrées de génération :
- Texte vers image
- Images de référence (jusqu’à 10)
Fonctionnalités :
- Rendu précis de texte multilingue
- Gère les mises en page denses, comme les infographies et les affiches
- Création par lots avec jusqu’à 4 générations à la fois
Options de sortie :
- Résolutions : 1K, 2K
- Formats d’image : 16:9, 4:3, 1:1, 3:4, 9:16
Idéal pour :
- Les créations riches en texte dans plusieurs langues
- L’édition de plusieurs images avec un respect strict des références
Coût : varie selon les paramètres sélectionnés et le nombre de variations
API : bytedance-seedream-5-pro
Seedream 5 Pro n’est pas disponible aux États-Unis.
GPT Image 1.5
Un modèle phare à haute vitesse conçu pour la génération précise d’images à partir de texte et la retouche photo complexe et non destructive, qui préserve les détails d’origine.
Fonctionnalités :
- Exécute de manière fiable les modifications demandées tout en préservant l’éclairage, la composition et l’apparence du sujet dans les images sources
- Prend en charge des tâches d’édition complexes, notamment l’ajout, la suppression, la combinaison et la fusion d’éléments
- Produit des résultats jusqu’à 4 fois plus rapidement que les versions précédentes
- Génère jusqu’à 4 images à la fois
Options de sortie :
- Formats d’image : 3:2, 1:1, 2:3
- Options de qualité : faible, moyenne, élevée
Idéal pour :
- Les retouches photo pratiques et les essais virtuels réalistes de vêtements ou de coiffures
- Les transformations conceptuelles et les filtres stylistiques qui préservent l’essence de l’image d’entrée
- L’itération rapide de concepts de texte vers image
Coût : varie selon les paramètres sélectionnés et le nombre de variations
API : gpt-image-1.5
GPT Image 1
Le modèle d’image de première génération d’OpenAI, avec un bon respect des prompts, du texte lisible et des capacités d’édition détaillées.
Entrées de génération :
- Texte vers image
- Images de référence (jusqu’à 5)
Fonctionnalités :
- Trois niveaux de qualité : faible, moyenne, élevée
- Création par lots avec jusqu’à 4 générations à la fois
Options de sortie :
- Formats d’image : 3:2, 1:1, 2:3
Idéal pour :
- Les workflows déjà conçus autour des résultats de GPT Image 1
- Les modifications simples et les tâches de texte dans l’image en résolution standard
Coût : varie selon les paramètres sélectionnés et le nombre de variations
API : gpt-image-1
Seedream 4.5
Un modèle de fondation multimodal haute performance qui réunit la synthèse de texte vers image, l’édition précise d’images et la composition complexe de plusieurs images dans un seul framework efficace.
Fonctionnalités :
- Prise en charge native de la génération rapide d’images haute fidélité jusqu’en résolution 4K
- Préservation exceptionnelle des traits du visage, de l’éclairage, de la tonalité des couleurs et des détails fins lors de tâches d’édition basées sur des références
- Identifie et fusionne avec précision les éléments ciblés entre plusieurs images d’entrée pour des résultats cohérents et contrôlables
- Offre des capacités de composition de niveau professionnel avec un rendu clair et précis des petits textes pour les affiches et les visuels de marque
- Génère jusqu’à 4 images à la fois
Options de sortie :
- Formats d’image : 16:9, 4:3, 1:1, 3:4, 9:16
- Résolutions : 2K, 4K
Idéal pour :
- Les workflows de conception graphique professionnelle nécessitant une mise en page et une typographie précises
- La retouche photo complexe exigeant un respect strict de l’identité et de l’éclairage de référence
- Le compositing créatif haute résolution à partir de plusieurs sources visuelles
Coût : varie selon les paramètres sélectionnés et le nombre de variations
Seedream 4.5 n’est pas disponible aux États-Unis.
Kling O1 Image
Un modèle de génération d’images haute fidélité doté de capacités de raisonnement avancées, conçu pour un respect supérieur des prompts et une cohérence visuelle précise dans les compositions complexes.
Fonctionnalités :
- Capacité exceptionnelle à interpréter et exécuter avec une grande précision des descriptions textuelles complexes à plusieurs niveaux
- Exploite des images de référence pour préserver l’identité du sujet, l’éclairage et le style esthétique entre les générations
- Optimisé pour les textures réalistes, les relations spatiales complexes et les effets d’éclairage de niveau professionnel
- Génère jusqu’à 4 images à la fois
Options de sortie :
- Formats d’image : automatique, 16:9, 9:16, 1:1, 4:3, 3:4, 3:2, 2:3, 21:9
- Résolutions : 1K, 2K
Idéal pour :
- Les ressources créatives professionnelles exigeant le respect strict de prompts textuels détaillés et techniques
- L’édition d’images très cohérente et la conception de personnages à partir de références visuelles
Coût : varie selon les paramètres sélectionnés et le nombre de variations
Kling O1 Image n’est pas disponible aux États-Unis.
FLUX.2 [Pro]
Un modèle de génération et d’édition d’images prêt pour la production, conçu pour les workflows professionnels. Il offre une qualité visuelle de pointe en mettant l’accent sur la vitesse, la précision et la cohérence.
Fonctionnalités :
- Référencez plusieurs images simultanément pour obtenir une cohérence de premier plan dans le secteur pour les personnages et les identités sur des centaines de ressources
- Offre un niveau de détail sans précédent, qui réduit l’écart avec la photographie réelle, des textures de tissu aux éléments architecturaux
- Fournit un rendu de texte prêt pour la production pour les typographies complexes, les maquettes d’interface et les infographies
- Prend en charge la spécification précise des couleurs de marque via des codes hexadécimaux, sans approximation
- Garantit un positionnement précis des objets, une physique réaliste, un éclairage cohérent et une perspective correcte dans les scènes complexes
- Optimisé pour une meilleure précision et réactivité face aux instructions structurées et complexes
- Génère jusqu’à 4 images à la fois
Options de sortie :
- Formats d’image : 16:9, 4:3, 1:1, 3:4, 9:16
- Résolutions : 720p, 1080p, 2K
Idéal pour :
- Mener des campagnes avec des personnages cohérents et placer précisément des produits dans tout contexte
- Créer des maquettes d’interface avec du texte lisible et des systèmes de conception visuelle cohérents
- Générer à grande échelle des photographies de produits et des prises de vue contextuelles de style de vie
Coût : varie selon les paramètres sélectionnés et le nombre de variations
Nano Banana Pro
Un modèle professionnel de génération et d’édition d’images basé sur le raisonnement, conçu pour produire des ressources haute fidélité, offrir un contrôle créatif avancé et suivre précisément les instructions.
Entrées :
- Image de référence
- Description textuelle (prend en charge les prompts complexes à plusieurs niveaux)
Fonctionnalités :
- Planifie les scènes avant le rendu afin d’offrir un éclairage fidèle à la physique, des relations précises entre les objets et un respect supérieur des prompts
- Génère du texte multilingue net et lisible dans divers styles de police et d’écriture manuscrite, pour des affiches et maquettes de produits percutantes
- Préserve une fidélité et une ressemblance élevées pour jusqu’à 5 personnes et plusieurs objets dans des créations variées
- Intègre Google Search pour enrichir les visuels avec des données réelles, des connaissances du monde réel et des informations en temps réel comme la météo ou les résultats sportifs
- Ajustez les angles de caméra, les points focaux et l’éclairage de la scène, par exemple pour transformer le jour en nuit, avec des outils avancés d’édition localisée
- Sa compréhension spatiale supérieure permet de générer des infographies, des diagrammes techniques et des diapositives de présentation précis
- Génère jusqu’à 4 variations à la fois
Options de sortie :
- Résolutions : 1K, 2K, 4K
- Formats d’image : automatique, 21:9, 16:9, 5:4, 4:3, 3:2, 1:1, 2:3, 3:4, 4:5, 9:16
Idéal pour :
- La publicité professionnelle, les ressources de marque et la photographie de produits e-commerce haut de gamme
- Les contenus explicatifs éducatifs, les infographies fondées sur les données et la documentation technique complexe
- Le prototypage rapide de créations visuelles haute résolution avec une identité de personnage ou de marque cohérente
Coût : varie selon les paramètres sélectionnés et le nombre de variations
API : gemini-3-pro-image
Nano Banana
Un modèle à haute vitesse pour la génération et l’édition rapides d’images de haute qualité directement à partir de prompts textuels.
Fonctionnalités :
- Prend en charge plusieurs images de référence pour guider la génération
- Génère jusqu’à 4 images à la fois
Options de sortie :
- Formats d’image : 21:9, 16:9, 5:4, 4:3, 3:2, 1:1, 2:3, 3:4, 4:5, 9:16
Idéal pour :
- La création et l’itération rapides d’images
Coût : varie selon les paramètres sélectionnés et le nombre de variations
API : gemini-2.5-flash-image
Runway Gen-4 Image
Un modèle de base avancé conçu pour la génération d’images haute fidélité, offrant un contrôle stylistique inédit et une mémoire visuelle permettant de maintenir la cohérence entre les scènes.
Fonctionnalités :
- Ancrez des personnages, des styles ou des objets spécifiques à l’aide d’images d’entrée afin de maintenir une cohérence de niveau professionnel dans plusieurs résultats
- Optimisé pour interpréter des descriptions complexes en langage naturel et contrôler précisément les détails visuels, l’éclairage et les émotions
- Capable de générer des visuels de haute qualité pour des cas d’usage variés, des storyboards cinématographiques à la photographie professionnelle de produits
- Génère jusqu’à 4 images à la fois
Options de sortie :
- Formats d’image : 16:9, 4:3, 1:1, 3:4, 9:16
- Résolutions : 720p, 1080p
Idéal pour :
- Garantir que les protagonistes conservent leur apparence dans différents environnements et éclairages
- Produire rapidement des ressources de marque haute résolution, des essais virtuels et des visualisations de produits prêtes à l’échelle
- Explorer différentes directions artistiques tout en préservant l’identité visuelle centrale grâce aux images de référence
Coût : varie selon les paramètres sélectionnés et le nombre de variations
Runway Gen-4 Image Turbo
Un modèle de génération d’images optimisé pour la vitesse, qui fournit des résultats 2,5 fois plus rapidement que Gen-4 Image standard tout en maintenant une qualité de sortie identique.
Fonctionnalités :
- Un traitement optimisé permet une exploration créative rapide et génère des images haute fidélité en une fraction du temps
- Importez jusqu’à trois images de référence pour orienter la compréhension du modèle concernant des personnages, environnements et styles artistiques spécifiques
- Résout le problème de dérive visuelle en encodant les caractéristiques visuelles spécifiques des images de référence afin de préserver l’identité entre plusieurs générations
- Appliquez facilement l’esthétique, l’éclairage et la texture d’une image de référence à des sujets et scènes entièrement nouveaux
- Utilisez les paramètres de graine pour explorer systématiquement des variations ou recréer précisément des résultats spécifiques
- Génère jusqu’à 4 images à la fois
Options de sortie :
- Formats d’image : 16:9, 4:3, 1:1, 3:4, 9:16
- Résolutions : 720p, 1080p
Idéal pour :
- Produire rapidement et à grande échelle des visuels optimisés pour Instagram Stories (9:16) ou des publications standard (1:1)
- Maintenir une identité visuelle stricte entre les campagnes en utilisant les guides de style de marque comme images de référence
- Développer des poses et décors de personnages cohérents tout en garantissant que le protagoniste reste reconnaissable
- Créer avec précision des prises de vue de produits variées, de style de vie et saisonnières grâce à des références
Coût : varie selon les paramètres sélectionnés et le nombre de variations
Seedream 4
Un modèle d’image spécialisé dans la génération de séquences à plusieurs plans ou de scènes comportant d’importants mouvements et de l’action.
Fonctionnalités :
- Excelle dans la création d’images avec une physique stable et des transitions cohérentes
- Prend en charge plusieurs images de référence pour guider la génération
- Génère jusqu’à 4 images à la fois
Options de sortie :
- Formats d’image : automatique, 16:9, 4:3, 1:1, 3:4, 9:16
Idéal pour :
- Les scènes d’action et les compositions dynamiques
Coût : varie selon les paramètres sélectionnés et le nombre de variations
Seedream 4 n’est pas disponible aux États-Unis.
Wan 2.5 Image
La variante d’image de Wan 2.5, avec une grande fidélité aux prompts et la prise en charge d’images de référence.
Entrées de génération :
- Texte vers image
- Images de référence (jusqu’à 2)
Fonctionnalités :
- Contrôles des prompts négatifs et de la graine
- Création par lots avec jusqu’à 4 générations à la fois
Options de sortie :
- Formats d’image : 16:9, 4:3, 1:1, 3:4, 9:16
Idéal pour :
- Les images fixes qui correspondent au style des générations vidéo de Wan
- Les images conceptuelles fidèles aux prompts
Coût : varie selon les paramètres sélectionnés et le nombre de variations
Wan 2.5 Image n’est pas disponible aux États-Unis.
FLUX.1 Kontext [Pro]
Un modèle professionnel pour la génération et l’édition avancées d’images, offrant une forte cohérence de scène et un contrôle du style.
Fonctionnalités :
- Contrôle du style basé sur l’image, nécessitant une image de référence pour orienter l’esthétique visuelle
- Génère jusqu’à 4 images à la fois
Options de sortie :
- Formats d’image : 21:9, 16:9, 4:3, 3:2, 1:1, 2:3, 3:4, 4:5, 9:16, 9:21
Idéal pour :
- Les contenus professionnels avec des exigences stylistiques précises
Coût : varie selon les paramètres sélectionnés et le nombre de variations
Modèles de synchronisation labiale
Creatify Aurora
Un modèle de transformateur de diffusion (DiT) de pointe, conçu pour produire des avatars ultra-réalistes et réactifs, pilotés par des indications audio et textuelles.
Entrées de génération :
- Avatar (image source)
- Parole (fichier audio)
- Description textuelle (indication)
Fonctionnalités :
- Va au-delà de la synchronisation labiale de base grâce à des clignements des yeux, une respiration et des expressions faciales naturelles tenant compte du contexte
- Synchronise automatiquement les mouvements des mains et du corps entier selon le ton et l’intonation de la voix, pour une performance de qualité studio
- Interprète avec précision l’intensité et la hauteur de la voix pour produire des expressions émotionnelles fidèles à la performance
- Préserve une grande fidélité du personnage et une cohérence comportementale, même lors de dialogues ou de performances musicales prolongés
- Optimisé pour diverses configurations, notamment les présentations de profil, les dialogues de type podcast et les animations stylisées
- Générez jusqu’à 4 variations à la fois
Options de sortie :
- Résolutions : 480p, 720p
Idéal pour :
- Les publicités vidéo professionnelles basées sur des avatars et les contenus marketing
- La narration virtuelle haute fidélité et les performances musicales expressives
- Les vidéos pédagogiques ou de formation longues nécessitant une présence cohérente du personnage
Coût : varie selon l’entrée, les paramètres et la durée
API : creatify-aurora
Veed Fabric
Un modèle rapide et précis de synchronisation labiale d’image à vidéo, qui anime une image fixe pour correspondre à l’audio fourni.
Entrées :
- Image source
- Fichier audio de parole
Fonctionnalités :
- Anime la bouche et les expressions faciales de l’image source pour correspondre à l’audio fourni
- Crée des vidéos « parlantes » haute fidélité à partir d’images fixes
- Outil dédié à la synchronisation labiale, et non modèle complet de génération vidéo
Idéal pour :
- Créer des avatars parlants à partir d’images fixes
- Ajouter des dialogues à des portraits de personnages
- Les workflows de contenu professionnel piloté par avatars
Coût : varie selon l’entrée, les paramètres et la durée
Pour de meilleurs résultats, l’image doit contenir une personne détectable.
HeyGen Avatar 4
Le dernier modèle d’avatar de HeyGen, pour générer des vidéos de personnes parlant face caméra très réalistes et expressives à partir d’une seule image et d’une entrée audio.
Entrées :
- Image source
- Fichier audio de parole
Fonctionnalités :
- Anime les expressions faciales et les mouvements des lèvres pour correspondre avec une grande fidélité à l’audio fourni
- Produit des mouvements de tête naturels et des micro-expressions subtiles pour des résultats réalistes
- Outil dédié à la synchronisation labiale, et non modèle complet de génération vidéo
Idéal pour :
- Les vidéos professionnelles de porte-parole et de présentateurs
- Créer du contenu d’avatar personnalisé à grande échelle
- Les vidéos marketing et de formation nécessitant une présence cohérente du personnage
Coût : varie selon l’entrée, les paramètres et la durée
Pour de meilleurs résultats, l’image doit contenir un visage clairement visible.
Sync 3
Le modèle de synchronisation labiale vidéo de dernière génération de Sync, qui offre une synchronisation de qualité studio pour un large éventail de types de contenu.
Entrées de génération :
- Vidéo source
- Audio de parole
Fonctionnalités :
- Synchronisation labiale très précise qui préserve les détails uniques du visage, les dents naturelles et la texture de la peau
- Optimisé pour tous les types de contenu, y compris les prises de vue réelles, l’animation 3D et les vidéos générées par IA
- Outil de synchronisation labiale de vidéo à vidéo, et non générateur vidéo complet
Idéal pour :
- Le doublage et la localisation professionnels pour le cinéma et la publicité
- Améliorer ou corriger les dialogues dans tout format vidéo
- Les workflows de traduction de contenu à grand volume
Coût : varie selon l’entrée, les paramètres et la durée
Pour de meilleurs résultats, la vidéo doit contenir une personne détectable.
Sync Lipsync 2 Pro
Un modèle de montage vidéo de pointe conçu pour une synchronisation labiale de qualité studio, qui préserve les détails uniques du visage tout en permettant des sorties haute résolution.
Entrées de génération :
- Vidéo source
- Audio de parole
Fonctionnalités :
- Intègre un agrandissement avancé pour prendre en charge les sorties 4K tout en conservant des textures nettes et naturelles
- Préserve les caractéristiques faciales uniques telles que les dents naturelles, les taches de rousseur, le maquillage et les poils du visage complexes, sans perte de netteté
- Optimisé pour tous les types de contenu, y compris les prises de vue réelles, l’animation 3D et les vidéos générées par IA
- Produit immédiatement des résultats expressifs et synchronisés, sans entraînement spécifique au locuteur ni ajustement du modèle
- Générez jusqu’à 4 variations simultanément
Idéal pour :
- Le doublage de qualité professionnelle et les contenus localisés pour le cinéma et la publicité haut de gamme
- Améliorer ou corriger les dialogues de personnages animés en 3D et générés par IA
- Les projets haute résolution exigeant une cohérence et des détails du visage parfaits au pixel près
Coût : varie selon l’entrée, les paramètres et la durée
OmniHuman 1.5
Un modèle utilitaire dédié permettant de générer une synchronisation labiale exceptionnellement réaliste et humaine.
Entrées :
- Image source statique
- Fichier audio de parole
Fonctionnalités :
- Anime la bouche de l’image source pour correspondre à l’audio fourni
- Crée des vidéos « parlantes » haute fidélité à partir d’images fixes
- Outil dédié à la synchronisation labiale, et non modèle complet de génération vidéo
Idéal pour :
- Créer des avatars parlants
- Ajouter des dialogues à des images fixes
- Les workflows de doublage professionnel
Coût : varie selon l’entrée, les paramètres et la durée
Pour de meilleurs résultats, l’image doit contenir une personne détectable.
OmniHuman 1.5 n’est pas disponible aux États-Unis.
Veed Lipsync
Un modèle utilitaire rapide, abordable et précis pour appliquer une synchronisation labiale réaliste aux vidéos.
Entrées :
- Vidéo source
- Nouveau fichier audio de parole
Fonctionnalités :
- Réanime les mouvements de la bouche dans la vidéo source pour correspondre au nouvel audio
- Outil de synchronisation labiale de vidéo à vidéo, et non générateur vidéo complet
Idéal pour :
- Le doublage rentable à grand volume
- La traduction de contenu
- Corriger l’audio de clips vidéo avec des résultats réalistes
Coût : varie selon l’entrée, les paramètres et la durée
Pour de meilleurs résultats, la vidéo doit contenir une personne détectable.
Veed Lipsync 2.0
Le successeur de meilleure qualité de Veed Lipsync pour appliquer une synchronisation labiale réaliste à des vidéos existantes.
Entrées :
- Vidéo source
- Nouveau fichier audio de parole
Fonctionnalités :
- Réanime les mouvements de la bouche dans la vidéo source pour correspondre au nouvel audio
- Outil de synchronisation labiale de vidéo à vidéo, et non générateur vidéo complet
- Création par lots avec jusqu’à 4 générations à la fois
Idéal pour :
- Le doublage et la traduction lorsque la qualité de sortie compte davantage que le coût
- Corriger les dialogues dans des clips finalisés
Coût : varie selon l’entrée, les paramètres et la durée
Pour de meilleurs résultats, la vidéo doit contenir une personne détectable.
Modèles utilitaires
Topaz Upscale
Un modèle utilitaire dédié à l’agrandissement d’images et de vidéos, conçu pour améliorer la résolution et les détails jusqu’à 4 fois.
Fonctionnalités :
- Outil d’amélioration qui traite des médias existants
- Augmente la taille des médias tout en préservant les textures naturelles et en minimisant les artefacts
- Facteurs d’agrandissement très précis : 1x, 1.25x, 1.5x, 1.75x, 2x, 3x, 4x
- Spécifique aux vidéos : contrôle flexible de la fréquence d’images (conserver la source ou convertir en 24, 25, 30, 48, 50 ou 60 ips)
Idéal pour :
- Améliorer la qualité des médias générés
- Restaurer des séquences ou photos anciennes
- Préparer des ressources pour des écrans haute résolution
Coût : varie selon l’entrée
Suppression de l'arrière-plan
Supprime l’arrière-plan d’une image et la renvoie avec une transparence alpha.
Entrées :
- Image source
Fonctionnalités :
- Aucune instruction requise
- Une seule sortie par exécution
Idéal pour :
- Les détourages de produits et le compositing
- Préparer des sujets à utiliser comme références dans d’autres générations
Coût : varie selon l’entrée
Runway Ruby
Convertit une vidéo à plage dynamique standard en HDR.
Entrées :
- Vidéo source (jusqu’à 30 s)
Fonctionnalités :
- Aucune instruction requise
- Une seule sortie par exécution, la durée et le cadrage suivent la source
Idéal pour :
- Préparer des séquences pour des écrans HDR
- Réétalonner des vidéos générées pour leur livraison
Coût : varie selon la durée de la vidéo