> This is a page from the ElevenLabs documentation. For a complete page index, fetch https://elevenlabs.io/docs/llms.txt. For the full documentation in a single file, fetch https://elevenlabs.io/docs/llms-full.txt.
# Garde-fous
## Vue d’ensemble
Les garde-fous permettent aux équipes de régir efficacement le comportement des agents en production, afin qu’ils restent dans le sujet, conformes à votre marque et résistants aux manipulations à l’échelle de l’entreprise.
Avec Guardrails 2.0, nous avons repensé la couche de sécurité pour permettre aux équipes de définir plus facilement des politiques personnalisées en langage naturel, d’activer des protections préconfigurées, de contrôler ce qui se passe lorsqu’un garde-fou se déclenche et de déployer des agents en toute confiance dans des workflows à fort impact.
Les garde-fous orientent les agents vers les bonnes réponses et bloquent les mauvaises avant qu’elles n’atteignent l’utilisateur. Ils protègent les conversations à plusieurs niveaux : ils façonnent la manière dont l’agent répond, valident les entrées de l’utilisateur et évaluent indépendamment chaque réponse sans ajouter de latence. Ensemble, ils réduisent les risques pour votre marque et votre conformité dans chaque conversation.
## Fonctionnement des garde-fous
Les garde-fous protègent les conversations à trois niveaux :
**Renforcement du prompt système :** le principal moyen de contrôler le comportement de l’agent. Ajoutez au prompt système des instructions explicites sur les comportements autorisés et interdits, puis activez le Focus Guardrail pour renforcer ces instructions tout au long de la conversation. C’est ce qui permet à votre agent de rester sur la bonne voie dans la grande majorité des interactions.
**Validation des entrées utilisateur :** un filet de sécurité qui détecte les tentatives malveillantes avant même que l’agent ne réponde. Les garde-fous analysent les propos de l’utilisateur, détectent les tentatives d’injection de prompt et de manipulation, et peuvent mettre fin aux conversations qui présentent un risque de sécurité.
**Validation des réponses de l’agent :** une vérification finale qui évalue indépendamment et en temps réel chaque réponse de l’agent au regard de vos politiques configurées. Si l’agent est sur le point de dire quelque chose qui enfreint vos règles malgré son prompt système, les validateurs de réponse le bloquent avant sa diffusion.
Le renforcement du prompt système est la base. La validation des entrées et des réponses permet de corriger ce qui passe entre les mailles du filet. Pour vos règles les plus critiques, incluez-les à la fois dans votre prompt système et sous la forme d’un Guardrail personnalisé indépendant. Vous créez ainsi une défense en profondeur : même si le LLM s’écarte de ses instructions, le validateur de réponse le détecte avant la diffusion.
| Garde-fou | Fonction | Protection | Impact sur la latence | Coût | Stratégie de sortie | Statut de publication |
| ------------ | ---------------------------------------------------------------------- | ---------------------------------- | --------------------------------------------- | ------------- | ------------------------- | ---------------------- |
| Focus | Maintient les agents dans le sujet et alignés sur votre prompt système | Renforcement du prompt système | Minimal | Inclus | S. O. | Disponibilité générale |
| Manipulation | Détecte et bloque les injections de prompt | Validation des entrées utilisateur | Aucun effet | Inclus | Met fin à la conversation | Disponibilité générale |
| Contenu | Signale et empêche les contenus inappropriés | Validation des réponses de l’agent | [Dépend du mode d’exécution](#execution-mode) | Inclus | Configurable | Alpha |
| Personnalisé | Applique vos politiques propres à votre activité | Validation des réponses de l’agent | [Dépend du mode d’exécution](#execution-mode) | Selon l’usage | Configurable | Alpha |
## Renforcement du prompt système
Le moyen le plus efficace d’obtenir le comportement attendu de votre agent consiste à rédiger un excellent prompt système et à activer le Focus Guardrail. Ensemble, ils orientent les agents vers les bonnes réponses dès le départ.
Vous pouvez utiliser le prompt système pour fournir des instructions explicites sur ce que votre agent doit et ne doit pas faire. Les modèles sont entraînés à accorder une attention particulière à l’en-tête `# Guardrails`. Utilisez cet en-tête pour vos règles comportementales les plus critiques.
**`Exemple : renforcement du prompt système`**
```mdx title="Exemple : renforcement du prompt système"
# Guardrails
- Only provide information that is publicly documented about ElevenLabs products, pricing, and features.
- Do not speculate about unreleased features, internal roadmaps, or future pricing changes.
- If you cannot resolve an issue with available documentation or tools, clearly explain the limitation and offer to escalate to a human support representative.
```
Pour des conseils complets sur la rédaction de prompts système efficaces, consultez notre [guide de prompting](/docs/fr/eleven-agents/best-practices/prompting-guide). L’équipe en charge de votre compte ElevenLabs peut également vous aider à élaborer des prompts système de haute qualité.
**Focus Guardrail :** le Focus Guardrail renforce le prompt système de votre agent et aide les réponses à rester ciblées, pertinentes et cohérentes avec les objectifs et instructions que vous avez définis. Il est particulièrement utile lors de conversations longues ou complexes, où l’agent est davantage susceptible de s’écarter de ses objectifs prévus.
La combinaison du renforcement du prompt système et de l’activation du Focus Guardrail est le moyen le plus efficace d’orienter les agents vers les bonnes réponses.
## Validation des entrées utilisateur
### Garde-fous contre la manipulation
Détectent et bloquent les tentatives des utilisateurs visant à amener l’agent à contourner ses instructions. Lorsqu’ils sont activés, le système analyse les entrées utilisateur pour repérer les schémas indiquant des tentatives d’injection ou de remplacement d’instructions, et peut mettre fin aux conversations présentant un risque de sécurité.
## Validation des réponses de l’agent
### Garde-fous de contenu
Signalent et empêchent les contenus inappropriés dans les réponses de l’agent, tels que les contenus politiquement sensibles, sexuellement explicites ou violents, avant qu’ils n’atteignent l’utilisateur. Cela permet de garantir que les réponses sont adaptées au cas d’utilisation et au public visés pour votre agent.
### Garde-fous personnalisés
À mesure que les agents prennent en charge des tâches à fort impact, les équipes ont besoin d’un contrôle clair sur leur comportement. Les Guardrails personnalisés vous permettent de configurer les politiques les plus importantes pour votre activité. Par exemple :
* Un assistant de vente au détail ne doit pas émettre de remboursements pour des articles non éligibles.
* Un réceptionniste dans le secteur de la santé ne doit pas donner de conseils médicaux.
* Un agent bancaire ne doit pas recommander d’investissements.
Les Guardrails personnalisés sont des règles basées sur des LLM qui vous permettent de définir vos propres critères de blocage à l’aide de prompts en langage naturel. Chaque Guardrail personnalisé activé envoie les réponses de l’agent à un modèle léger, qui les évalue selon votre règle et renvoie une décision d’autorisation ou de blocage. Vous disposez ainsi d’un contrôle flexible et spécifique à votre domaine sur ce que votre agent peut ou ne peut pas dire.
Pour chaque garde-fou personnalisé, vous pouvez définir :
| Champ | Description |
| ------------------------------------------------- | ------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------- |
| **Nom** | Un libellé descriptif pour le garde-fou, par exemple « Aucun conseil financier ». |
| **Prompt** | Une instruction en langage naturel décrivant ce qui doit être bloqué, par exemple « Bloquez tout contenu fournissant des conseils financiers spécifiques, des recommandations d’investissement ou des conseils fiscaux. » |
| **Mode d’exécution** | `streaming` (par défaut) ou `blocking`. Consultez [Mode d’exécution](#execution-mode). |
| **Action de déclenchement (stratégie de sortie)** | `end_call` (par défaut) ou `retry`. Consultez [Stratégies de sortie](#exit-strategies). |
Les Guardrails personnalisés peuvent servir à bloquer des sujets spécifiques à votre activité, à appliquer des exigences de conformité propres à votre secteur et à mettre en œuvre des mesures de sécurité propriétaires. Chacun peut être activé ou désactivé individuellement sans être supprimé et, lorsque plusieurs sont activés, ils s’exécutent en parallèle avec les autres Guardrails. Toutes les violations déclenchées sont consignées pour examen.
## Mode d’exécution
Le mode d’exécution détermine si les garde-fous ajoutent un temps d’attente avant que l’utilisateur voie ou entende une réponse.
En mode **streaming**, la réponse de l’agent peut commencer avant le déclenchement du garde-fou. Pour la voix, une petite partie de l’audio, souvent moins de 500 ms, peut être diffusée avant qu’un blocage ne mette fin à l’appel. Pour les agents textuels, les utilisateurs peuvent voir une réponse partielle ou complète si l’évaluation ne se termine pas avant sa diffusion.
En mode **blocking**, l’agent ne répond qu’après validation des garde-fous. Cela ajoute généralement **200 à 500 ms** de latence supplémentaire.
## Stratégies de sortie
Les stratégies de sortie vous permettent de définir ce que fait votre agent lorsqu’un garde-fou se déclenche. Vous pouvez choisir parmi les options suivantes :
* **`end_call`** *(par défaut)* : met immédiatement fin à l’appel
* **`retry`** : régénère la réponse à l’aide de vos retours au lieu d’interrompre la conversation. La réponse de l’agent est réessayée jusqu’à trois fois et, si chaque tentative enfreint encore le garde-fou, l’appel prend fin.
> **Warning**
>
> La nouvelle tentative fonctionne uniquement en mode blocking. En mode streaming, mettre fin à l’appel est la seule stratégie de sortie disponible.
#### Retour pour nouvelle tentative
Le retour **retry** peut contenir **toutes les instructions** que vous souhaitez appliquer au prochain tour. Il est injecté comme instruction système avant que le modèle ne régénère sa réponse. Cela inclut l’appel d’outils système comme `transfer_to_agent` ou `transfer_to_number`. Voici quelques exemples de configuration du retour pour nouvelle tentative :
* **Refus générique** (par défaut) \
*Votre réponse a été bloquée par un garde-fou qui bloque les contenus correspondant à cette condition/catégorie : '\{\{trigger_reason}}'. Lors de votre prochain tour, vous devez dire à l’utilisateur « Je suis désolé, mais je ne peux pas répondre à cette question. Souhaitez-vous savoir autre chose ? »*
* **Nouvelle tentative avec instructions correctives**\
*Votre réponse précédente a été bloquée par un garde-fou. Votre réponse bloquée était : '\{\{agent_message}}'. Lors de votre prochain tour, vous devez fournir une nouvelle réponse qui ne doit pas enfreindre : '\{\{trigger_reason}}'.*
* **Transfert vers un autre agent**\
*Votre réponse précédente a été bloquée par le garde-fou. Lors de votre prochain tour, vous devez utiliser l’outil transfer_to_agent et effectuer le transfert vers un agent. Votre réponse bloquée était : '\{\{agent_message}}'. Le garde-fou bloque les contenus correspondant à cette condition/catégorie : '\{\{trigger_reason}}'.*
* **Transfert vers une personne**\
*Votre réponse a été bloquée par un garde-fou qui bloque les contenus correspondant à cette condition/catégorie : '\{\{trigger_reason}}'. Lors de votre prochain tour, vous DEVEZ transférer l’appel vers un opérateur humain à l’aide de l’outil transfer_to_number.*
> **Tip**
>
> Pour utiliser des **outils système** dans le retour de nouvelle tentative, activez et configurez les outils correspondants dans les paramètres de l’agent. Seuls les outils configurés sur l’agent peuvent être appelés.
Vous pouvez utiliser les espaces réservés suivants dans le texte de retour :
| Espace réservé | Remplacé par |
| -------------------- | ------------------------------------------------------------------------------------------------------------------------------------------------------------------- |
| `{{trigger_reason}}` | Le **prompt** du garde-fou lorsqu’il est défini dans les garde-fous personnalisés. La **catégorie** déclenchée lorsqu’il est défini dans les garde-fous de contenu. |
| `{{agent_message}}` | La sortie de l’agent qui a été bloquée, utile pour orienter la nouvelle tentative. |
> **Tip**
>
> Le mode d’exécution **streaming** est recommandé pour les agents **vocaux** ; le mode d’exécution **blocking** est recommandé pour les agents **textuels**.
> **Warning**
>
> Le mode **blocking**, en particulier avec **retry**, peut se comporter de façon moins prévisible avec la voix. Si vous utilisez le mode blocking pour la voix, validez soigneusement son fonctionnement ou choisissez **end call** plutôt que **retry** jusqu’à ce que vous ayez confiance dans son comportement.
## Tarification
Les garde-fous **Focus**, **Manipulation** et **Contenu** sont inclus **sans frais supplémentaires** pour tous les utilisateurs d’ElevenAgents.
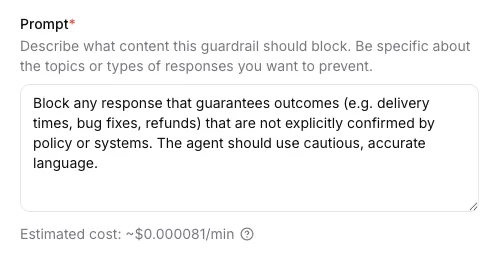
Les **Guardrails personnalisés** sont facturés selon l’usage et **entraînent des coûts LLM supplémentaires**, comme les autres appels de modèle dans ElevenAgents. Chaque Guardrail personnalisé activé envoie chaque réponse de l’agent à un modèle léger à des fins d’évaluation. Le coût dépend donc de la longueur du prompt, de la longueur moyenne des conversations et du volume de conversations. Si vous activez plusieurs Guardrails personnalisés, chacun exécute sa propre évaluation pour chaque réponse. Nous vous recommandons d’examiner le trafic prévu et le choix du modèle avant d’activer plusieurs Guardrails personnalisés en production.
Vous pouvez voir une estimation du coût, sous le prompt, lorsque vous créez ou modifiez un garde-fou personnalisé.
> **Note**
>
> **Nouvelle tentative et coût :** chaque tentative correspond à une génération supplémentaire de l’agent, ainsi qu’à une nouvelle évaluation par le garde-fou. **retry** augmente donc la facturation selon l’usage par rapport à **end_call**, avec jusqu’à trois tentatives par tour bloqué.
## Configuration
#### Configuration via le Dashboard
#### Accéder aux paramètres de l’agent
Ouvrez votre agent dans le Dashboard ElevenLabs et accédez à l’onglet **Sécurité**.
#### Activer les garde-fous
Activez les catégories de garde-fous souhaitées. Les boutons prédéfinis vous permettent d’activer rapidement
toutes les catégories ou de toutes les désactiver.
#### Configurer le mode d’exécution et la stratégie de sortie (garde-fous personnalisés et de contenu)
Pour chaque garde-fou personnalisé ou de contenu, choisissez le mode d’exécution **streaming** ou **blocking**.
Le mode **blocking** convient aux agents **textuels** ; le mode **streaming** convient aux agents **vocaux**. Définissez l’**action en cas de
violation d’un garde-fou** (correspond à **`trigger_action`**) : **end call** dans tous les modes, ou **retry**
uniquement lorsque **blocking** est sélectionné (**retry** n’est pas disponible en mode **streaming**). Si vous choisissez
**retry**, modifiez le **feedback à injecter lors d’une nouvelle tentative** afin d’orienter le modèle. Utilisez les espaces réservés