> This is a page from the ElevenLabs documentation. For a complete page index, fetch https://elevenlabs.io/docs/llms.txt. For the full documentation in a single file, fetch https://elevenlabs.io/docs/llms-full.txt.
# Medidas de protección
## Descripción general
Las medidas de protección ofrecen a los equipos una forma eficaz de gobernar cómo se comportan los agentes en producción, manteniéndolos centrados en el tema, alineados con la marca y resistentes a la manipulación a escala empresarial.
Con Guardrails 2.0, hemos rediseñado la capa de seguridad para que a los equipos les resulte más fácil definir políticas personalizadas en lenguaje natural, activar protecciones predefinidas, controlar qué sucede cuando se activa una medida de protección y desplegar agentes con confianza en workflows de gran impacto.
Las medidas de protección guían a los agentes hacia las respuestas adecuadas y detienen las incorrectas antes de que lleguen al usuario. Protegen las conversaciones en varias capas: dan forma a cómo responde el agente, validan la entrada del usuario y evalúan de forma independiente cada respuesta sin añadir latencia. En conjunto, reducen el riesgo para la marca y el cumplimiento normativo en cada conversación.
## Cómo funcionan las medidas de protección
Las medidas de protección protegen las conversaciones en tres niveles:
**Refuerzo del prompt de sistema:** La forma principal de controlar el comportamiento del agente. Añades instrucciones explícitas en el prompt de sistema sobre los comportamientos permitidos y no permitidos, y activas la medida de protección Focus para reforzar esas instrucciones durante toda la conversación. Esto mantiene a tu agente en el camino correcto en la gran mayoría de las interacciones.
**Validación de la entrada del usuario:** Una red de seguridad que detecta intentos adversarios antes de que el agente llegue a responder. Las medidas de protección analizan lo que dice el usuario, detectan intentos de inyección de prompts y manipulación, y pueden finalizar conversaciones que supongan un riesgo de seguridad.
**Validación de respuestas del agente:** Una comprobación final que evalúa de forma independiente cada respuesta del agente en tiempo real según tus políticas configuradas. Si el agente está a punto de decir algo que infringe tus reglas pese a su prompt de sistema, los validadores de respuesta lo bloquean antes de enviarlo.
El refuerzo del prompt de sistema es la base. La validación de entradas y respuestas aporta correcciones para cualquier cosa que se escape. Para tus reglas más importantes, inclúyelas tanto en el prompt de sistema como en una medida de protección personalizada independiente; así crearás una defensa en profundidad, de modo que, incluso si el LLM se desvía de sus instrucciones, el validador de respuestas lo detectará antes de enviarlo.
| Medida de protección | Qué hace | Protección | Impacto en la latencia | Coste | Estrategia de salida | Estado de lanzamiento |
| -------------------- | -------------------------------------------------------------------------------- | ------------------------------------ | ------------------------------------------------ | --------- | ------------------------ | ---------------------- |
| Focus | Mantiene a los agentes centrados en el tema y alineados con tu prompt de sistema | Refuerzo del prompt de sistema | Mínimo | Incluido | N/A | Disponibilidad general |
| Manipulation | Detecta y bloquea la inyección de prompts | Validación de la entrada del usuario | Sin efecto | Incluido | Finaliza la conversación | Disponibilidad general |
| Content | Marca y evita contenido inapropiado | Validación de respuestas del agente | [Depende del modo de ejecución](#execution-mode) | Incluido | Configurable | Alfa |
| Custom | Aplica tus políticas específicas de negocio | Validación de respuestas del agente | [Depende del modo de ejecución](#execution-mode) | Según uso | Configurable | Alfa |
## Refuerzo del prompt de sistema
La forma más eficaz de conseguir que tu agente se comporte como esperas es redactar un buen prompt de sistema y activar la medida de protección Focus. Juntos, guían a los agentes hacia las respuestas adecuadas desde el principio.
Puedes usar el prompt de sistema para proporcionar instrucciones explícitas sobre lo que tu agente debe y no debe hacer. Los modelos están ajustados para prestar especial atención al encabezado `# Guardrails`. Usa este encabezado para tus reglas de comportamiento más importantes.
**`Ejemplo: refuerzo del prompt de sistema`**
```mdx title="Ejemplo: refuerzo del prompt de sistema"
# Guardrails
- Only provide information that is publicly documented about ElevenLabs products, pricing, and features.
- Do not speculate about unreleased features, internal roadmaps, or future pricing changes.
- If you cannot resolve an issue with available documentation or tools, clearly explain the limitation and offer to escalate to a human support representative.
```
Para obtener una guía completa sobre cómo redactar prompts de sistema eficaces, consulta nuestra [guía de prompting](/docs/es/eleven-agents/best-practices/prompting-guide). El equipo de ElevenLabs asignado a tu cuenta también puede ayudarte a crear prompts de sistema de alta calidad.
**Medida de protección Focus:** La medida de protección Focus refuerza el prompt de sistema de tu agente y ayuda a mantener las respuestas dirigidas, pertinentes y coherentes con tus objetivos e instrucciones definidos. Resulta especialmente útil en conversaciones largas o complejas, donde es más probable que el agente se desvíe de sus objetivos previstos.
La combinación del refuerzo del prompt de sistema y la activación de la medida de protección Focus es la forma más eficaz de guiar a los agentes hacia las respuestas adecuadas.
## Validación de la entrada del usuario
### Medidas de protección contra la manipulación
Detecta y bloquea intentos de usuarios de manipular al agente para que ignore sus instrucciones. Cuando está activada, el sistema analiza las entradas del usuario en busca de patrones que indiquen intentos de inyección o de anulación de instrucciones, y puede finalizar conversaciones que supongan un riesgo de seguridad.
## Validación de respuestas del agente
### Medidas de protección de contenido
Marca y evita contenido inapropiado en las respuestas del agente, como material políticamente sensible, sexualmente explícito o violento, antes de que llegue al usuario. Esto ayuda a mantener las respuestas adecuadas para el caso de uso y la audiencia previstos de tu agente.
### Medidas de protección personalizadas
A medida que los agentes asumen tareas de gran impacto, los equipos necesitan un control claro sobre cómo se comportan. Las medidas de protección personalizadas te permiten configurar las políticas más importantes para tu negocio. Por ejemplo:
* Un asistente de comercio minorista no debe emitir reembolsos por artículos que no cumplan los requisitos.
* Un recepcionista de atención sanitaria no debe dar consejos médicos.
* Un agente bancario no debe recomendar inversiones.
Las medidas de protección personalizadas son reglas basadas en LLM que te permiten definir tus propios criterios de bloqueo mediante prompts en lenguaje natural. Cada medida de protección personalizada activada envía las respuestas del agente a un modelo ligero, que las evalúa según tu regla y devuelve una decisión de bloqueo o aprobación. Esto te proporciona un control flexible y específico de tu dominio sobre lo que tu agente puede y no puede decir.
Para cada medida de protección personalizada puedes definir:
| Campo | Descripción |
| ---------------------------------------------- | ---------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------- |
| **Nombre** | Una etiqueta descriptiva para la medida de protección (p. ej., "Sin consejos financieros"). |
| **Prompt** | Una instrucción en lenguaje natural que describe qué bloquear (p. ej., "Bloquea cualquier contenido que proporcione consejos financieros específicos, recomendaciones de inversión u orientación fiscal"). |
| **Modo de ejecución** | `streaming` (predeterminado) o `blocking`. Consulta [Modo de ejecución](#execution-mode). |
| **Acción al activarse (estrategia de salida)** | `end_call` (predeterminado) o `retry`. Consulta [Estrategias de salida](#exit-strategies). |
Las medidas de protección personalizadas pueden utilizarse para bloquear temas específicos relevantes para tu negocio, aplicar requisitos de cumplimiento normativo propios del sector e implementar medidas de seguridad propias. Puedes activar o desactivar cada una individualmente sin eliminarla y, cuando hay varias activadas, se ejecutan en paralelo con otras medidas de protección. Todas las infracciones activadas se registran para su revisión.
## Modo de ejecución
El modo de ejecución determina si las medidas de protección añaden tiempo de espera antes de que el usuario vea o escuche una respuesta.
En modo **streaming**, la respuesta del agente puede comenzar antes de que se active la medida de protección; en voz, se puede enviar una pequeña parte del audio (a menudo menos de 500 ms) antes de que un bloqueo finalice la llamada. En los agentes de texto, los usuarios pueden ver respuestas parciales o completas si la evaluación no termina antes del envío.
En modo **blocking**, el agente solo responde después de validar las medidas de protección. Esto suele añadir entre **200 y 500 ms** de latencia adicional.
## Estrategias de salida
Las estrategias de salida te permiten definir qué hace tu agente cuando se activa una medida de protección. Puedes elegir entre:
* **`end_call`** *(predeterminado)*: finaliza la llamada inmediatamente
* **`retry`**: regenera la respuesta usando tus comentarios en lugar de interrumpir la conversación. La respuesta del agente se vuelve a intentar hasta tres veces y, si todos los intentos siguen infringiendo la medida de protección, la llamada finaliza.
> **Warning**
>
> El reintento solo funciona en modo de bloqueo. En modo streaming, finalizar la llamada es la única estrategia
> de salida disponible.
#### Comentarios para reintentos
Los comentarios de **retry** pueden contener **cualquier instrucción** que quieras aplicar en el siguiente turno; se introducen como guía del sistema antes de que el modelo regenere la respuesta. Esto incluye invocar herramientas de sistema como `transfer_to_agent` o `transfer_to_number`. Estos son algunos ejemplos de cómo puedes configurar los comentarios para reintentos:
* **Rechazo genérico** (predeterminado) \
*Tu respuesta ha sido bloqueada por una medida de protección que bloquea contenido que coincide con esta condición/categoría: '\{\{trigger_reason}}'. En tu siguiente turno debes decir al usuario "Lo siento, pero no puedo responder a esa pregunta. ¿Quieres saber otra cosa?"*
* **Reintento con instrucciones correctivas**\
*Tu respuesta anterior ha sido bloqueada por una medida de protección. Tu respuesta bloqueada fue: '\{\{agent_message}}'. En tu siguiente turno debes proporcionar una nueva respuesta que no infrinja: '\{\{trigger_reason}}'*
* **Transferir a otro agente**\
*Tu respuesta anterior ha sido bloqueada por la medida de protección. En tu siguiente turno debes usar la herramienta transfer_to_agent y transferir a un agente. Tu respuesta bloqueada fue: '\{\{agent_message}}'. La medida de protección bloquea contenido que coincide con esta condición/categoría: '\{\{trigger_reason}}'.*
* **Transferir a una persona**\
*Tu respuesta ha sido bloqueada por una medida de protección que bloquea contenido que coincide con esta condición/categoría: '\{\{trigger_reason}}'. En tu siguiente turno DEBES transferir la llamada a un operador humano mediante la herramienta transfer_to_number.*
> **Tip**
>
> Para usar **herramientas de sistema** en los comentarios para reintentos, activa y configura las herramientas
> correspondientes en los ajustes del agente. Solo se pueden invocar las herramientas configuradas en el agente.
Puedes usar estos marcadores de posición en el texto de los comentarios:
| Marcador de posición | Se sustituye por |
| -------------------- | ----------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------- |
| `{{trigger_reason}}` | El **prompt** de la medida de protección cuando se define en medidas de protección personalizadas. La **categoría** que se activó cuando se define en medidas de protección de contenido. |
| `{{agent_message}}` | La salida del agente que se bloqueó (útil para orientar el reintento). |
> **Tip**
>
> Se recomienda el modo de ejecución **streaming** para agentes de **voz**; se recomienda el modo de ejecución **blocking** para agentes de **texto**.
> **Warning**
>
> El modo **blocking** (especialmente con **retry**) puede comportarse de forma menos predecible en voz. Si usas bloqueo
> en voz, valídalo exhaustivamente o elige **end call** en lugar de **retry** hasta que tengas confianza
> en el comportamiento.
## Precios
Las medidas de protección **Focus**, **Manipulation** y **Content** están incluidas **sin coste adicional** para todos los usuarios de ElevenAgents.
Las **medidas de protección personalizadas** se cobran según el uso y **generan costes adicionales de LLM**, al igual que otras llamadas a modelos en ElevenAgents. Cada medida de protección personalizada activada envía cada respuesta del agente a un modelo ligero para su evaluación, por lo que el coste depende de la longitud del prompt, la duración media de la conversación y el volumen de conversaciones. Si activas varias medidas de protección personalizadas, cada una ejecuta su propia evaluación por respuesta. Te recomendamos revisar el tráfico previsto y el modelo elegido antes de activar varias medidas de protección personalizadas en producción.
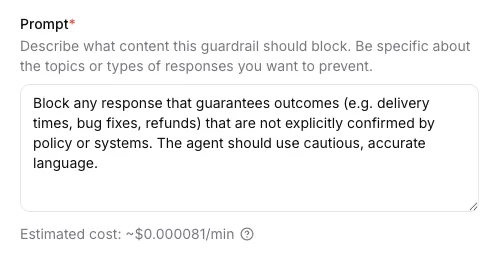
Puedes ver un coste estimado (debajo del prompt) al crear o editar una medida de protección personalizada.
> **Note**
>
> **Reintento y coste:** Cada intento supone una generación adicional del agente y otra evaluación de la medida de protección,
> por lo que **retry** aumenta la facturación según uso en comparación con **end_call** (hasta tres intentos por
> turno bloqueado).
## Configuración
#### Configurar desde el panel de control
#### Ve a los ajustes del agente
Abre tu agente en el panel de control de ElevenLabs y ve a la pestaña **Seguridad**.
#### Activa las medidas de protección
Activa las categorías de medidas de protección que quieras habilitar. Puedes usar los botones predefinidos para activar rápidamente
todas las categorías o desactivarlas todas.
#### Configura el modo de ejecución y la estrategia de salida (medidas de protección personalizadas y de contenido)
Para cada medida de protección personalizada o de contenido, elige el modo de ejecución **streaming** o **blocking**.
**Blocking** es adecuado para agentes de **texto**; **streaming** es adecuado para agentes de **voz**. Configura **Acción ante
infracción de medida de protección** (asignada a **`trigger_action`**): **finalizar llamada** en cualquier modo, o **reintentar**
solo cuando se seleccione **blocking** (**retry** no está disponible en **streaming**). Si eliges
**retry**, edita **Comentarios que se insertarán al reintentar** para orientar el modelo. Usa los marcadores de posición