

Stimmenverzerrer
Überblick
Der Stimmenverzerrer (früher Speech-to-Speech) ermöglicht es Ihnen, eine Stimme (Quellstimme) in eine andere (geklonte Stimme) umzuwandeln und dabei Tonfall und Sprechweise der Originalstimme zu erhalten.
Der Stimmenverzerrer ergänzt Text to Speech (TTS), indem er Aussprachefehler korrigiert oder die gewünschte besondere Performance verleiht. Er ist besonders nützlich, um subtile, charakteristische Stimmeigenschaften nachzuahmen, die natürlicher und emotionaler wirken. Zu den wichtigsten Funktionen gehören:
- Höhere Genauigkeit bei Flüstern
- Hörbare Seufzer, Lachen oder Weinen erzeugen
- Deutlich verbesserte Erkennung von Tonfall und Emotionen
- Folgt dem Sprechrhythmus der Eingabe präzise
- Beibehaltung von Sprache und Akzent
Video zum Stimmenverzerrer ansehen
Anleitung
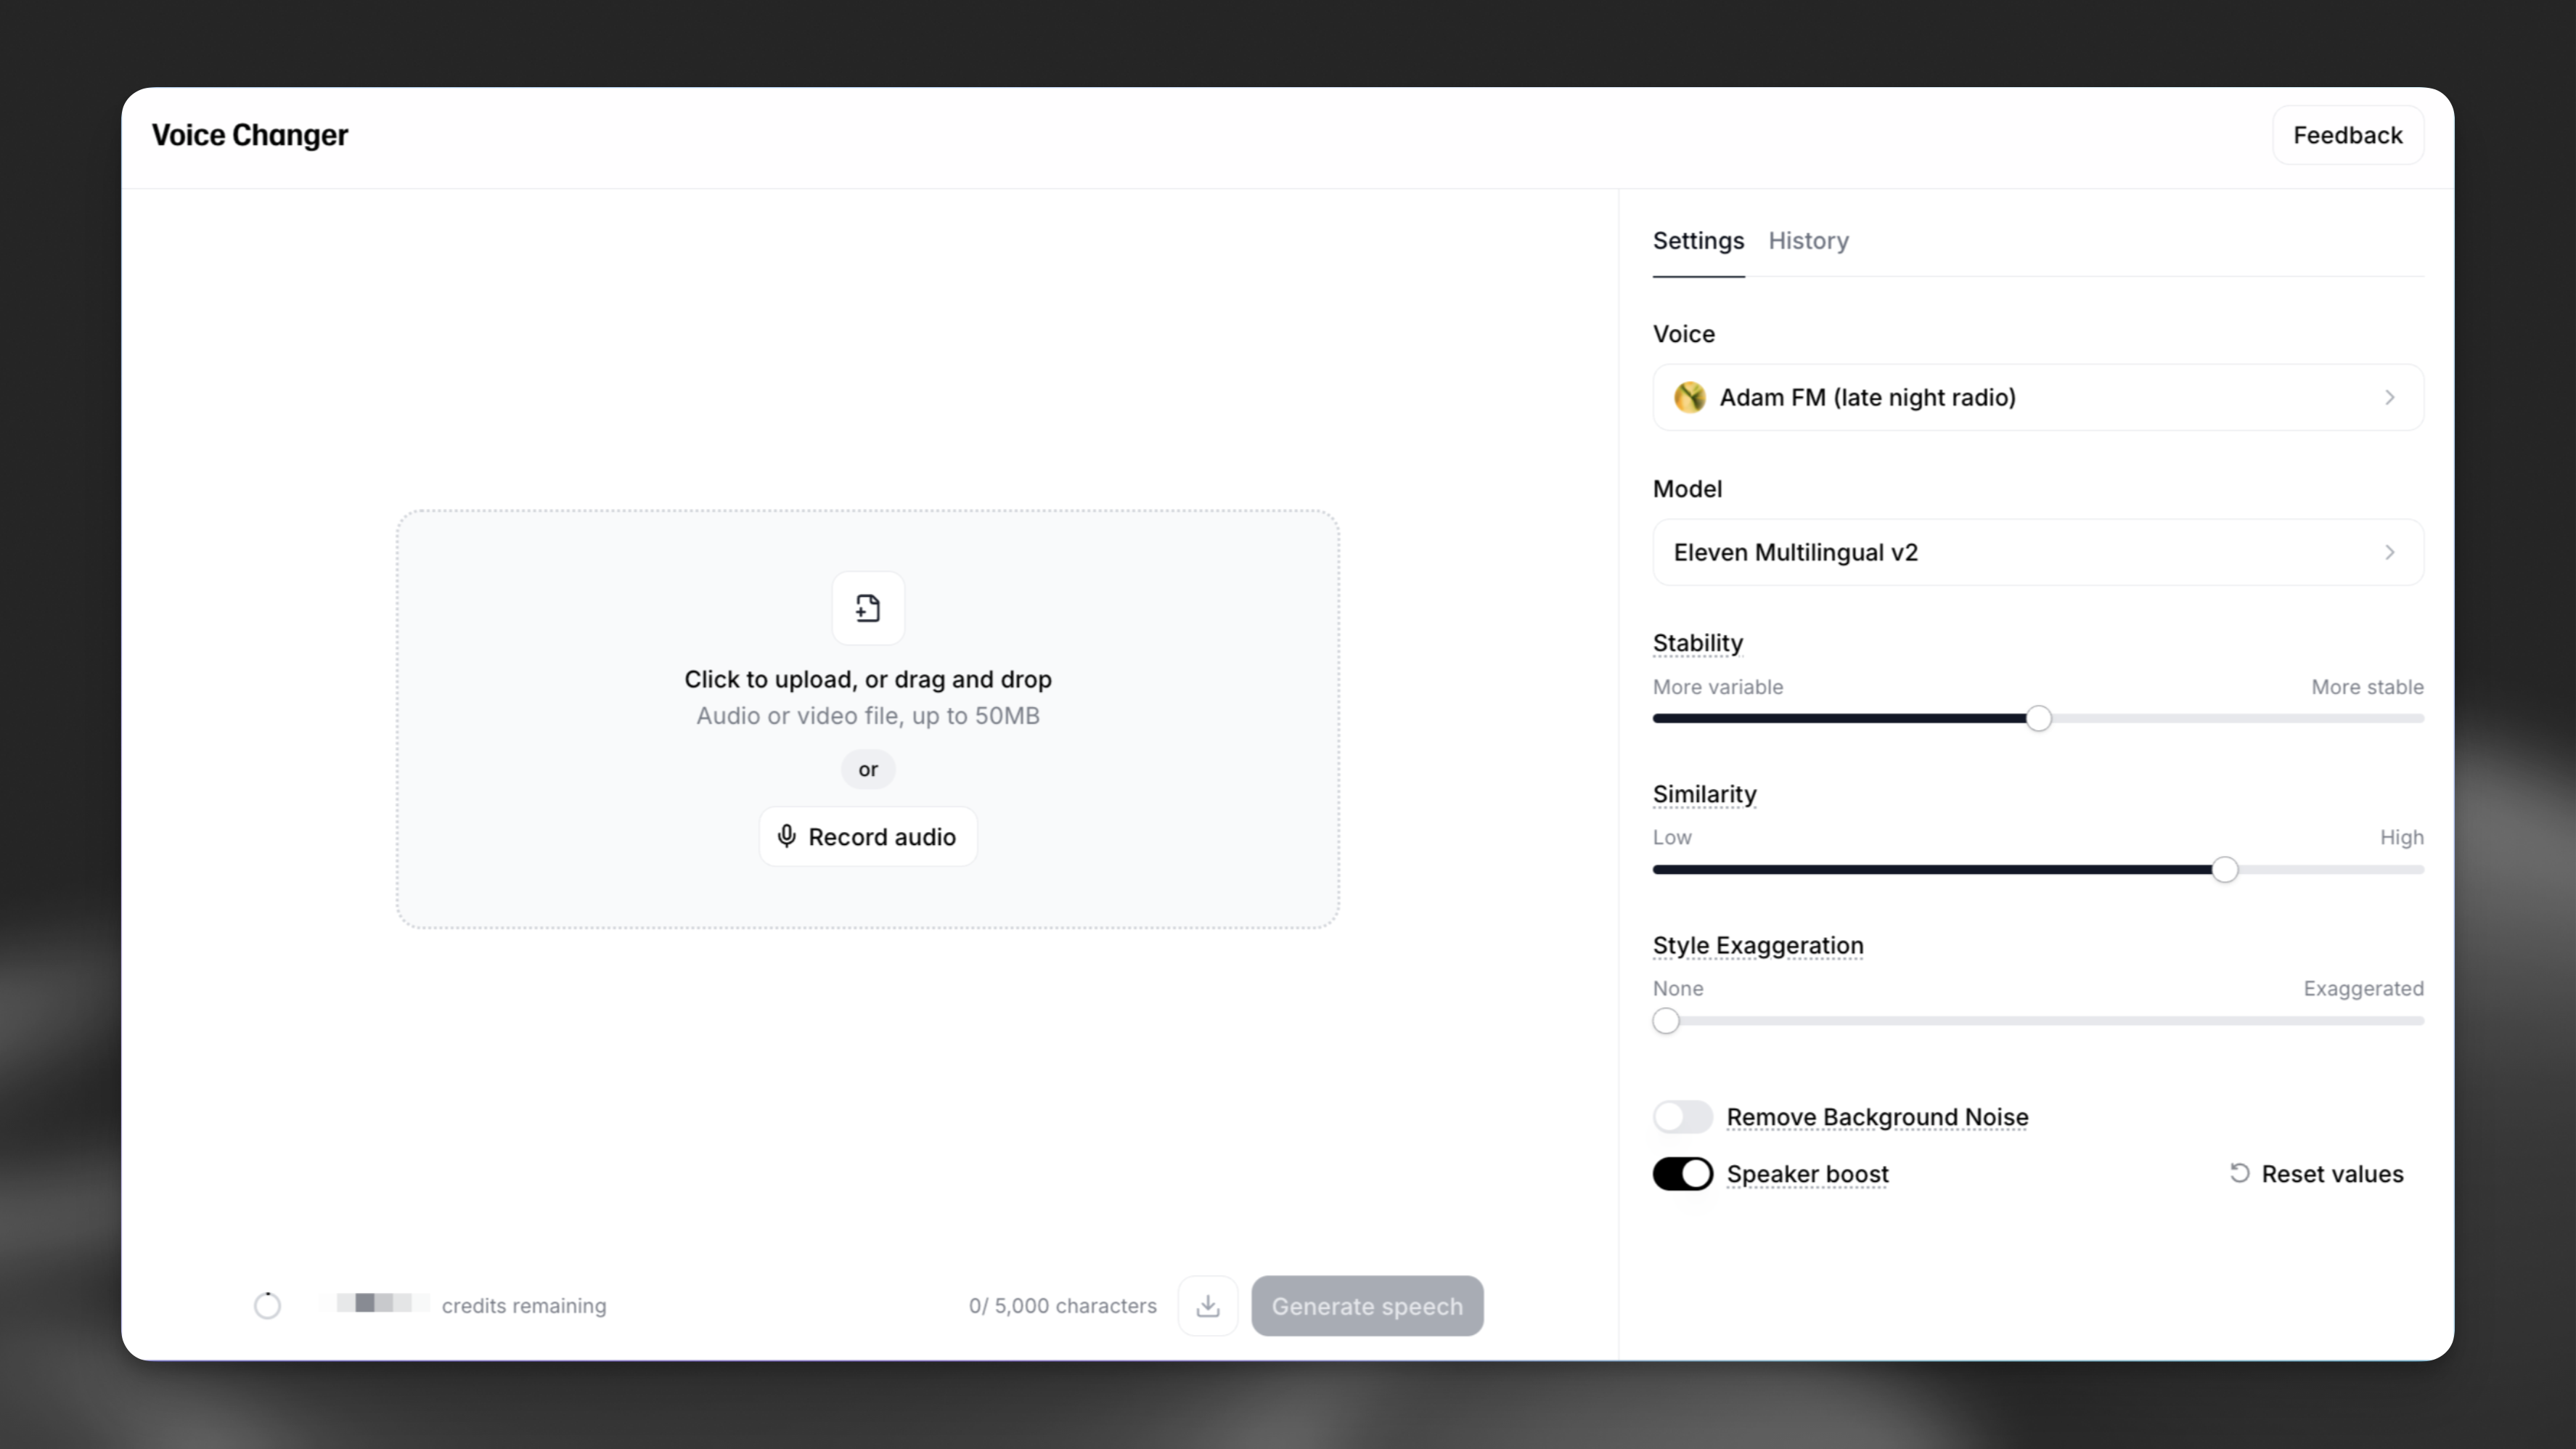
Sie können Audio direkt als Audiodatei hochladen oder live über ein Mikrofon aufnehmen. Die Audiodatei muss kleiner als 50 MB sein. Die Audiodatei oder Live-Aufnahme darf zudem 5 Minuten nicht überschreiten.
Bei Material mit mehr als 5 Minuten empfehlen wir, es in kleinere Abschnitte aufzuteilen und separat zu generieren. Wenn Ihre Datei zu groß ist, müssen Sie sie möglicherweise komprimieren oder in MP3 konvertieren.
Vorhandene Audiodatei
Um eine vorhandene Audiodatei hochzuladen, klicken Sie auf das Audiofeld oder ziehen Sie die Datei direkt darauf.
Live aufnehmen
Klicken Sie im Audiofeld auf Audio aufnehmen. Sobald Sie bereit sind, klicken Sie auf Mikrofon, um die Aufnahme zu starten. Klicken Sie nach Abschluss der Aufnahme auf Stopp.
Anschließend sehen Sie die Audiodatei dieser Aufnahme und können sie wiedergeben. So können Sie prüfen, ob Sie mit Ihrer Performance bzw. Aufnahme zufrieden sind. Die Zeichenkosten werden unten links angezeigt. Für Aufnahmen wird kein Kontingent berechnet – erst, wenn Sie „Generieren“ auswählen.
Die Kosten für eine Generierung mit dem Stimmenverzerrer richten sich ausschließlich nach der Dauer: 1.000 Zeichen pro Minute.
Einstellungen
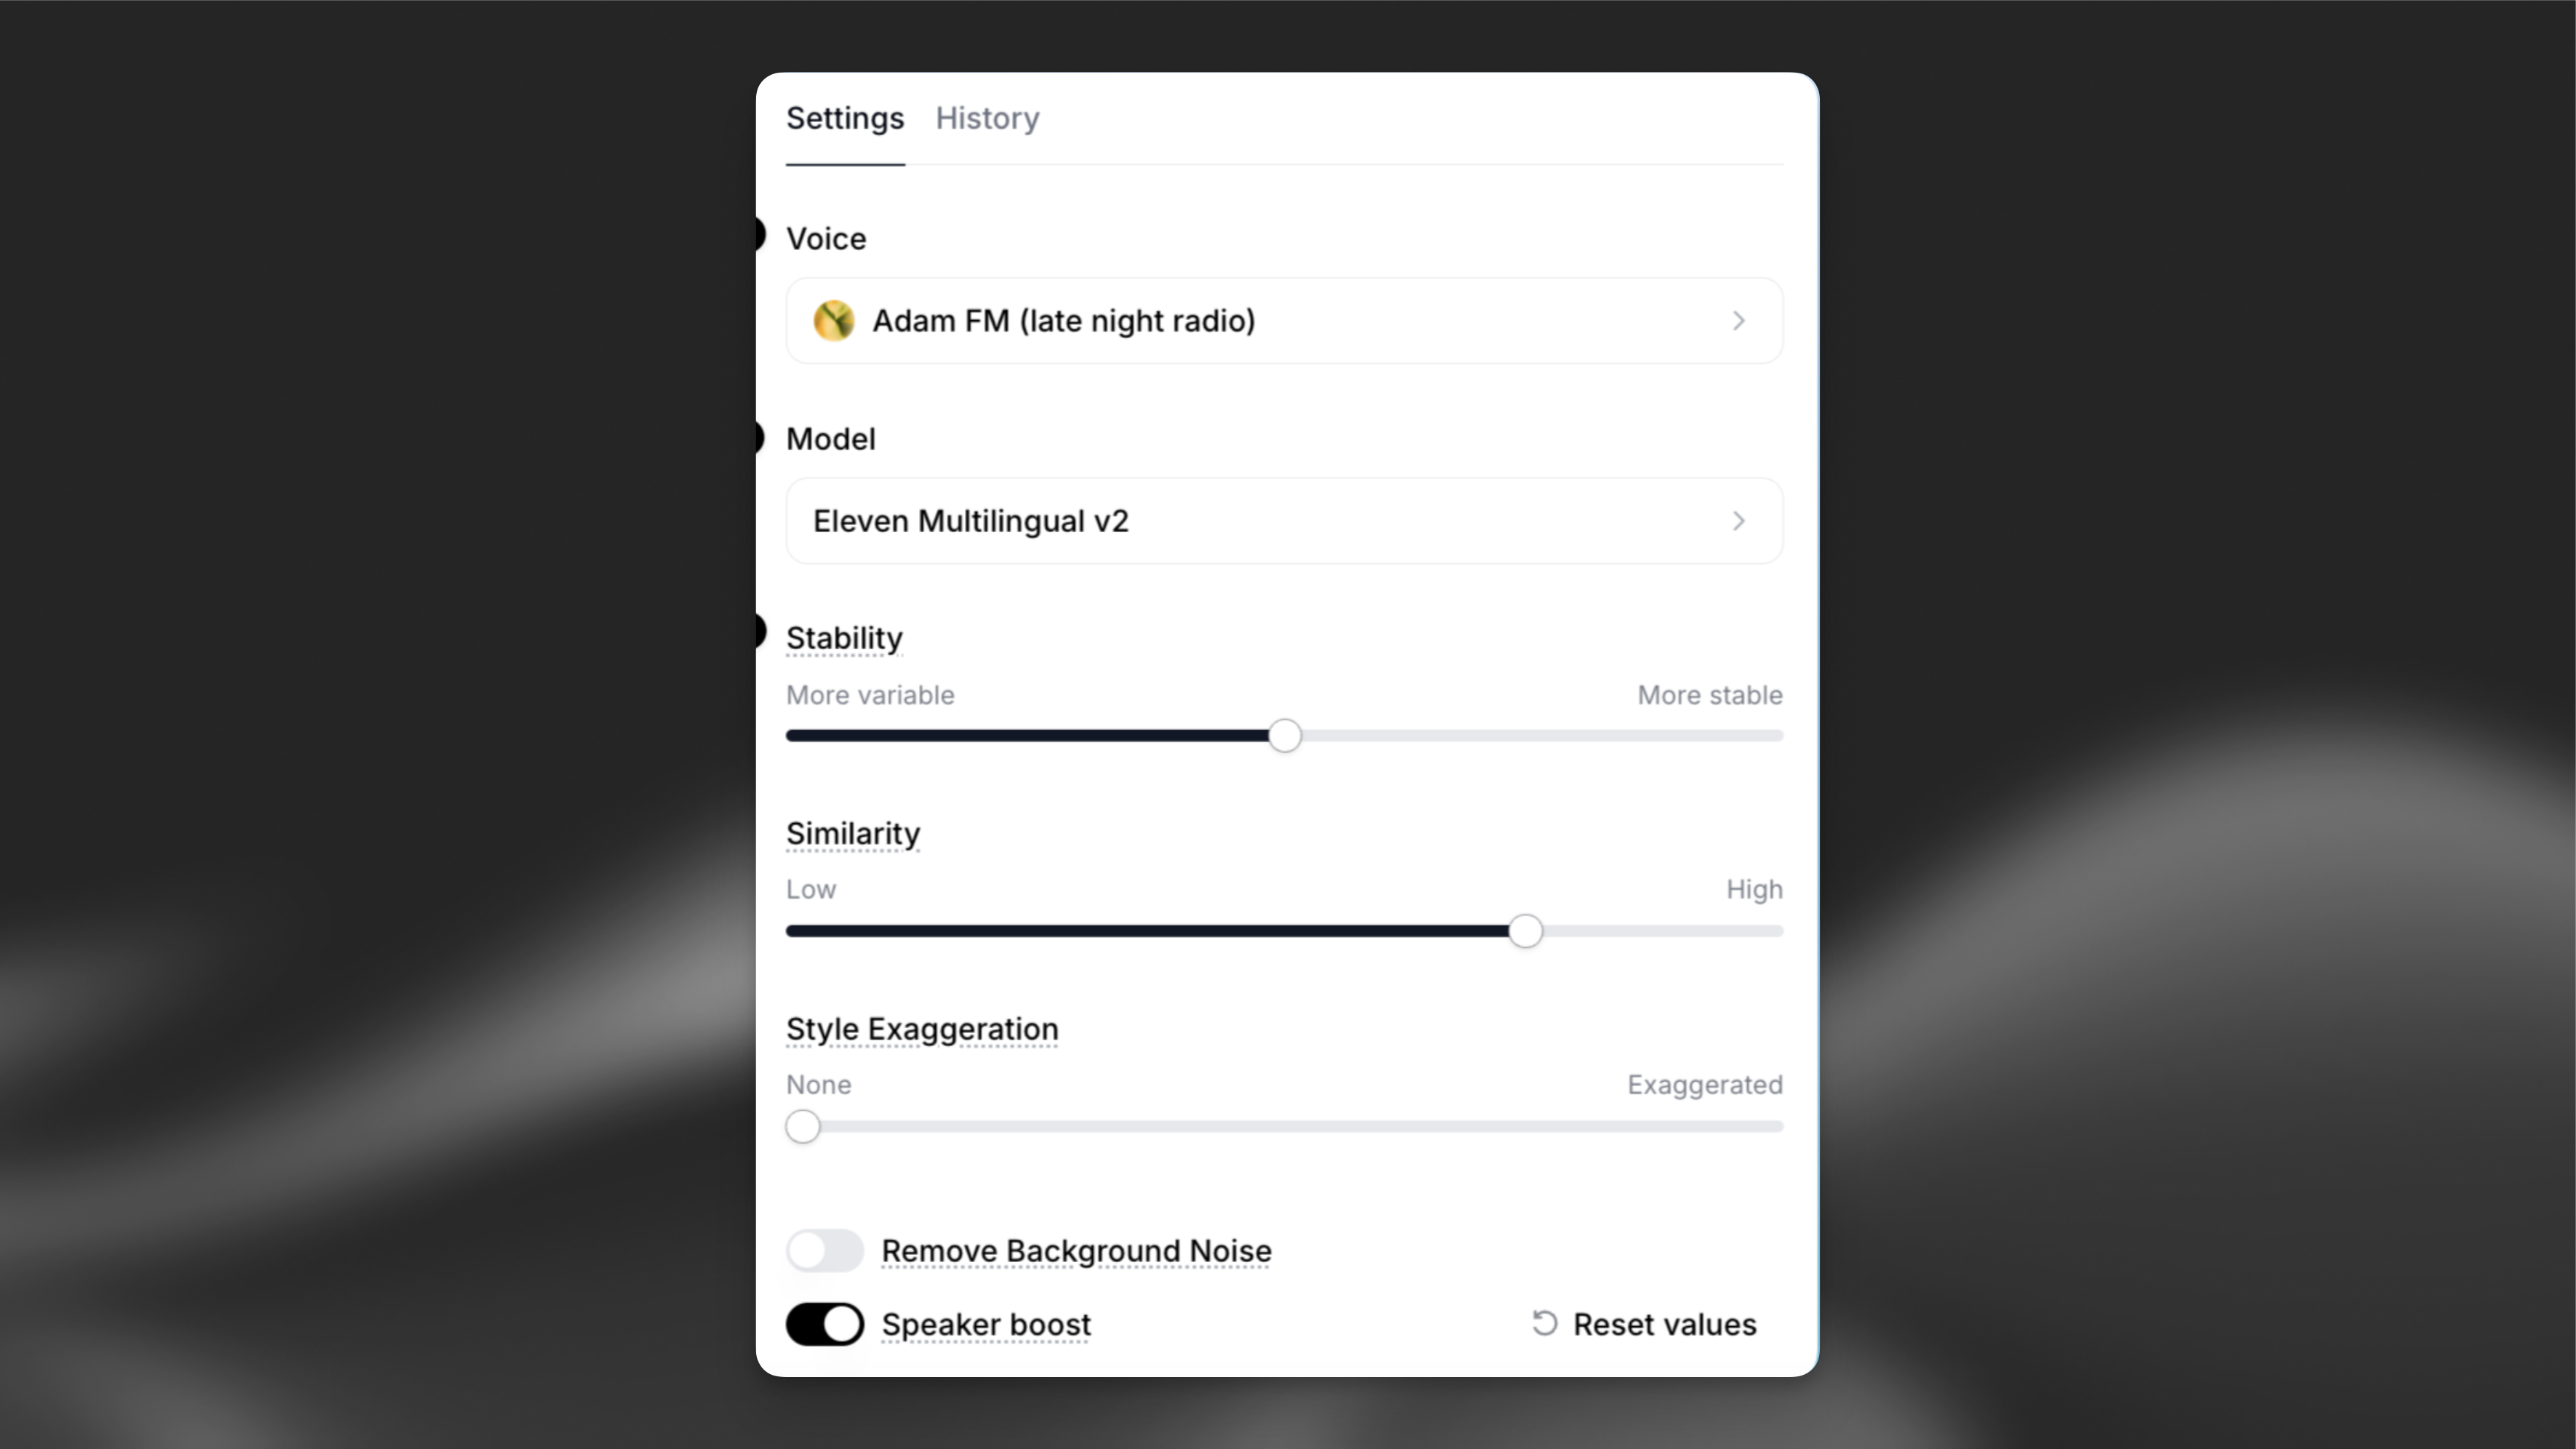
Erfahren Sie hier mehr über die verschiedenen Stimmeinstellungen.
Der Stimmenverzerrer bietet eine zusätzliche Einstellung, um Hintergrundgeräusche automatisch aus Ihrer Aufnahme zu entfernen.
Unterstützte Sprachen
eleven_english_sts_v2
Unsere mehrsprachigen v2-Modelle unterstützen 29 Sprachen:
Englisch (USA, UK, Australien, Kanada), Japanisch, Chinesisch, Deutsch, Hindi, Französisch (Frankreich, Kanada), Koreanisch, Portugiesisch (Brasilien, Portugal), Italienisch, Spanisch (Spanien, Mexiko), Indonesisch, Niederländisch, Türkisch, Filipino, Polnisch, Schwedisch, Bulgarisch, Rumänisch, Arabisch (Saudi-Arabien, VAE), Tschechisch, Griechisch, Finnisch, Kroatisch, Malaiisch, Slowakisch, Dänisch, Tamil, Ukrainisch & Russisch.
Das Modell eleven_english_sts_v2 unterstützt nur Englisch.
Best Practices
Der Stimmenverzerrer eignet sich besonders gut, um Akzente und natürliche Sprechrhythmen bei verschiedenen Ausgabestimmen beizubehalten. Wenn Sie beispielsweise ein Audiobeispiel mit portugiesischem Akzent hochladen, behält die Ausgabe diese Sprache und diesen Akzent bei. Das Eingabebeispiel ist entscheidend, da es die Eigenschaften der Ausgabe bestimmt. Wenn Sie eine britische Stimme wie „George“ auswählen, aber mit amerikanischem Akzent aufnehmen, ist das Ergebnis Georges Stimme mit amerikanischem Akzent.
- Ausdruck: Seien Sie in Ihren Aufnahmen ausdrucksstark. Ob Sie schreien, weinen oder lachen: Der Stimmenverzerrer gibt Ihre Performance präzise wieder. Dieses Tool verbessert den Realismus der KI und ermöglicht kreativen Ausdruck.
- Mikrofonverstärkung: Stellen Sie sicher, dass die Eingangsverstärkung angemessen ist. Eine zu leise Aufnahme kann die KI-Erkennung beeinträchtigen, während eine zu laute Aufnahme zu Audio-Clipping führen kann.
- Hintergrundgeräusche: Aktivieren Sie die Option Hintergrundgeräusche entfernen, um Hintergrundgeräusche automatisch aus Ihrer Aufnahme zu entfernen.