> This is a page from the ElevenLabs documentation. For a complete page index, fetch https://elevenlabs.io/docs/llms.txt. For the full documentation in a single file, fetch https://elevenlabs.io/docs/llms-full.txt.
# Guardrails
## Überblick
Guardrails geben Teams leistungsstarke Möglichkeiten, das Verhalten von Agenten in der Produktion zu steuern. Sie halten sie beim Thema, markenkonform und widerstandsfähig gegen Manipulation – auch im Unternehmensmaßstab.
Mit Guardrails 2.0 haben wir die Sicherheitsebene neu entwickelt. Teams können damit eigene Richtlinien einfacher in natürlicher Sprache definieren, vorgefertigte Schutzmechanismen aktivieren, festlegen, was bei Auslösung eines Guardrails geschieht, und Agenten zuverlässig für geschäftskritische Workflows bereitstellen.
Guardrails führen Agenten zu den richtigen Antworten und stoppen falsche Antworten, bevor sie Nutzer erreichen. Sie schützen Gespräche auf mehreren Ebenen: Sie steuern die Antworten des Agenten, prüfen Nutzereingaben und bewerten jede Antwort unabhängig ohne zusätzliche Latenz. So sinkt das Marken- und Compliance-Risiko in jedem Gespräch.
## So funktionieren Guardrails
Guardrails schützen Gespräche auf drei Ebenen:
**Absicherung des System Prompts:** Die wichtigste Methode zur Steuerung des Agentenverhaltens. Ergänzen Sie den System Prompt um klare Vorgaben zu erlaubtem und verbotenem Verhalten und aktivieren Sie den Focus Guardrail, um diese Anweisungen während des gesamten Gesprächs zu verstärken. So bleibt Ihr Agent in den meisten Interaktionen auf Kurs.
**Validierung von Nutzereingaben:** Ein Sicherheitsnetz, das gegnerische Versuche abfängt, bevor der Agent überhaupt antwortet. Guardrails analysieren Nutzereingaben, erkennen Prompt-Injection- und Manipulationsversuche und können Gespräche beenden, die ein Sicherheitsrisiko darstellen.
**Validierung von Agentenantworten:** Eine abschließende Prüfung, die jede Agentenantwort in Echtzeit unabhängig anhand Ihrer konfigurierten Richtlinien bewertet. Wenn der Agent trotz seines System Prompts etwas sagen will, das gegen Ihre Regeln verstößt, blockieren Antwortvalidatoren dies vor der Auslieferung.
Die Absicherung des System Prompts bildet die Grundlage. Die Eingabe- und Antwortvalidierung korrigieren alles, was durch diese Grundlage fällt. Nehmen Sie Ihre wichtigsten Regeln sowohl in den System Prompt als auch als unabhängigen benutzerdefinierten Guardrail auf. So entsteht eine mehrschichtige Verteidigung: Selbst wenn das LLM von seinen Anweisungen abweicht, fängt der Antwortvalidator dies vor der Auslieferung ab.
| Guardrail | Funktion | Schutz | Einfluss auf die Latenz | Kosten | Exit-Strategie | Release-Status |
| ------------ | ------------------------------------------------------------- | -------------------------------- | ------------------------------------------------ | --------------- | -------------------- | -------------- |
| Focus | Hält Agenten beim Thema und im Einklang mit dem System Prompt | Absicherung des System Prompts | Minimal | Inbegriffen | Nicht zutreffend | GA |
| Manipulation | Erkennt und blockiert Prompt Injection | Validierung von Nutzereingaben | Keine Auswirkung | Inbegriffen | Beendet das Gespräch | GA |
| Content | Kennzeichnet und verhindert unangemessene Inhalte | Validierung von Agentenantworten | [Abhängig vom Ausführungsmodus](#execution-mode) | Inbegriffen | Konfigurierbar | Alpha |
| Custom | Setzt Ihre unternehmensspezifischen Richtlinien durch | Validierung von Agentenantworten | [Abhängig vom Ausführungsmodus](#execution-mode) | Nutzungsbasiert | Konfigurierbar | Alpha |
## Absicherung des System Prompts
Der effektivste Weg, damit sich Ihr Agent wie vorgesehen verhält, ist ein guter System Prompt in Kombination mit dem Focus Guardrail. Zusammen führen sie Agenten von Beginn an zu den richtigen Antworten.
Mit dem System Prompt können Sie klare Anweisungen dazu geben, was Ihr Agent tun soll und was nicht. Modelle sind darauf abgestimmt, der Überschrift `# Guardrails` besondere Aufmerksamkeit zu schenken. Verwenden Sie diese Überschrift für Ihre wichtigsten Verhaltensregeln.
**`Beispiel: Absicherung des System Prompts`**
```mdx title="Beispiel: Absicherung des System Prompts"
# Guardrails
- Only provide information that is publicly documented about ElevenLabs products, pricing, and features.
- Do not speculate about unreleased features, internal roadmaps, or future pricing changes.
- If you cannot resolve an issue with available documentation or tools, clearly explain the limitation and offer to escalate to a human support representative.
```
Eine umfassende Anleitung zum Schreiben effektiver System Prompts finden Sie in unserem [Prompting-Leitfaden](/docs/de/eleven-agents/best-practices/prompting-guide). Ihr ElevenLabs-Account-Team unterstützt Sie auch beim Erstellen hochwertiger System Prompts.
**Focus Guardrail:** Der Focus Guardrail verstärkt den System Prompt Ihres Agenten. Er hilft, Antworten zielgerichtet, relevant und im Einklang mit Ihren definierten Zielen und Anweisungen zu halten. Das ist besonders bei langen oder komplexen Gesprächen hilfreich, in denen der Agent eher von seinen vorgesehenen Zielen abweichen kann.
Die Kombination aus der Absicherung des System Prompts und der Aktivierung des Focus Guardrails ist der effektivste Weg, Agenten zu den richtigen Antworten zu führen.
## Validierung von Nutzereingaben
### Manipulation Guardrails
Erkennt und blockiert Versuche von Nutzern, den Agenten zur Umgehung seiner Anweisungen zu manipulieren. Wenn diese Funktion aktiviert ist, analysiert das System Nutzereingaben auf Muster, die auf Injektions- oder Anweisungsüberschreibungsversuche hinweisen, und kann Gespräche beenden, die ein Sicherheitsrisiko darstellen.
## Validierung von Agentenantworten
### Content Guardrails
Kennzeichnet und verhindert unangemessene Inhalte in Agentenantworten, etwa politisch sensible, sexuell explizite oder gewalttätige Inhalte, bevor sie Nutzer erreichen. So bleiben Antworten für den vorgesehenen Anwendungsfall und die Zielgruppe Ihres Agenten angemessen.
### Benutzerdefinierte Guardrails
Wenn Agenten geschäftskritische Aufgaben übernehmen, benötigen Teams klare Kontrolle über ihr Verhalten. Mit benutzerdefinierten Guardrails können Sie die wichtigsten Richtlinien für Ihr Unternehmen konfigurieren. Zum Beispiel:
* Ein Handelsassistent sollte keine Rückerstattungen für nicht berechtigte Artikel gewähren.
* Ein Empfangsmitarbeiter im Gesundheitswesen sollte keine medizinischen Ratschläge geben.
* Ein Banken-Agent sollte keine Anlageempfehlungen geben.
Benutzerdefinierte Guardrails sind LLM-basierte Regeln, mit denen Sie eigene Blockierungskriterien über Prompts in natürlicher Sprache definieren können. Jeder aktivierte benutzerdefinierte Guardrail sendet Agentenantworten an ein schlankes Modell, das sie anhand Ihrer Regel bewertet und eine Entscheidung zum Blockieren oder Zulassen zurückgibt. Das gibt Ihnen flexible, domänenspezifische Kontrolle darüber, was Ihr Agent sagen darf und was nicht.
Für jeden benutzerdefinierten Guardrail können Sie Folgendes definieren:
| Feld | Beschreibung |
| ---------------------------------- | ----------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------- |
| **Name** | Eine aussagekräftige Bezeichnung für den Guardrail (z. B. "Keine Finanzberatung"). |
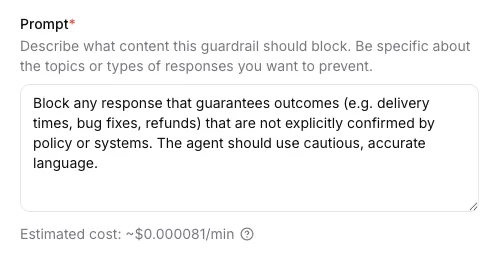
| **Prompt** | Eine Anweisung in natürlicher Sprache, die beschreibt, was blockiert werden soll (z. B. "Blockiere alle Inhalte mit konkreter Finanzberatung, Anlageempfehlungen oder Steuerhinweisen."). |
| **Ausführungsmodus** | `streaming` (Standard) oder `blocking`. Siehe [Ausführungsmodus](#execution-mode). |
| **Auslöseaktion (Exit-Strategie)** | `end_call` (Standard) oder `retry`. Siehe [Exit-Strategien](#exit-strategies). |
Mit benutzerdefinierten Guardrails können Sie für Ihr Unternehmen relevante Themen blockieren, branchenspezifische Compliance-Anforderungen durchsetzen und eigene Sicherheitsmaßnahmen umsetzen. Jeder Guardrail kann einzeln ein- oder ausgeschaltet werden, ohne ihn zu löschen. Wenn mehrere aktiviert sind, werden sie parallel zu anderen Guardrails ausgeführt. Alle ausgelösten Verstöße werden zur Überprüfung protokolliert.
## Ausführungsmodus
Der Ausführungsmodus bestimmt, ob Guardrails Wartezeit hinzufügen, bevor der Nutzer eine Antwort sieht oder hört.
Im **Streaming**-Modus kann die Agentenantwort beginnen, bevor der Guardrail ausgelöst wird. Bei Sprache kann ein kleiner Teil des Audios (oft weniger als 500 ms) ausgegeben werden, bevor eine Blockierung den Anruf beendet. Bei Text-Agenten können Nutzer teilweise oder vollständige Antworten sehen, wenn die Bewertung nicht vor der Auslieferung abgeschlossen ist.
Im **Blocking**-Modus antwortet der Agent erst, nachdem die Guardrails validiert wurden. Das fügt in der Regel **200–500 ms** zusätzliche Latenz hinzu.
## Exit-Strategien
Mit Exit-Strategien definieren Sie, was Ihr Agent tut, wenn ein Guardrail ausgelöst wird. Sie können wählen zwischen:
* **`end_call`** *(Standard)*: beendet den Anruf sofort
* **`retry`**: generiert die Antwort mit Ihrem Feedback neu, statt das Gespräch abzubrechen. Die Agentenantwort wird bis zu dreimal erneut versucht. Wenn jeder Versuch weiterhin gegen den Guardrail verstößt, wird der Anruf beendet.
> **Warning**
>
> Retry funktioniert nur im Blocking-Modus. Im Streaming-Modus ist das Beenden des Anrufs die einzige verfügbare Exit-
> Strategie.
#### Feedback für Retry
**Retry**-Feedback kann **beliebige Anweisungen** enthalten, die im nächsten Zug angewendet werden sollen – es wird als Systemanweisung eingefügt, bevor das Modell erneut generiert. Dazu gehört auch der Aufruf von Systemtools wie `transfer_to_agent` oder `transfer_to_number`. Hier sind einige Beispiele für die Konfiguration von Retry-Feedback:
* **Allgemeine Ablehnung** (Standard) \
*Ihre Antwort wurde von einem Guardrail blockiert, der Inhalte blockiert, die dieser Bedingung/Kategorie entsprechen: '\{\{trigger_reason}}'. In Ihrem nächsten Zug müssen Sie dem Nutzer sagen: "Es tut mir leid, aber ich kann diese Frage nicht beantworten. Möchten Sie etwas anderes wissen?"*
* **Retry mit korrigierenden Anweisungen**\
*Ihre vorherige Antwort wurde von einem Guardrail blockiert. Ihre blockierte Antwort war: '\{\{agent_message}}'. In Ihrem nächsten Zug müssen Sie eine neue Antwort geben, die nicht gegen Folgendes verstößt: '\{\{trigger_reason}}'.*
* **An einen anderen Agenten weiterleiten**\
*Ihre vorherige Antwort wurde vom Guardrail blockiert. In Ihrem nächsten Zug müssen Sie das Tool transfer_to_agent verwenden und an einen Agenten weiterleiten. Ihre blockierte Antwort war: '\{\{agent_message}}'. Der Guardrail blockiert Inhalte, die dieser Bedingung/Kategorie entsprechen: '\{\{trigger_reason}}'.*
* **An eine Person weiterleiten**\
*Ihre Antwort wurde von einem Guardrail blockiert, der Inhalte blockiert, die dieser Bedingung/Kategorie entsprechen: '\{\{trigger_reason}}'. In Ihrem nächsten Zug MÜSSEN Sie den Anruf mit dem Tool transfer_to_number an einen menschlichen Mitarbeiter weiterleiten.*
> **Tip**
>
> Um **Systemtools** im Retry-Feedback zu verwenden, aktivieren und konfigurieren Sie die entsprechenden Tools in den
> Agenteneinstellungen. Es können nur Tools aufgerufen werden, die für den Agenten eingerichtet sind.
Sie können diese Platzhalter im Feedbacktext verwenden:
| Platzhalter | Ersetzt durch |
| -------------------- | ----------------------------------------------------------------------------------------------------------------------------------------------------------------------- |
| `{{trigger_reason}}` | Den **Prompt** des Guardrails, wenn er in benutzerdefinierten Guardrails definiert wurde. Die ausgelöste **Kategorie**, wenn sie in Content Guardrails definiert wurde. |
| `{{agent_message}}` | Die blockierte Agentenausgabe (nützlich, um den Retry zu steuern). |
> **Tip**
>
> Der **Streaming**-Ausführungsmodus wird für **Sprach**-Agenten empfohlen. Der **Blocking**-Ausführungsmodus wird
> für **Text**-Agenten empfohlen.
> **Warning**
>
> **Blocking** (insbesondere mit **retry**) kann sich bei Sprache weniger vorhersehbar verhalten. Wenn Sie Blocking
> bei Sprache verwenden, testen Sie gründlich oder wählen Sie **end call** statt **retry**, bis Sie sich
> auf das Verhalten verlassen können.
## Preise
Die Guardrails **Focus**, **Manipulation** und **Content** sind für alle ElevenAgents-Nutzer **ohne zusätzliche Kosten** enthalten.
**Benutzerdefinierte Guardrails** sind nutzungsbasiert und **verursachen zusätzliche LLM-Kosten**, ähnlich wie andere Modellaufrufe in ElevenAgents. Jeder aktivierte benutzerdefinierte Guardrail sendet jede Agentenantwort zur Bewertung an ein schlankes Modell. Die Kosten hängen daher von der Länge des Prompts, der Länge des durchschnittlichen Gesprächs und dem Gesprächsvolumen ab. Wenn Sie mehrere benutzerdefinierte Guardrails aktivieren, führt jeder eine eigene Bewertung pro Antwort aus. Prüfen Sie Ihr erwartetes Aufkommen und die Modellauswahl, bevor Sie mehrere benutzerdefinierte Guardrails in der Produktion aktivieren.
Beim Erstellen oder Bearbeiten eines benutzerdefinierten Guardrails sehen Sie unter dem Prompt eine Kostenschätzung.
> **Note**
>
> **Retry und Kosten:** Jeder Versuch ist eine zusätzliche Agentengenerierung plus eine weitere Guardrail-Bewertung.
> Daher erhöht **retry** die nutzungsbasierte Abrechnung gegenüber **end_call** (bis zu drei Versuche pro
> blockiertem Zug).
## Konfiguration
#### Über das Dashboard konfigurieren
#### Zu den Agenteneinstellungen navigieren
Öffnen Sie Ihren Agenten im ElevenLabs-Dashboard und wechseln Sie zum Tab **Security**.
#### Guardrails aktivieren
Aktivieren Sie die Guardrail-Kategorien, die Sie verwenden möchten. Mit den Schaltflächen für Voreinstellungen können Sie schnell
alle Kategorien aktivieren oder deaktivieren.
#### Ausführungsmodus und Exit-Strategie konfigurieren (benutzerdefinierte und Content Guardrails)
Wählen Sie für jeden benutzerdefinierten oder Content Guardrail den Ausführungsmodus **streaming** oder **blocking**.
**Blocking** eignet sich für **Text**-Agenten, **streaming** für **Sprach**-Agenten. Legen Sie **Aktion bei
Guardrail-Verstoß** fest (entspricht **`trigger_action`**): **Anruf beenden** in jedem Modus oder **retry**
nur bei Auswahl von **blocking** (**retry** ist bei **streaming** nicht verfügbar). Wenn Sie **retry** wählen,
bearbeiten Sie **Beim Retry einzufügendes Feedback**, um das Modell zu steuern. Verwenden Sie die Platzhalter